原文:Building Effective AI Coding Agents for the Terminal: Scaffolding, Harness, Context Engineering, and Lessons Learned 作者:Nghi D. Q. Bui 等 · 发表:2026-03
导读:据作者所述,这是首个针对开源、终端原生、交互式编码代理的全面技术报告(系统 OpenDev,Rust 实现)。核心结论:有效的终端代理是一个复合 AI 系统——按工作流绑定多模型、把规划与执行分离到子代理 schema 层实现安全、用五阶段自适应上下文压缩与事件驱动系统提醒对抗上下文膨胀和指令消退,观察类上下文的峰值消耗降低约 54%。适合构建编码代理、CLI 工具或长时程 agent 系统的工程师与研究者阅读。
摘要
AI 编码辅助的版图正在经历一场根本性转变:从复杂的 IDE 插件走向功能多样、终端原生的代理。CLI 代理直接运行在开发者管理源码控制、执行构建和部署环境的地方,为长周期开发任务提供了前所未有的自主性。本文提出 OpenDev——一个用 Rust 编写、专门为这一新范式打造的开源命令行编码代理。有效的自主辅助要求严格的安全控制和高度高效的上下文管理,以防止上下文膨胀和推理退化。OpenDev 通过复合 AI 系统架构 [103] 应对这些挑战:面向工作负载的专用模型路由、将规划与执行分离的双代理架构、惰性工具发现,以及渐进收缩旧观察记录的自适应上下文压缩。此外,它还采用自动化记忆系统在多个会话间积累项目专属知识,并通过事件驱动的系统提醒对抗指令消退。通过强制显式推理阶段并优先保证上下文效率,OpenDev 为终端优先的 AI 辅助提供了一个安全、可扩展的基础,为稳健的自主软件工程提供了一份蓝图。
1 引言
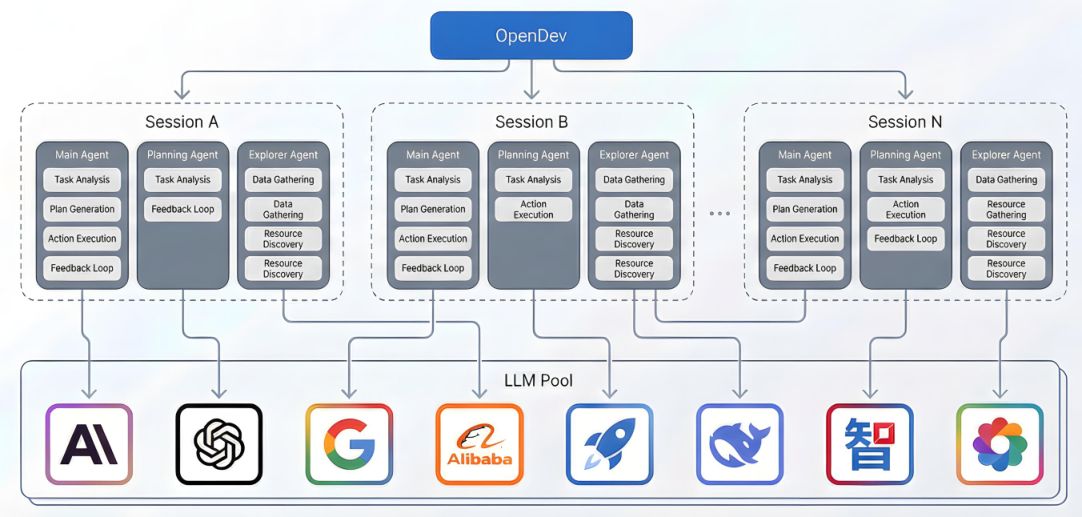
大语言模型(LLM)的快速进步催生了软件开发的新范式:以自主代理形态运作的 AI 编码助手 [95, 105, 99]。与只建议行内代码片段的传统补全工具不同,代理式(agentic)编码助手能够推理复杂任务、执行多步计划,并通过工具使用与开发环境交互。多篇综合调查记录了代码智能研究的爆发式增长 [47, 46],而 Agentic Software Engineering(代理式软件工程)的路线图 [35] 则形式化了人机协作的方法论原则。SWE-Agent [95]、OpenHands [84] 和 HyperAgent [69] 等系统已在标准化基准上展示了自主代理的潜力。商业影响同样巨大:GitHub Copilot 用户已超过 1500 万开发者 [30],AI 原生编辑器收入快速增长 [4],各大实验室纷纷推出自主编码代理 [18, 65]——这些都表明代理式编码已从研究原型走向产业部署。
过去几年,AI 编码助手紧耦合在 IDE 中,充当需要人持续监督的被动式副驾驶。近来,一场重大转变已经开始:从复杂的 IDE 插件转向更简单的命令行界面。Claude Code [2] 引领了这一转变,证明终端原生代理可以在真实软件工程任务中匹敌乃至超越 IDE 集成工具。终端是软件开发的运营中枢,原生支持源码控制、构建系统、远程 SSH 会话和无头服务器环境。Aider [28]、CodeAct [83] 和 Open Interpreter [63] 等早期系统证明了基于终端的 AI 结对编程与可执行代码动作的可行性。如今,每个主流 AI 实验室都提供 CLI 代理 [2, 32, 65],与之并行的还有 Goose [10]、OpenCode [19] 和 Crush [13] 等开源替代品。然而,实现这一潜力并非易事:Terminal-Bench [57] 和 LongCLI-Bench [25] 等基准表明,即使是前沿模型也难以胜任持续性的终端操作,凸显了专门工程方案的必要性。
这些基准结果指向任何长时间运行的终端代理都必须解决的三个根本性工程挑战:在经常超出模型 token 预算的会话中管理有限的上下文窗口;在代理可以执行任意 shell 命令时防止破坏性操作;以及在不撑爆代理提示预算的前提下扩展能力。我们把架构响应组织为两个阶段:脚手架(scaffolding)在首个提示到来之前组装代理(系统提示词、工具 schema、子代理注册表);harness(运行时编排层)则在运行时调度工具分发、上下文管理与安全强制 [102](第 2.2 节)。然而,终端原生的代理式工具的设计空间在很大程度上仍待探索:大多数生产系统闭源且架构决策未公开,而现有开源框架要么面向基准而非交互使用,要么缺少发表的技术报告 [56, 39]。三个关键的开放问题驱动了本工作:多模型架构应如何针对不同认知任务在成本、延迟与能力之间取得平衡?什么安全机制能在不损害开发者生产力的前提下防止破坏性操作?系统如何在有限的上下文限制内维持长时间运行的对话?
本文提出 OpenDev,一个面向软件工程的开放式 AI 命令行代理。据我们所知,这是首个针对开源、终端原生、交互式编码代理的全面技术报告。现有系统分属两类之一:面向基准的框架(如 SWE-Agent [95])发表了研究论文,但主要面向自动化评测而非日常交互使用;OpenHands [84] 既是生产级也有良好文档,但通过浏览器 UI 而非终端界面运作;CLI 原生代理(如 Aider [28]、Goose [10]、OpenCode [19]、Crush [13] 和 Gemini CLI [32])缺少记录设计决策的公开技术报告;Claude Code [2] 是 CLI 原生的,但既不开源也没有发表的技术报告。本文的目的不是提出新的算法突破,而是分享工程化一个生产可用的代理式编码系统的设计决策、权衡与经验教训,弥合闭源工业实践与开放学术论述之间的鸿沟。
OpenDev 的核心设计原则之一是它是一个复合 AI 系统 [103]:不是单一的单体 LLM,而是代理与工作流的结构化组合,每个都独立绑定一个用户配置的 LLM(第 2.2.5 节)。这一框架由 Zaharia 等人提出,其主张是:最先进的 AI 结果越来越多地由组合多个模型、检索器与工具的系统取得,而非依赖单次模型调用。OpenDev 将这一原则落地:其解耦架构使系统在构造上就与模型无关,而学习式模型路由 [62] 等技术可以在工作流层面应用。切换供应商或优化成本只需改配置,不需要改代码。因此系统的能力不是在部署时固定,而是随着更好的模型出现而持续可升级。
OpenDev 的设计遵循三项总体原则。第一,关注点分离:每个架构决策(模型选择、上下文管理、安全强制、工具分发)都应可独立配置、可替换,且不影响其他部分。第二,渐进退化:系统应在资源耗尽时优雅运作,无论是 token 预算、迭代次数还是网络连接。第三,透明优于魔法:每个系统动作(工具调用、安全否决、上下文压缩、记忆更新)都应可观察、可被开发者覆盖。这些原则体现为五项具体贡献:
基于复合架构的按工作流 LLM 可配置性。不同执行阶段对模型能力、延迟和成本的要求不同。我们提出按工作流绑定 LLM 的架构,每个认知工作流通过用户配置独立选择模型(第 2.2.5 节),其依据来自复合 AI 系统视角 [103] 与模型路由研究 [62]。
扩展的 ReAct 执行管线。我们在标准 ReAct 循环 [99] 之上扩展了显式思考与可选的自我批评阶段,将深思熟虑与行动分离(下文简称 ReAct 循环;第 2.2.6 节),并把分阶段上下文压缩直接集成进推理循环,借鉴了上下文工程研究的洞见 [56, 39]。
长时程上的行为导向。我们提出事件驱动的系统提醒:在长时间运行的会话中,于决策点注入针对性指引来对抗指令消退,而非仅依赖初始系统提示词(第 2.3.4 节)。一条条件化提示词组装管线从相互独立、按优先级排序的章节中组装代理指令,只在上下文相关时才加载,在保留完整指引的同时降低提示开销(第 2.3.1 节)。
token 高效的可扩展性与纵深防御安全。我们提出基于注册表的工具架构,通过 MCP [1] 惰性发现外部工具(第 2.4.7 节),以及一个五层安全架构,在逐层降低的抽象层级上强制约束:提示级护栏、通过双代理分离实现的 schema 级工具门控(第 2.2 节)、带持久权限的运行时审批系统、工具级校验,以及用户定义的生命周期钩子(第 2.1 节)。
上下文工程作为一等公民。我们把上下文管理当作一等工程关注点 [3, 56],提出自适应上下文压缩(第 2.3.6 节)、对抗注意力衰减的事件驱动系统提醒(第 2.3.4 节),以及积累项目专属知识的经验驱动记忆管线 [66, 106]。我们的压缩与记忆策略与近期上下文工程理论工作提出的熵减与最小充分性原则相一致 [39, 101]。
本文其余部分沿「构建—反思—上下文」的路径展开。第 2 节详述构建了什么:横跨代理推理、上下文工程、工具与持久化的四层系统架构。第 3 节检视学到了什么:迭代开发中浮现的五个横切设计张力及其可迁移的经验。第 4 节将这些决策置于更广阔的研究图景中,第 5 节指出未来方向。附录提供工具、提示词、配置 schema 与实现常量的参考级目录。
2 系统架构
2.1 概述
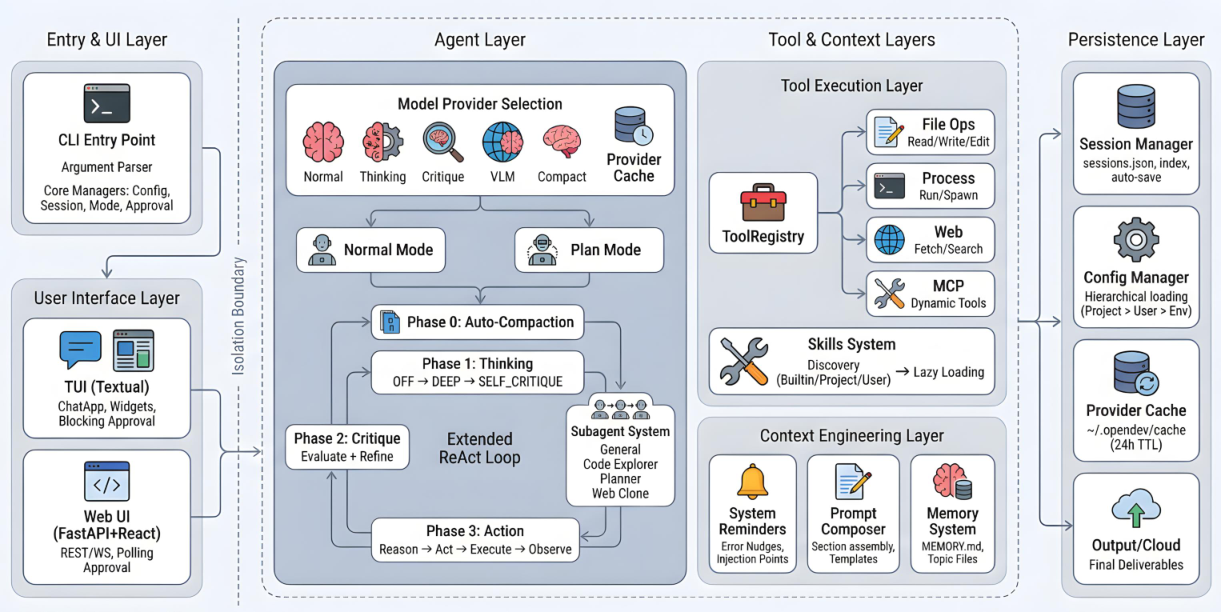
图 2 展示了 OpenDev 横跨四个主要层次的架构:Entry & UI(入口与界面)、Agent(代理)、Tool & Context(工具与上下文)与 Persistence(持久化)。一个用户查询沿此管线顺序流动:从入口点经过代理推理与工具执行,最终结果被持久化并渲染。
CLI 入口点解析参数并引导启动四个共享管理器(ConfigManager、SessionManager、ModeManager 和 ApprovalManager),它们被注入所有下游组件。OpenDev 支持两种前端:一个基于 Textual 构建的 TUI,使用阻塞式模态审批;一个由 FastAPI 和 WebSockets 支撑的 Web UI,使用异步轮询审批。两者实现共享的 UICallback 契约,保持代理层与 UI 无关。
OpenDev 将五个专门的模型角色分配给不同的 LLM(第 2.2.5 节),每个 LLM 惰性初始化,并以本地缓存的能力注册表为依据。系统以两种模式运作:普通模式(Normal Mode)对执行开放全部读写工具;规划模式(Plan Mode)则限定只读工具以安全规划(第 2.2 节)。推理经由扩展 ReAct 循环(第 2.2.6 节)进行,每轮运行四个阶段:token 预算接近耗尽时自动进行上下文压缩;一个可选的思考阶段以可配置深度进行行动前推理;一个可选的自我批评阶段;以及标准的 Reason-Act-Execute-Observe 行动阶段。
工具执行层围绕一个 ToolRegistry 构建,它把调用分发给覆盖文件操作、进程执行与 Web 访问的类型化处理器,支持批量并行执行与按需 MCP 工具发现(第 2.4.7 节)。Skills 系统从三层层级(内置、项目、用户)惰性注入可复用的领域专属提示词模板。上下文工程层通过四个子系统管理 LLM 上下文窗口:用于上下文感知行为指引的系统提醒(第 2.3.4 节)、用于模块化系统提示词组装的 Prompt Composer、用于跨会话延续的 Memory,以及用于回收 token 预算的 Compaction(第 2.3.6 节)。
OpenDev 将状态持久化到四个存储:一个 Config Manager 通过「项目本地—用户全局—环境变量—内置默认」的层级解析设置;一个 Session Manager 将完整对话历史保存为 JSON;一个 Provider Cache 在本地存储模型能力元数据;以及一个跟踪文件变更以支持回滚的操作日志。
由于代理可以执行任意 shell 命令、覆写文件并派生持久进程,单一安全机制是不够的。因此 OpenDev 采用纵深防御架构,配备五个相互独立的安全层(图 3),每层都被设计为独立阻止某一类伤害,从而不存在单点失效危及整个系统。
在建立四层总览之后,我们逐一深入检视每一层,首先从实现驱动所有代理行为的推理循环的代理核心开始。
2.2 代理核心层
代理层位于 UI 层与工具执行层之间(图 2)。其中心是唯一入口 MainAgent,它接收每个用户提示并决定如何处理。理解这一层需要两个视角:代理在第一个提示到来之前如何被组装(脚手架),以及组装好的代理在运行时如何处理用户消息(harness)。在此语境下,harness 是包裹核心推理循环的运行时编排层,围绕它协调工具执行、上下文管理、安全强制与会话持久化 [102]。如果说脚手架关心的是第一个提示之前如何构造代理,harness 关心的则是一切之后发生的事情:分发工具、压缩上下文、强制安全不变量、跨轮次持久化状态。下面各小节按顺序介绍这两个阶段,然后逐一详述各支撑组件。
2.2.1 代理脚手架
在代理能够处理用户提示之前,它必须被完整组装。OpenDev 中的每个代理都在对话生命周期开始之前完成构造(系统提示词编译完成、工具 schema 构建完成、子代理注册完成)(第 2.2.3 节)。理解这条构造管线就能明白,为什么运行时可以对所有代理一视同仁,无论其角色如何。
所有代理继承自 BaseAgent——一个抽象基类,接受三个构造参数(config、tool_registry、mode_manager)并定义四个抽象方法:build_system_prompt() 组装系统提示词字符串,build_tool_schemas() 返回 OpenAI 格式的工具 schema,call_llm() 执行单次 LLM 调用,run_sync() 运行完整的 ReAct 循环。关键的设计选择是急切构造:BaseAgent.init() 在构造器返回之前同时调用 build_system_prompt() 与 build_tool_schemas()。到 init() 完成时,代理已完全就绪可以服务请求,没有惰性提示组装,没有首次调用延迟。一个具体的 refresh_tools() 方法会在工具注册表变化时(例如 MCP 服务器发现之后或动态加载 skill 之后)重新调用这两个 build 方法。下游代码不直接依赖 BaseAgent,而是依赖 AgentInterface——一个要求相同表面(system_prompt、tool_schemas、refresh_tools、call_llm、run_sync)的 @runtime_checkable Protocol,从而将工厂与具体代理类解耦。
这里不存在代理类型的类层级。MainAgent 是 BaseAgent 唯一的具体子类,系统中的每个代理(主代理、所有内置子代理以及任何用户自定义代理)都是这一个类的实例。行为差异完全来自构造参数:allowed_tools(一个列表,过滤哪些工具 schema 出现在该代理的 schema 中,None 表示全量访问)、_subagent_system_prompt(构造后设置的覆盖提示词),以及由 allowed_tools 是否非空派生的 is_subagent 标志。在 init 内部,MainAgent 将四个 HTTP 客户端槽位设为 None 以便惰性初始化,分别对应 normal、thinking、critique 和 VLM 提供商,把 API key 校验推迟到首次 LLM 调用。它创建一个用于生成 schema 的 ToolSchemaBuilder(registry, allowed_tools),以及一个用于从 Web UI 线程安全注入消息的有限容量 Queue(maxsize=10)。这些惰性客户端槽位对应第 2.2.5 节描述的模型角色:每个槽位在首次访问时物化一个特定提供商的 HTTP 客户端,使代理可以在凭据配置好之前就被构造出来。
AgentFactory 是代理构造的唯一入口。TUI 与 Web UI 都调用同一个 create_agents() 方法,确保无论前端如何设置都完全一致。工厂按严格顺序执行三个阶段:
阶段 1(Skills)。工厂从三个目录(内置、用户全局、项目本地)发现 skill 定义,创建一个 SkillLoader 并将其注册到工具注册表,使 use_skill 工具变为可用。
阶段 2(Subagents)。工厂创建一个 SubAgentManager,调用 register_defaults() 编译内置子代理规格,再调用 _register_custom_agents() 从配置文件加载任何用户自定义代理。最后,它通过 set_subagent_manager() 将该管理器注册到工具注册表,使 spawn_subagent 工具变为可用。
阶段 3(Main agent)。工厂构造一个 MainAgent,不做任何工具过滤(可完整访问所有已注册工具,包括阶段 1 和阶段 2 中新增的工具)。
这一顺序约束至关重要:阶段 2 必须在阶段 3 之前完成,因为 spawn_subagent 的工具描述是由已注册代理集合动态构建的,它必须出现在主代理的 schema 中。工厂返回一个捆绑主代理、SubAgentManager 与 SkillLoader 的 AgentSuite 数据类。
每个子代理最初是一个 SubAgentSpec——一个 TypedDict,包含名称、描述、系统提示词、可选的工具白名单、可选的模型覆盖和可选的 Docker 配置。当 SubAgentManager.register_subagent(spec) 被调用时,它执行四步管线:(1) 解析工具列表,未指定时默认为一组硬编码的安全工具;(2) 若提供了模型覆盖,则创建一份带有覆盖的 AppConfig 副本;(3) 构造一个 allowed_tools 设为已解析列表的 MainAgent,触发过滤后的系统提示词与工具 schema 的急切构建;(4) 将 agent._subagent_system_prompt 设为规格中的提示词覆盖。结果存储为一个 CompiledSubAgent(名称、描述、代理实例、工具列表)。构造开销很小,因为所有子代理共享同一个工具注册表引用,没有克隆或深拷贝。运行时隔离来自两个机制:构建时的 schema 过滤(子代理永远看不到其白名单之外的工具)与执行时的 message_history=None(每次调用都以全新上下文开始,详见第 2.2.7 节)。
代理构造产出代理;运行时执行需要服务。AgentDependencies 是一个携带七个字段的 Pydantic 模型,供工具在执行时使用:mode_manager、approval_manager、undo_manager、session_manager、working_dir、console 和 config。REPL 或 Web UI 用全部管理器构造该对象并传给 agent.run_sync()。在 ReAct 循环内部(第 2.2.6 节),各个管理器从依赖对象中解包,作为关键字参数传给 execute_tool(),使工具注册表接口保持扁平:它不直接依赖 AgentDependencies 模型。子代理则收到一个只有三个字段的轻量 SubAgentDeps 数据类:mode_manager、approval_manager 和 undo_manager。被省略的字段构成一道隔离边界:子代理拿不到 session_manager(其消息不被持久化)、console(输出经 ui_callback 流转)和 config(每个子代理自带构造时的自身配置)。
三次设计转向塑造了当前的脚手架架构。第一,早期的类层级(规划代理、代码探索代理、Web 生成代理各有独立类)被单一参数化的 MainAgent 取代。当子代理需要混合能力时(例如一个同时会规划的 Web 生成器),类层级会造成菱形继承问题,而参数化方法将其彻底消除。第二,惰性提示构建(在首次 run_sync 调用时才构造系统提示词)被急切构建模式取代。惰性方案引入了用户可见的首次调用延迟,并与 MCP 服务器发现产生竞态:首次调用之后注册的工具直到手动刷新才会出现在提示词中。急切构建保证每个代理在构造时就已完整。第三,内联子代理定义(在主代理代码中硬编码代理构造)被 SubAgentSpec 注册系统取代。这次重构使配置文件中定义的自定义代理与内置代理走同一条编译路径,统一了两条代码路径。
2.2.2 代理运行时架构
脚手架完成后,组装好的代理已准备好处理用户消息。运行时行为由代理 harness 治理——即第 2.2 节引入的编排基础设施,它把一个无状态的 LLM 变成持久的、会使用工具的、能自我纠正的代理。图 4 绘出了这一 harness 架构:中心的 ReAct 执行循环,以及环绕其周、为它供给、约束它并持久化其工作的各子系统。
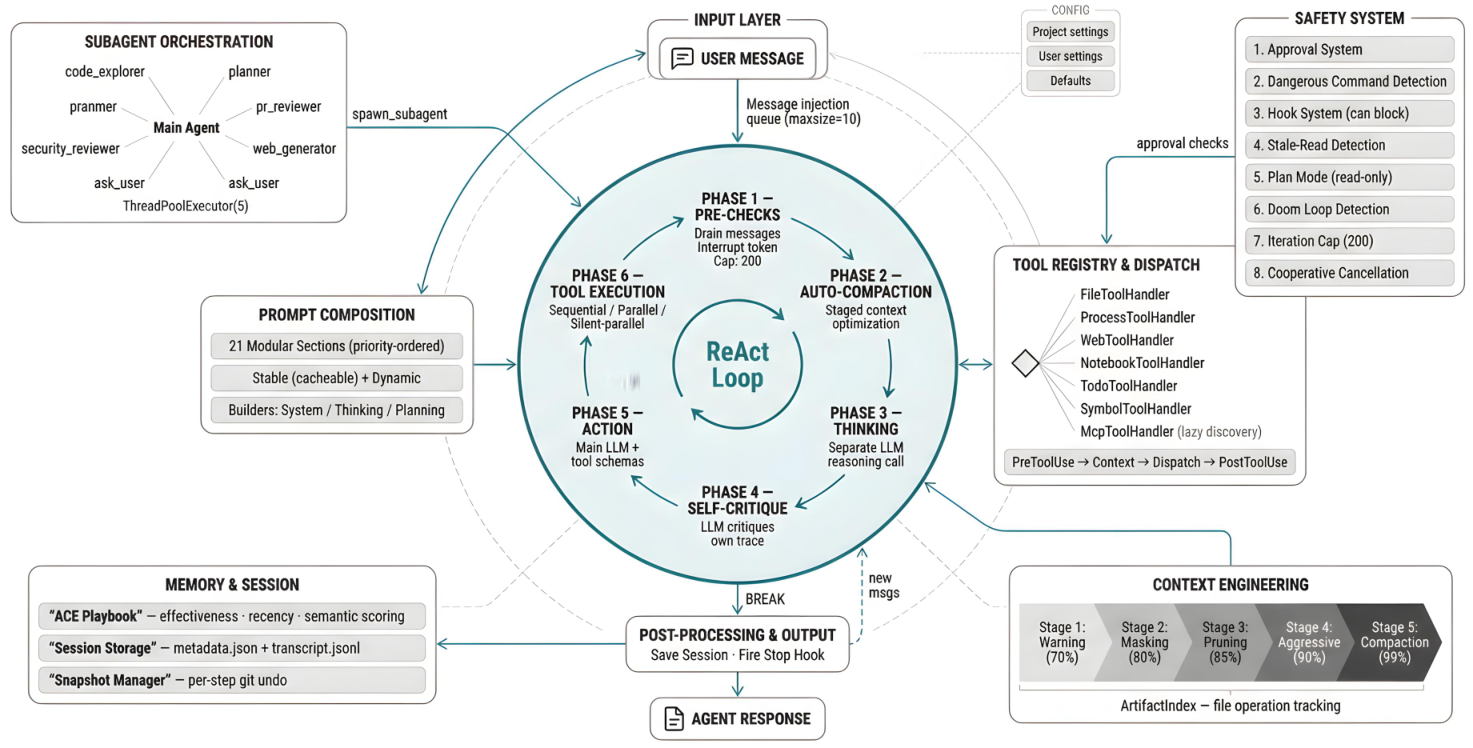
图 4 中心的 ReAct 循环每次迭代执行六个阶段:预检与压缩、思考、自我批评、行动、工具执行与后处理。每个阶段都是执行器管线中的一个独立阶段:预检排空已注入的消息并在内存压力下压缩,思考与自我批评产生可选的思维链轨迹,行动阶段携完整工具 schema 调用 LLM,工具执行经注册表分发调用并做审批检查,后处理决定继续迭代还是返回。循环不断重复,直到代理产出不含工具调用的最终文本响应,或到达安全上限。第 2.2.6 节详述各阶段算法与控制流。
在图 4 顶部,输入层通过线程安全的有限容量队列接收用户消息,使后续消息可以在代理执行中途到达。配置与设置随消息队列一并流入,为代理提供运行时参数(模型选择、审批级别、工作目录)。在底部,后处理路径在循环终止后承担三项职责:将更新后的对话持久化到会话存储、执行任何已注册的 Stop 钩子,以及把代理的最终响应返回给 UI 层渲染。
图 4 的外围展示了七个子系统,各自处理一个独立关注点并在专门小节详述。Prompt Composition 引擎(第 2.3.1 节)从模块化章节(身份、安全策略、工具指引、工作流规则与动态上下文)组装系统提示词,并拆分为可缓存与不可缓存段落以实现高效的 API 缓存。Tool Registry(第 2.4.1 节)将每次工具调用分发给专门处理器,MCP 工具在运行时惰性发现。Safety System(第 2.1 节)通过多个相互独立的层提供纵深防御,不单独依赖任何一层,每层捕获不同的失效模式。Context Engineering(第 2.3.6 节)把对话当作有限资源管理,随 token 使用增长实施逐级加重的压缩。Memory 与 Session 服务(第 2.5 节)同时持久化对话转录和一份基于反馈演进的经验策略 playbook。Subagent Orchestration(第 2.2.7 节)使主代理可以将专门任务(代码探索、安全审查、Web 生成)委托给隔离的代理实例——它们共享同一工具基础设施,但以过滤后的工具访问和独立的对话历史运作。
关键的架构决策是系统以两种不同模式运作——规划模式与普通模式,代理依据用户命令或提示触发在两者之间切换。图 5 展示了这一双模式流程。
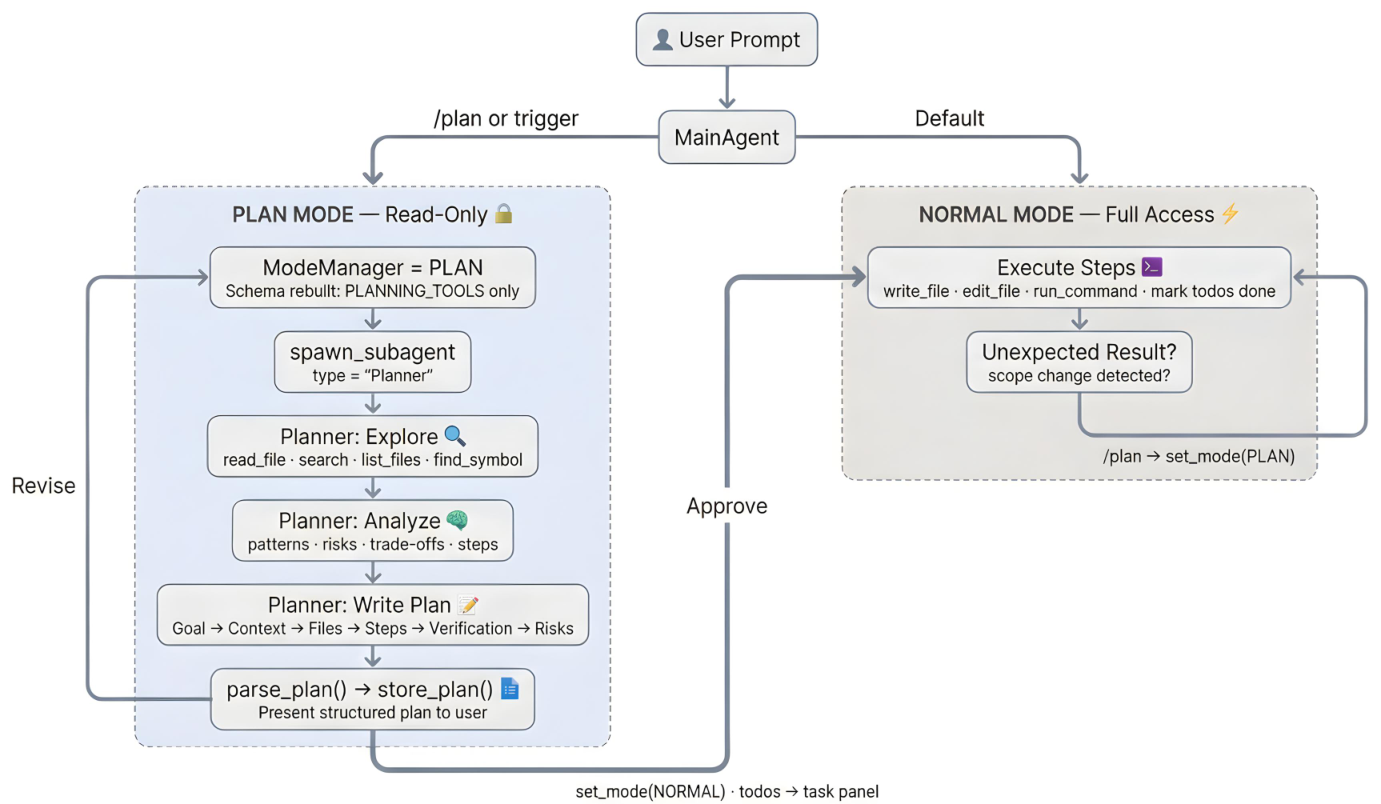
当用户提示到来时,MainAgent 判断应进入规划模式还是直接在普通模式下进行。两个触发器激活规划模式:用户显式的 /plan 命令,或一个检测提示中规划意图的启发式规则(例如要求「设计」「架构」或「规划」某项变更的请求)。所有其他提示默认在普通模式下进行。这个路由是每个提示一次性的决定;除非用户显式要求,代理不会在执行中途切换模式。
OpenDev 没有通过专门的规划管理工具把主代理切换进受限模式,而是把规划委托给一个一等公民的 Planner 子代理。需要规划时,主代理调用 spawn_subagent(type="Planner"),启动一个拥有只读工具和专门规划提示词的子代理。写操作被完全排除在子代理的工具 schema 之外:LLM 永远看不到它用不了的工具定义,从根上消除了规划期间尝试写入的可能。
Planner 子代理分三个阶段执行,见图 5。第一,它用只读工具探索代码库:读文件、搜代码、列目录内容、解析符号定义。第二,它分析发现结果:识别模式、评估风险、考量权衡、确定所需变更的顺序。第三,它把一份结构化计划写入草稿目录中的文件,包含七个部分:目标、上下文、要修改的文件、要新建的文件、实施步骤、验证标准与风险。
完成后,Planner 把计划文件路径返回给主代理。主代理随即调用 present_plan(plan_file_path),把计划展示给用户审阅。用户有两个选择:修改(主代理可携带反馈再次派生 Planner)或批准(代理转入普通模式执行)。这一设计消除了对独立模式管理器状态的需要:主代理全程处于普通模式,规划只是一次子代理委托。
普通模式是默认且唯一的运行状态。代理可完整访问所有工具,包括读文件、写文件、编辑代码、执行命令与派生子代理。计划经 present_plan 获批后,代理逐步执行计划步骤,用任务管理工具跟踪进度。
执行期间,如果代理遇到意外结果(例如测试失败暴露更深的问题、依赖冲突或范围变更),它可以携带当前代码库状态作为上下文再次派生 Planner 子代理,产出一份考虑到原计划获批以来变化的修订版计划。
最初的设计使用一个四工具状态机(enter_plan_mode、exit_plan_mode、create_plan、edit_plan)把主代理切进受限的规划状态。这很脆弱:代理有时未能退出规划模式,使系统卡在只读状态,需要人工干预。
当前设计彻底移除了这个状态机。规划被委托给一个 schema 中只含只读工具的 Planner 子代理,在 schema 层面而非运行时权限检查层面强制分离。Planner 不能写入,是因为写工具根本不存在于其 schema 中,而不是因为运行时检查拦截了尝试。这带来三个优势:(1) 没有状态机就没有卡在规划模式的风险;(2) Planner 可以与其他子代理并发派生(例如一个 Code Explorer 做并行分析);(3) 工具面从四个缩减到一个(present_plan),降低了 LLM 的认知负担。
2.2.3 对话生命周期
图 6 追踪一条用户消息在系统中从初始输入到最终会话持久化的端到端路径。
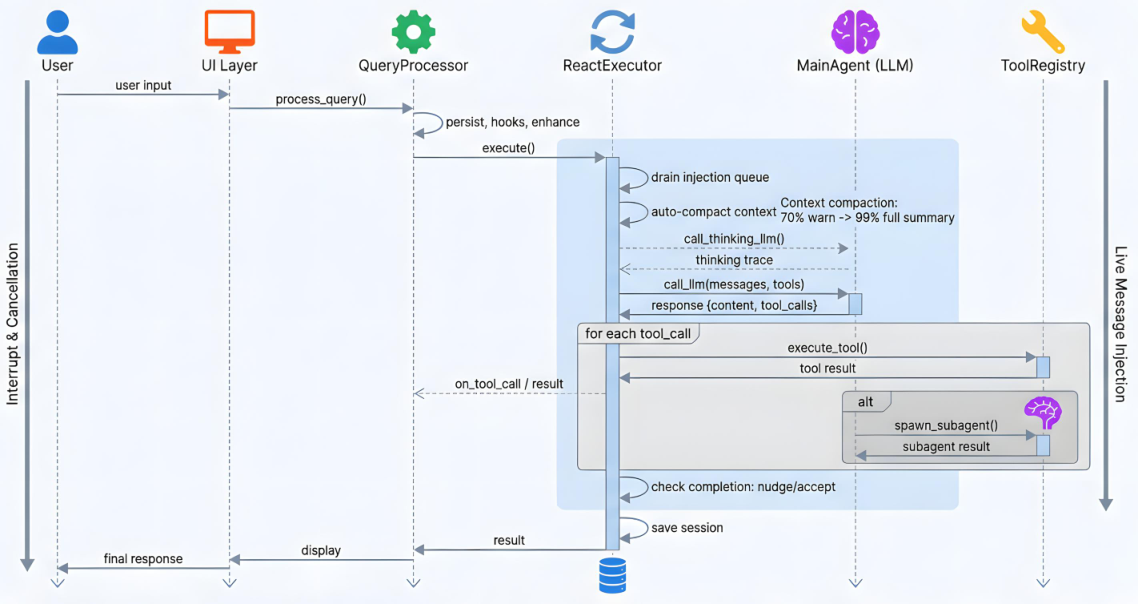
用户输入经三种入口路径之一到达:创建一次性会话的非交互式 CLI 调用、包裹交互式 REPL 的 TUI,或经 WebSocket 接收消息的 Web UI。三条路径汇聚到同一个代理执行核心。TUI 路径在进入 ReAct 循环前有一个预处理阶段:将消息持久化到会话存储、触发可检查或修改查询的生命周期钩子、把内联文件引用(如 @file)展开为其内容,以及按 LLM API 期望的格式组装消息列表。Web 与 CLI 路径直接调用代理,不做预处理。
ReAct 循环的每次迭代遵循固定次序。第一,执行器排空 UI 线程自上次迭代以来注入的所有消息,例如经线程安全队列送达的后续指令或系统信号。第二,上下文压缩器对照上下文窗口检查 token 利用率,压力上升时应用削减策略(第 2.3.6 节描述压缩机制)。第三,若启用了思考模式,一次单独的 LLM 调用产出不带工具访问的推理轨迹,防止过早行动。第四,行动模型接收完整对话(包括任何思考轨迹)连同可用工具 schema,返回可能包含文本、工具调用或两者兼有的响应。当存在工具调用时,执行器经工具注册表分发:只读工具经线程池并行运行(最多五个并发调用),写工具则顺序运行。若某次工具调用委托给子代理,该子代理在带过滤工具访问的隔离上下文中运行,并向父代理返回一份摘要。
循环经四条路径之一终止:代理以纯文本响应且无工具调用(隐式完成)、代理经完成工具显式示意结束、错误恢复预算耗尽(系统对每个错误序列最多注入三条针对性恢复消息(第 2.3.5 节))、或迭代数达到安全上限。在接受终止之前,系统会检查未完成的任务条目与注入队列中的待处理消息(UI 可在执行中途经此线程安全通道递送消息),任一条件成立则推迟完成。一旦接受,最终对话状态被保存到会话存储。
OpenDev 暴露外部脚本可观察或拦截的生命周期事件:SessionStart、UserPromptSubmit、PreToolUse、PostToolUse、PostToolUseFailure、SubagentStart、SubagentStop、Stop、PreCompact 和 SessionEnd。钩子命令通过全局或项目设置中的 JSON 配置,并经 stdin 接收 JSON 格式的事件上下文。阻塞型事件(PreToolUse、UserPromptSubmit、SubagentStart)可阻止操作(退出码 2 会向代理返回阻止原因)、修改工具参数(带 tool_input 键的 stdout JSON)或覆盖审批决定。非阻塞型事件在操作完成后异步触发。全局与项目钩子按事件类型把项目匹配器追加在全局匹配器之后合并,使组织级策略可与仓库专属钩子组合(例如「文件编辑后运行 eslint」)。
三个机制横跨生命周期的所有阶段运作。
中断令牌把取消请求从 UI 传播到代理线程,在每次迭代内的六个阶段边界轮询(思考前后、行动前、工具执行期间以及迭代边界)。中断系统通过针对性修复处理了若干竞态条件:模态控制器(ask-user 对话框、计划审批)优先于代理中断,以防止 UI 状态成为孤儿;子进程创建使用进程组(start_new_session=True),使 os.killpg 能可靠终止子进程;一个一次性守卫防止快速连按造成的重复中断消息。
一个线程安全的注入队列允许用户在代理执行中途发送后续消息;这些消息在迭代边界被排空,并在完成前接受检查,确保没有任何用户输入被悄悄丢弃。
会话成本跟踪在每次 LLM 调用后经 CostTracker 服务记录累计 token 用量与成本,该服务依据 API 报告的 token 计数与模型定价元数据计算成本;累计值显示在 TUI 状态栏并持久化到会话元数据中,供 --continue 调用之间恢复。
2.2.4 REPL 命令分发
上文描述的对话生命周期假定用户输入进入代理推理循环。然而并非所有输入都需要 LLM 参与。会话管理、模式切换、模型选择与 MCP 服务器配置是确定性操作,可由 REPL 直接处理而无需唤起代理。因此系统在输入边界实现了双路分发:若输入以「/」前缀开头,路由到已注册的命令处理器;否则进入查询处理器并进入代理循环。图 7 展示了这一架构。
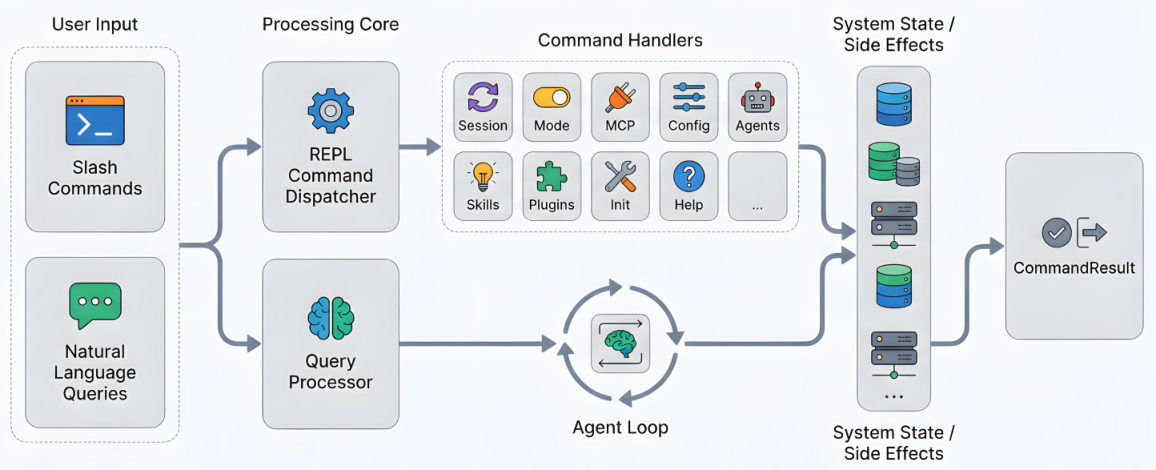
所有命令处理器扩展一个公共抽象基类,它提供处理器接口与标准化的输出格式。每个处理器在构造时收到 REPL 实例的引用,通过显式依赖注入而非全局状态获得共享管理器(会话、模式、配置、MCP)。处理器的 handle(args) 方法执行参数解析、执行操作并返回一个 CommandResult,其中包含成功标志、人类可读的消息与可选的结构化数据。带子命令的命令(如 /mcp connect、/agents create)对参数字符串做第二级拆分并在内部分发给相应方法。
如图 7 所示,九个处理器类覆盖了系统的交互控制面。会话命令(/clear、/compact)管理对话状态:清除会保存当前会话并全新开始,压缩则按需触发上下文削减。模式命令(/mode)通过设置一个待处理标志在普通模式与规划模式间切换,查询处理器在下一次用户查询时读取该标志。配置命令(/models)呈现交互式模型选择器,选定后以新模型配置触发完整的代理重建。MCP 命令(/mcp)暴露十一个子命令管理 Model Context Protocol 服务器:连接、断开、列出工具与测试服务器健康。代理、skills 与插件命令分别管理自定义代理定义、可复用提示词模板与第三方扩展。工具命令(/init)初始化代码库上下文,帮助命令列出所有可用命令。
命令不产生孤立输出;它们修改后续代理交互所依赖的共享状态。如图 7 右列所示,命令处理器与代理循环汇聚到同一系统状态。例如,/models 触发代理工厂的完整重建,用新模型的能力重建工具注册表与系统提示词。/mcp connect 从已连接的服务器发现并注册新工具,扩充代理下一轮可用的工具 schema。/mode plan 设置标志使查询处理器在下一次查询激活规划行为。这些副作用是命令在不直接进入推理循环的情况下影响代理行为的主要机制。
REPL 命令与代理工具之间的区分是架构性的,而非偶然的。命令由用户键入斜杠前缀触发,由 REPL 同步执行,不需要 LLM 参与、无工具使用钩子、无审批门、无撤销跟踪。相比之下,代理工具由 LLM 在推理期间选择,经工具注册表执行并附带执行前后钩子,按配置的自主级别接受用户审批,并被撤销管理器跟踪。命令操作 REPL 实例;工具在携带代理依赖的运行上下文中操作。这一分离确保系统级操作(换模型、管服务器、重置会话)保持快速可预期,同时把开放式问题求解委托给代理循环。
2.2.5 面向工作负载优化的多模型架构
复合 AI 系统范式 [103] 的一个核心认知是:不同执行阶段受益于不同的模型能力。推理任务受益于不被工具干扰的延伸思考;视觉任务需要视觉语言模型;大批量摘要受益于更便宜、更快的模型。对所有任务使用单一模型,要么浪费成本(简单任务用贵模型),要么牺牲质量(复杂推理用便宜模型)。我们考虑了三种方案:单一模型包办一切(简单但不灵活)、任务专属路由(本文采用,在选择逻辑上引入复杂度但可实现工作负载优化)、集成执行(质量最高但延迟与成本难以为继)。
五个不同的工作负载类别路由到专门模型:
行动模型(Action model):基于工具推理的主执行模型。未指定专门模型时所有工作负载的默认选择。
思考模型(Thinking model):用于无工具访问延伸推理的可选模型。可在没有工具调用压力的情况下专注于战略规划。回退:行动模型。
批评模型(Critique model):用于自我评估的可选模型。受 Reflexion [74] 启发,但按需选择性应用而非每轮都做。回退:思考模型
视觉模型(Vision model):用于处理截图与图像的视觉语言模型。对视觉调试任务至关重要。回退:具备视觉能力的行动模型。
压缩模型(Compact model):用于上下文压缩期间做摘要的更小更快的模型。相对推理深度优先考虑速度与成本。回退:行动模型。
每次模型选择都会触发特定提供商 API 客户端的惰性初始化,从而降低启动延迟——只有会话中实际用到的模型才会初始化。模型能力(上下文长度、视觉支持、推理特性)以带存活时间的过期刷新机制在本地缓存,支持离线启动和遵循 stale-while-revalidate(先旧后新)模式的后台更新。该缓存以潜在的陈旧性换取启动可靠性,后台刷新保证最终一致性。
2.2.6 扩展 ReAct 执行循环
选定模式后,代理经 ReactExecutor 处理每个用户查询,它实现了 Reason-Act 循环 [99] 的扩展版本(本文简称 ReAct 循环)。图 8 展示了完整的执行管线。
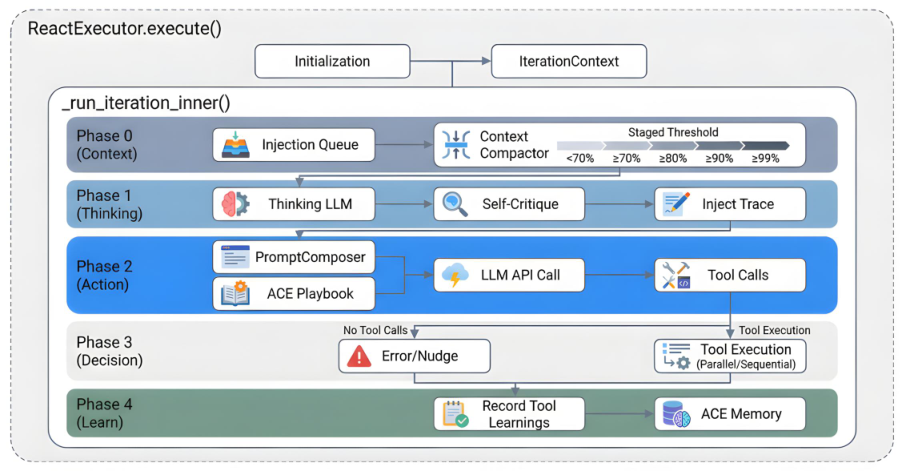
标准 ReAct [99] 在同一轮中交替推理与行动,这限制了深思熟虑。工具 schema 消耗上下文并制造快速行动而非深度思考的压力。我们考虑了四种方案:纯 ReAct(简单但偏向过早行动)、思维链提示(无法按任务复杂度调整深度,不够灵活)、独立的思考阶段(可实现深度控制并防止过早用工具)、Reflexion 式自我批评循环(质量最高但思考延迟翻倍)。OpenDev 组合了后两者:行动前的显式思考阶段,加上面向复杂任务的可选自我批评。
查询到来时,执行器清空待处理的注入队列,创建一个用于取消支持的中断令牌,把对话历史包进 ValidatedMessageList(它强制正确的消息交替),并将一切打包进 IterationContext。该上下文对象携带所有按查询划分的状态:迭代计数器、一次性守卫标志(防止重复信号),以及对工具注册表和审批管理器等共享服务的引用。
每次迭代开始时,执行器排空注入队列并运行分阶段压缩器。压缩器对照上下文窗口监控 token 利用率,随压力上升应用五种逐级加重的削减策略:警告(70%)、观察掩蔽(80%)、快速剪枝(85%)、激进掩蔽(90%)与全量 LLM 压缩(99%)。第 2.3.6 节详述各阶段;关键性质在于更廉价的策略(掩蔽、剪枝)往往就能回收足够空间,避免全量 LLM 摘要的成本。
若启用了思考模式,执行器用一份无工具的对话副本调用独立的思考 LLM。该模型在无法访问工具的情况下产出推理轨迹(对当前局势、潜在方法与风险的结构化分析),因此不会过早行动。把思考与行动分离可防止过早用工具:当工具可用时,模型倾向于快速行动而非深度思考。四个可配置的深度级别(OFF、LOW、MEDIUM、HIGH)让用户能按任务在延迟与深思质量之间取得平衡。在 HIGH 级别会自动附带自我批评:一个批评模型评估初始轨迹,思考模型再以批评作为额外输入精炼其推理。较早的设计把自我批评暴露为独立的第五级,但用户觉得这个区分令人困惑;把它并入 HIGH 在不降低能力的情况下简化了接口,因为想要深度思考的用户总是也会从批评中受益。最终轨迹作为一条系统提醒注入对话,使推理对下一阶段的行动模型可见。
执行器组装完整的行动提示词:系统提示词(由 PromptComposer 从按优先级排序的章节组装而成)、ACE playbook 中选出的记忆条目(第 2.3.6 节)、全部工具 schema,以及包括任何已注入思考轨迹在内的对话历史。该提示词被发送给行动 LLM,后者返回可能包含文本、工具调用或两者兼有的响应。API 报告的 token 计数用于校准压缩器对下一次迭代阶段 0 的利用率估计。
执行器依据行动模型是否产出工具调用进行分支。若无工具调用:当上一个工具失败时,执行器对错误分类(权限拒绝、文件未找到、语法错误、限流等)并注入一条针对性恢复轻推(第 2.3.5 节);当存在未完成 todo 时,轻推代理继续;否则,不含错误信号的纯文本响应意味着任务完成,循环终止。
若存在工具调用,执行器首先进行两级升级的死循环检测:每次工具调用被指纹化为工具名与其参数的 MD5 哈希,指纹在最近 20 次调用的滑动窗口中被跟踪。若任何指纹出现 3 次及以上,系统向对话注入一条 [SYSTEM WARNING] 消息(例如「代理已用相同参数调用 read_file 3 次;请尝试不同方法」)并跳过该轮的工具执行。若警告之后同一指纹再现,系统经 ApprovalManager 升级为基于审批的暂停,向用户呈现「代理正在重复同一操作。允许 / 中断?」。选择「允许」时执行恢复,附带一个一次性守卫——允许该动作一次后重新武装检测。选择「中断」时,向对话注入一条引导消息并重置循环。
这种两级方案比仅用警告更稳健:LLM 可以忽略注入的文本,但无法绕过真正的执行中止。既有防护(迭代上限、连续读取计数器)过于粗糙:它们对任何重复的工具类型都触发,而非针对相同的(工具, 参数)对,而且要经过多得多的迭代才会激活。基于指纹的检测能在 3 次重复内抓住卡死的循环。
未检测到死循环时,执行器选择执行策略(独立调用经线程池并行,依赖调用顺序执行),经注册表运行工具并记录每个结果。执行之后,结果进入 ACE 记忆管线:Reflector 分析哪些做法有效,Curator 用新经验更新 playbook 供后续查询使用。循环随后返回阶段 0 进入下一次迭代。
循环经四条路径之一结束:代理显式调用完成工具并附上摘要与状态(成功或失败);代理产出不含工具调用且无错误条件的文本响应(隐式完成);错误恢复轻推预算耗尽(连续三次失败尝试);或迭代数达到可配置的安全上限。若代理示意完成时仍有未完成的任务条目,系统会注入额外轻推促使其处理完毕后再接受终止,以防带着未完成的工作过早收场。所有情况下,最终对话状态都被持久化到会话存储。
早期实验对每份思考输出都做自我批评;这对常规操作来说太慢,促成了只在 HIGH 思考级别选择性激活。死循环检测是在观察到代理反复以相同参数调用同一工具(例如循环读取一个不存在的文件)之后加入的;基于迭代计数与连续读取计数器的既有防护太粗糙,抓不住这种模式。分阶段压缩(第 2.3.6 节)与基于 todo 的完成校验(第 2.3.4 节)则处理了这一阶段发现的其他失效模式。
2.2.7 子代理编排
有些任务受益于专注的专业能力(代码库探索、用户澄清),另一些任务则需要与主代理状态协调(任务管理)。主代理可以为特定子任务派生专门的子代理,每个子代理拥有过滤后的工具访问与专门提示词。子代理在隔离上下文中执行,拥有自己的迭代预算,防止无界执行。
不同子代理承担不同角色:
代码探索器(Code explorer):用于代码库导航的只读工具。专精于理解既有代码结构。
战略规划器(Strategic planner):只读工具加延伸推理。专注于不落地执行的高层规划。
Web 工具(Web tools):用于克隆 Web 内容的网络抓取与文件写入。将检索与持久化结合。
用户澄清(User clarification):收集输入的极简工具集。专注于不受干扰地引出信息。
子代理能力被刻意限制,原因有三。第一,任务管理工具被排除在子代理之外,只有主代理协调 todo 列表,防止竞态条件与状态不一致。第二,受限的工具访问缩减上下文规模并让每个子代理聚焦其专属角色——例如探索型子代理不需要写能力。第三,受限工具限制了错误的影响范围:探索型子代理不可能误改文件。
主代理可以并发派生多个子代理(各自在自己的线程中)处理相互独立的查询,如并行文件搜索、代码库探索或 Web 抓取。系统提示词明确指导代理何时以及如何并行化:当用户请求多项独立分析、探索大型代码库或任务之间无数据依赖时。在同一响应中发出多次 spawn_subagent 调用会触发自动并行执行。完成后,代理被指示把所有子代理结果综合成一份按主题组织的统一响应,而非分别总结每个代理。这是以线程开销换取独立操作的延迟缩减。
子代理提示词包含显式终止条件以防过度探索。Code Explorer 子代理带有停止条件(「证据明确时停止」「进展停滞时停止」「宁深勿广」)和一条反循环指令(「重读同一文件立即触发停止」)。Planner 子代理被要求在完成摘要中包含 plan_file_path,使主代理能立即把它传给 present_plan。思考模式提示词鼓励为需要深度代码库分析的任务派生 Code Explorer 子代理。
早期版本给子代理与主代理相同的工具。这导致了上下文污染、角色混淆,以及两个代理同时试图更新 todo 时的冲突。把每个子代理的工具集限制到其专属角色,同时改善了专注度与效率。早期子代理提示词缺少明确停止条件,导致无界探索——Code Explorer 会反复读同一批文件;加入显式停止条件与反循环指令解决了这个问题。
代理核心产出推理轨迹与工具调用;接下来描述的上下文工程层管理模型每一步所看到的内容,塑造决定代理每个决策的输入。
2.3 上下文工程层
基于 LLM 的代理并不是简单地把用户消息发给模型再接收响应。每个响应的质量首先取决于模型在其上下文窗口里被允许看到什么:收到哪些指令、保留多少对话历史、从先前交互中学到了什么、每次调用前如何组装相关的外部信息 [56, 39, 101]。我们把管理这一窗口的机制集合统称为上下文工程层 [56, 39, 101]。
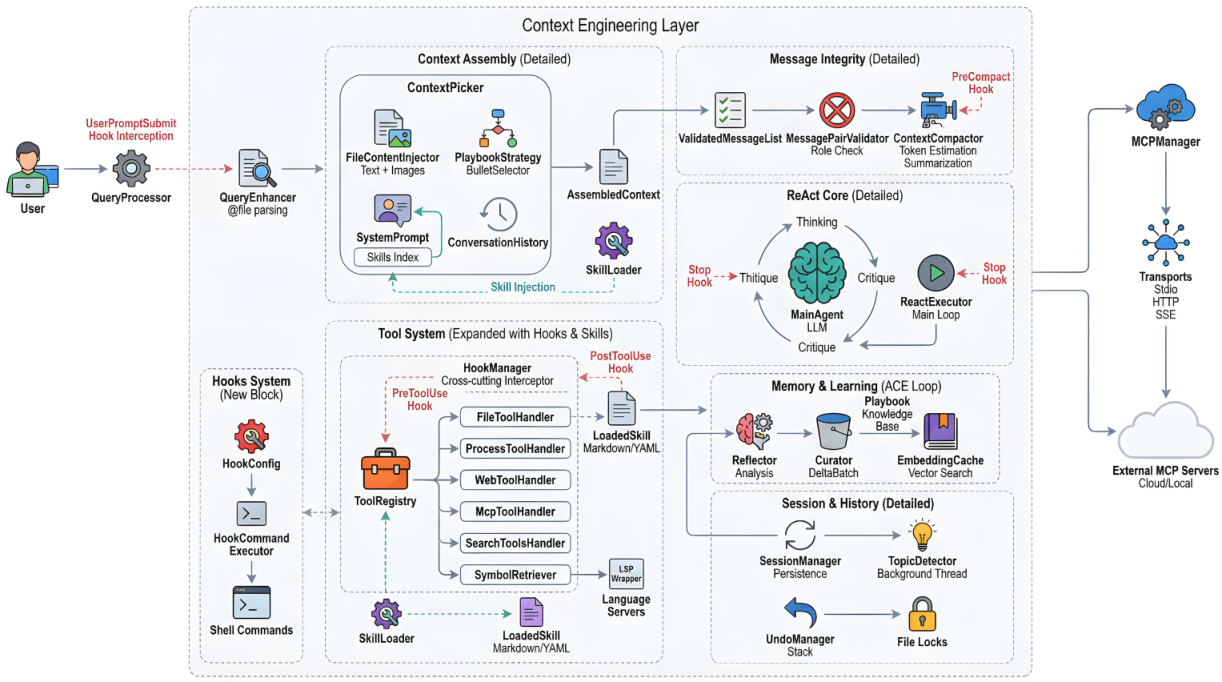
图 9 展示了各子系统及其交互。用户查询经 QueryProcessor 进入,后者交给 ContextPicker 组装上下文。组装好的上下文先经 ContextCompactor 执行 token 预算强制,再进入 ReAct 推理循环。每一轮,结果回流到 SessionManager 持久化,而代表学习机会的工具结果由自适应记忆子系统处理。本节余下部分按各子系统在会话中首次影响上下文窗口的次序逐一介绍。最后一个小节(第 2.3.7 节)把这些组件综合为从用户查询到 LLM API 调用的统一端到端管线。
2.3.1 动态系统提示词构建
在基于 LLM 的代理中,系统提示词是行为控制的首要工具:它编码代理的身份、能力边界、安全约束与任务惯例。每一项无法通过代码强制的行为属性——代理如何推理、偏好哪些工具、如何从错误中恢复——都以自然语言写在系统提示词里。因此在启动时把这个提示词做对不是次要的配置细节,而是核心的初始化问题。
朴素做法是加载一个包含所有可能指令的单体提示词。这有两个复合成本。第一,与当前会话无关的章节(如非仓库目录中的 git 工作流规则、未使用子代理时的子代理编排指引、功能停用时的任务跟踪指令)消耗上下文窗口预算却不产生任何行为价值。第二,无关指令稀释了真正重要的章节,使代理行为更嘈杂。修复方法不是手工裁剪提示词,而是从一开始就让加载具备上下文敏感性。
OpenDev 在运行时经图 10 所示的管线组装每个代理的系统提示词。行为指令被分解为相互独立的章节,每章存为单独的 markdown 文件,并注册两个元数据字段:一个是作用于运行时上下文字典的条件谓词(None 表示总是包含),一个是控制阅读顺序的优先级整数。初始化时 PromptComposer 执行四步:
过滤(Filter)。对照当前环境快照求值每章的谓词。返回 False 的章节在任何文件 I/O 之前被排除。例如 main-git-workflow.md 以 in_git_repo 为门控;工作目录不是仓库时它永不被加载。
排序(Sort)。幸存章节按优先级升序排列:数值更小者更早出现,把身份与角色规则置于环境派生上下文之前。
加载(Load)。读取每个 markdown 文件,剥去人类可读的 frontmatter,并经一个集中式名称注册表解析 ${VAR} 占位符,将模板行文与具体工具标识符解耦。
拼接(Join)。拼接已加载章节并附加到核心角色文本与动态收集的环境块之后,产出完整系统提示词。
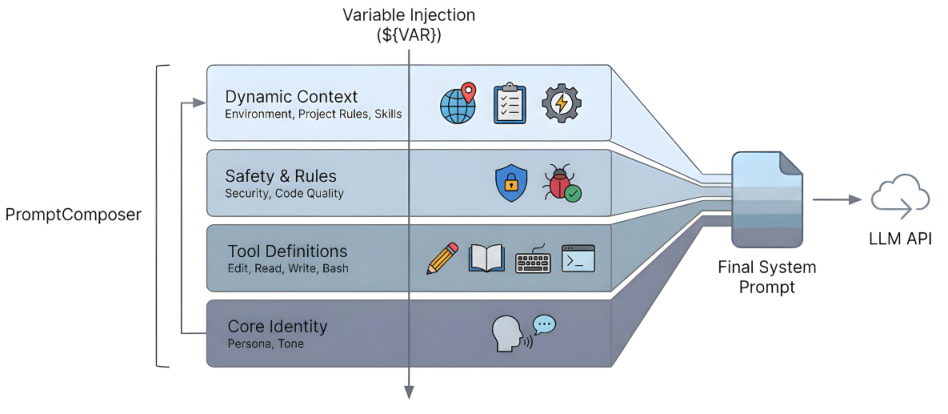
默认行动模式代理在五个功能分层注册模块化章节:承载角色设定与不可协商约束的 Core Identity、承载执行期间所需工具使用与代码质量指引的 Tool Definitions、承载 git 惯例与任务跟踪指令等条件加载策略的 Safety & Rules、承载 LLM 供应商专属行为提示的 Provider-Specific Guidance,以及承载会话专属元数据的 Dynamic Context。思考模式代理注册更少的章节,刻意省去工具使用指引,避免让无工具推理偏向过早行动。附录 C 提供全部主代理与思考章节的完整章节注册表(含条件与摘要);附录 K 复现每个模板的逐字内容。
不同推理阶段需要根本不同的提示词。普通(行动)模式跨五层加载全部已注册章节。思考模式(一个无工具的推理前置阶段)只加载一小组专门构建的章节:可用工具感知(让模型知道有哪些动作可行而不被诱惑去调用)、子代理指引、代码引用惯例与输出格式规则。规划模式使用一个为只读探索优化的独立模板。这种模式特化通过一个工厂函数实现:create_composer(templates_dir, mode="system/main") 返回完整行动组装器,mode="system/thinking" 返回极简思考组装器。
模板使用由 PromptRenderer 在渲染时解析的 ${VAR} 占位符。一个集中式 PromptVariables 注册表把符号名映射到具体工具标识符;例如 ${EDIT_TOOL.name} 解析为 edit_file。这层间接把模板行文与工具命名解耦:重命名一个工具只需改一条注册表项,而不必编辑每个模板。
不同 LLM 供应商的能力与惯例有明显差异:Anthropic 模型支持 tool_use 内容块与延伸思考,OpenAI 模型使用函数调用与结构化输出支持,而 Fireworks 之类推理供应商的上下文窗口上限各不相同。没有供应商专属指引时,代理可能引用它并不具备的能力。PromptComposer 用基于运行时环境上下文中 model_provider 字段门控的互斥条件章节解决这个问题。每个提示词按当前活跃供应商恰好包含一个供应商章节(OpenAI、Anthropic、Fireworks),未知供应商不获得任何章节(优雅退化)。
对于支持输入缓存的供应商(目前是 Anthropic),PromptComposer 提供 compose_two_part() 方法,把组装好的提示词拆分为稳定部分与动态部分。每个章节标注一个 cacheable 标志(默认 True);标记为可缓存的章节(基础指令、工具描述、安全策略)拼入稳定部分,其余(环境元数据、会话专属上下文)拼入动态部分。AnthropicAdapter 把它们组织为一个二元内容数组:稳定块携带 cache_control: {"type": "ephemeral"} 头,动态块不携带。由于系统提示词在每次 LLM 调用时都要重发,而稳定部分通常占总量的 80–90%,缓存它在多轮会话中带来可观的成本节省(缓存部分的输入 token 成本约降低 88%)。不支持该机制的供应商收到拼接后的完整提示词作为单一字符串,行为无差异。
若某个章节文件缺失,组装器跳过它并继续,代理以略缩水的提示词启动而非失败。若模块化组装整体失败(如模板目录缺失),构建器回退到单体核心模板。这保证了部分部署条件下代理仍能启动。
2.3.2 工具结果优化
原始工具输出消耗的 token 远超其信息价值所值。一次 read_file 可能返回 2,000–3,000 token 源码,一次目录列举可能枚举数百个条目,一次测试运行器调用可能产生数千行 TAP 输出。若不加控制,冗长的结果会在几次迭代内占据上下文窗口,把驱动代理行为的用户查询与系统指令挤出局。工具结果优化通过在进入对话历史之前把原始输出变换为紧凑且语义保持的表示来解决这一问题。
每个工具结果经过一个专门的摘要器,它把工具名与原始输出映射为简洁摘要(通常 50–200 字符)。摘要器按工具名分发并应用类型特定的压缩策略:
文件读取被替换为元数据:「
搜索结果报告命中数而非命中行:「
目录列举折叠为条目计数:「
命令执行按输出长度自适应:短输出($\leq
错误截断到 200 字符并带分类前缀:「
对于超过 8,000 字符(约 2,000 token)的输出,摘要器无能为力:即使摘要之后完整输出仍会主导上下文。这类输出在进入对话历史之前被卸载到草稿文件。系统把完整输出写入会话专属的草稿目录(~/.opendev/scratch/<session_id>/),并在对话中用一段 500 字符预览加引用路径替换:「[Output offloaded: 2,341 lines, 48,203 chars <path>](输出已卸载:2,341 行,48,203 字符)。如需完整输出请用 read_file。」这构成一个天然的分层系统:代理看到的足以理解内容,并可按需 read_file 完整输出——后者本身也受同一卸载阈值约束。
输出被卸载到草稿文件时,截断消息会附带一条按当前代理能力量身定制的恢复提示。若代理拥有子代理委托能力(spawn_subagent 工具),提示建议:「委托一个 Code Explorer 子代理经搜索与读取工具处理完整输出。」若代理缺少子代理能力(例如它本身就是子代理),提示则建议:「使用带 offset/limit 参数的搜索工具增量处理输出。」这种代理感知的建议防止了一种常见失效:代理尝试其工具集中并不存在的恢复策略,例如 Code Explorer 子代理试图再派生一个子代理。
工具结果摘要与卸载输出扮演互补角色。在摄取时,它们通过在对话历史中替换完整结果立即节省上下文。在压缩期间(第 2.3.6 节),压缩器在为基于 LLM 的摘要清洗消息时优先使用预计算摘要,避免冗余重处理。这种协同意味着即使触发紧急压缩,输入给摘要 LLM 的内容也已大幅压缩,同时改善了压缩输出的速度与质量。
早期版本不论长短都把完整工具输出存进对话历史。一次长时间运行的测试套件可能在一次工具调用中消耗 30,000 token 上下文。按工具摘要器把这一数字降到大多数情况下不足 100 token。加入 8,000 字符卸载阈值处理了超出摘要器压缩比的剩余离群值(大文件读取、冗长命令输出),把无压缩情况下的典型会话长度从 15–20 轮(上下文溢出前)延长到 30–40 轮。
2.3.3 面向有界思考的双记忆架构
思考阶段(ReAct 循环的阶段 1,第 2.2.6 节)需要对话上下文做战略推理,但完整对话历史可能增长到数十万 token。给思考模型无界历史不可行:既超出模型上下文窗口,又把预算浪费在陈旧细节上。只给最近消息又会丢失战略上下文,导致代理「忘记」总体目标。我们通过一个受人类认知科学启发的双记忆架构解决这一张力:把压缩的远期上下文与详细的近期上下文分离。
一份由 LLM 生成的完整对话历史摘要捕获战略性的远期上下文:已做的决策、总体目标、关键发现与重要文件路径。摘要器被指示保留可操作标识符(文件路径、函数名、变量名、错误码),略去冗长的工具输出与冗余往来。该摘要周期性再生(每 5 条新消息一次,由 regenerate_threshold 参数控制)而非每轮都做。周期性再生一举两得:摊薄摘要调用的成本,并防止摘要漂移——即反复对摘要做摘要导致失真累积的现象。通过从完整历史再生,每份情节记忆快照都是一次全新的压缩,而非压缩的压缩。
最后若干消息对(默认最近 6 次往来,由 exclude_last_n 控制)被逐字保留。这些近期消息携带当下决策所需的细粒度操作细节:最近几轮读到的确切文件内容、具体的错误消息、精确的行号、以及最近一次工具调用的结果。摘要恰恰会毁掉对下一步行动最重要的细节。
每次思考 LLM 调用之前,系统拼接三部分构造思考上下文:(1) 情节记忆摘要,提供「全局图景」;(2) 工作记忆消息,提供操作细节;(3) 当前用户查询。这一结构呼应认知架构 [7] 中情节记忆与工作记忆的区分:情节记忆为长程规划存储过往经验的要旨,工作记忆则为即时使用持有详细的、新近获取的信息。思考 token 预算无论对话多长都保持有界,因为情节摘要有固定最大长度(500 字符)而工作记忆窗口恒定。
早期尝试对整个历史用纯摘要,但关键标识符(文件路径、变量名)丢失,导致代理引用不存在的文件或叫错函数名。相反的极端——只用最近消息——则丢失远期战略上下文:代理 10 轮之后就会「忘记」用户的最初目标。混合架构同时解决了两种失效。我们还发现对先前摘要再做摘要(增量摘要)会在多轮中累积误差;从完整历史周期性再生纠正了这种漂移。
2.3.4 上下文感知的系统提醒
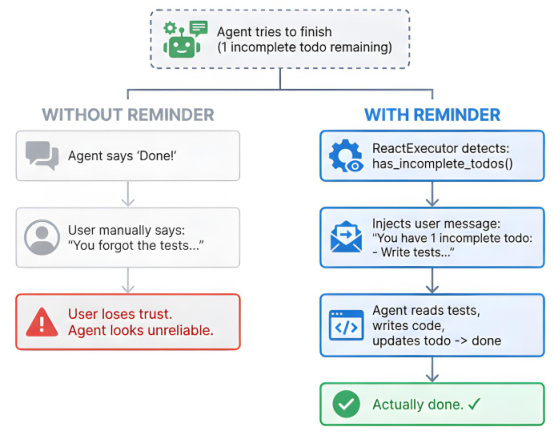
系统提醒针对长时间运行代理会话中的一个根本性可靠性问题:随着对话增长,模型的注意力从初始系统提示词指令上漂移,导致静默失效——过早宣告任务完成、放弃错误恢复、不受控的探索螺旋(图 11)。
设想一个编码代理,其系统提示词要求它编辑代码后总是运行测试。头几轮它照做。但 20 次工具调用之后,随着文件内容、搜索结果与命令输出在对话中堆积,它悄悄停手了。指令仍在系统提示词里,但模型不再注意它。同样的模式以其他形式出现:被要求「停止前完成所有任务」的代理在清单只完成一半时就宣告胜利;遇到文件编辑错误的代理放弃重读文件并重试——尽管指令要求重试。
根因很简单:系统提示词位于对话的最开头。对话越长,模型的注意力越偏向近期消息而远离那最初的指令块。规则仍存在于上下文窗口中,但其影响力随距离衰减。这不是假设性担忧;而是我们在超过 15 次工具调用的会话中一致观察到的、可预测可复现的失效模式。
把所有指令前置在初期有效,但会随会话变长而退化。每隔几轮重新注入整个系统提示词会把 token 浪费在代理当前用不到的指令上。OpenDev 用系统提醒解决:在代理恰好需要的时候、就在它否则就会出错的决策点之前,注入简短的单一用途消息。每条提醒都是一条简短的 role: user 消息,放置在对话的最高新近度位置——紧邻下一次 LLM 调用。图 12 展示了该架构。
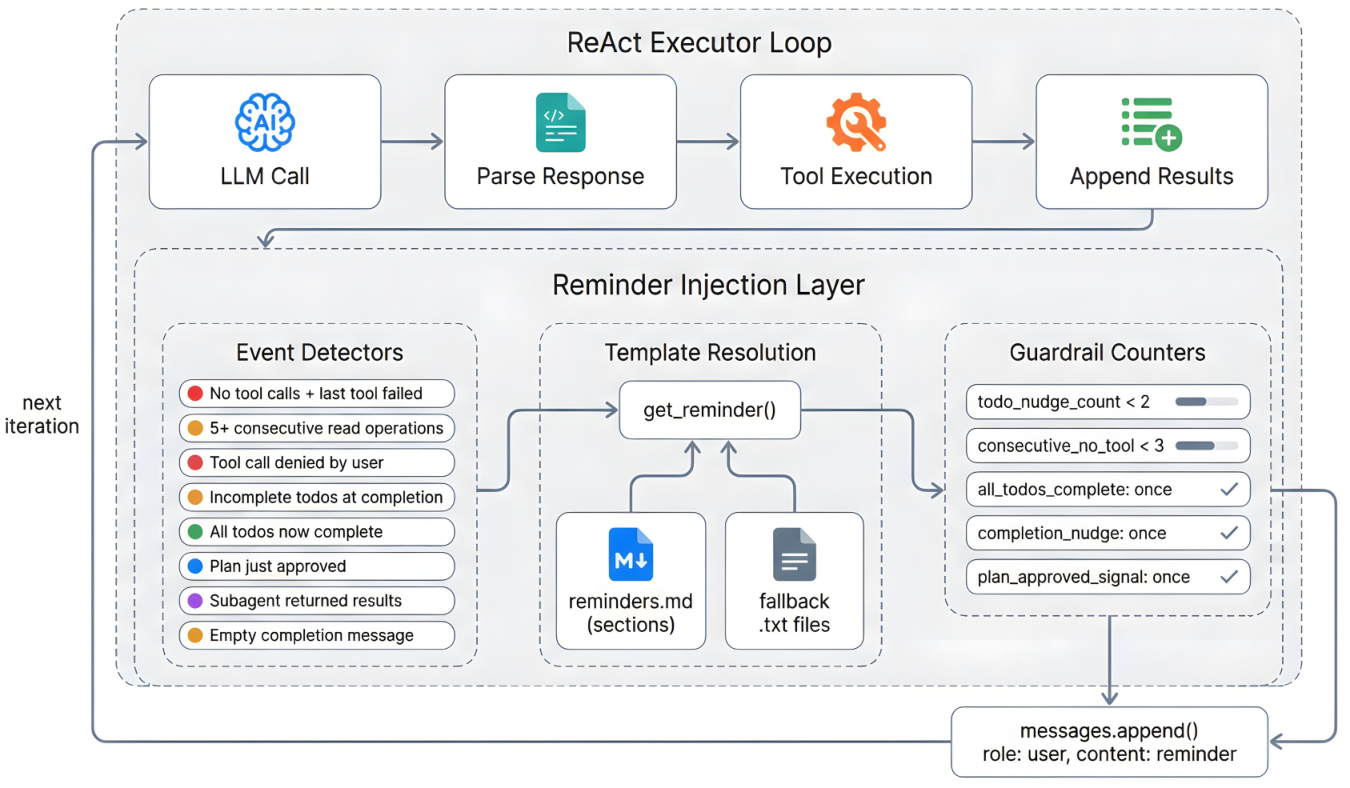
如图 12 所示,注入层在工具执行与下一次 LLM 调用的边界监控八个条件:未重试的工具失败(配有六个按错误定制的恢复模板)、探索螺旋(连续 5 次以上读取)、被拒工具重试、带未完成 todo 的过早完成、全部 todo 完成后仍在工作、计划获批却无后续执行、未处理的子代理结果、以及空的完成消息。每个检测器从按类别组织的命名提醒目录中触发其对应模板:阶段控制、任务生命周期、todo 强制、错误恢复、行为纠正与 JSON 重试(附录 F 提供完整目录与注入时机)。
所有提醒文本存在于源代码之外。单一文件(reminders.md)以 --- section_name --- 标记分隔的命名小节存储短模板。较长的提示词回退到独立 .txt 文件。入口 get_reminder(name, **kwargs) 在首次调用时把文件一次解析进模块级缓存,按名查找小节,并经 str.format() 填充占位符(如 {count}、{todo_list})。模板保持纯文本使其无需触碰 Python 代码即可审计与编辑。
每轮迭代都触发的提醒不再有益,反而成为模型学会忽略的噪音。为防止这一点,每种提醒类型由会话级 IterationContext(图 12 右列)跟踪的计数器或一次性标志治理。未完成 todo 的轻推最多触发两次(MAX_TODO_NUDGES = 2);错误恢复轻推最多三次(MAX_NUDGE_ATTEMPTS = 3);计划获批、全部 todo 完成与完成摘要信号各只触发一次。若代理对已达上限的轻推不响应,系统接受代理的判断继续前行,而不是循环往复。
提醒以 role: user 消息而非 role: system 注入。40 轮对话之后,又一条 system 消息会融入模型早已部分遗忘的背景。user 消息出现在对话流的最高新近度位置;模型把它当作刚刚发生、需要回应的事。用 role: system 注入的早期实验证实了这一点:user 角色提醒产生了明显更高的遵从率。
若提醒模板缺失或检索失败,代理仍持有系统提示词。提醒强化既有指令;不引入新指令。没有它们系统也能工作,但有了它们系统工作得明显更好。
最初系统完全依赖系统提示词。在长会话(30 次以上工具调用)中,代理可靠地表现出注意力衰减失效:过早完成、探索循环、无法从错误中恢复。加入即时提醒解决了每种失效模式。早期错误恢复只用一条泛泛的「再试一次」消息;把错误分为六类并给出针对性指引大幅改善了恢复率——「再读一遍文件」比「修复问题」更可操作。在引入一次性标志与尝试预算之前,有些提醒每轮迭代都触发,导致代理在轻推本身上打转;护栏对稳定性至关重要。早期实验还把提醒作为 role: system 消息注入,效果较差,因为模型把它们当作背景指令而非要求回应的对话提示。
2.3.5 上下文注入式错误恢复
工具调用失败时,原始错误消息作为工具结果进入对话。若不干预,代理常常以道歉回应而非尝试恢复,因为错误消息本身并不传达如何恢复。基于模板的错误恢复通过把针对性恢复指引直接注入上下文窗口来解决,把错误消息变成模型可以照做的可操作指令。
该机制分四步运作:(1) 把消息与六个类别之一(权限错误、文件未找到、编辑不匹配、语法错误、限流、超时)做模式匹配分类;(2) 从集中式模板库取回对应恢复模板;(3) 用上下文专属细节(失败文件路径、不匹配内容、具体错误消息)格式化模板;(4) 在下一次 LLM 调用之前把格式化后的模板作为系统消息注入,使其处于对话的最高新近度位置。例如,编辑不匹配错误产生指引:「文件自你上次读取后已变化;请重读文件并用当前内容重试编辑。」这比泛泛的重试指令可操作得多,因为它告诉模型什么变了、下一步做什么。
每个错误序列 3 次轻推尝试的预算防止无限重试循环:同一错误连续三次恢复尝试失败后,系统接受失败,允许代理继续或向用户求助。模板以纯文本存储在源代码之外,使恢复策略可扩展(新增错误类别只需加模板,无需改代码)且可定制(用户可为项目专属恢复模式覆盖模板)。
2.3.6 自适应上下文压缩
代理在 ReAct 循环中运行时,工具观察——如文件内容与命令输出——不断累积并迅速主导上下文窗口,常常消耗可用 token 预算的 70–80%。标准系统依赖二元的紧急压缩阈值(通常在 95–99% 容量触发),对对话历史做有损摘要。这一方式导致激活过晚、信息损失严重、且后续压缩错误复合。
为缓解这些问题,OpenDev 以 API 报告的 prompt_tokens 计数为校准锚点增量监控 token 使用,并实现自适应上下文压缩(Adaptive Context Compaction,ACC)——一个通过五阶段逐级加重削减策略管线管理上下文压力的框架(图 13)。
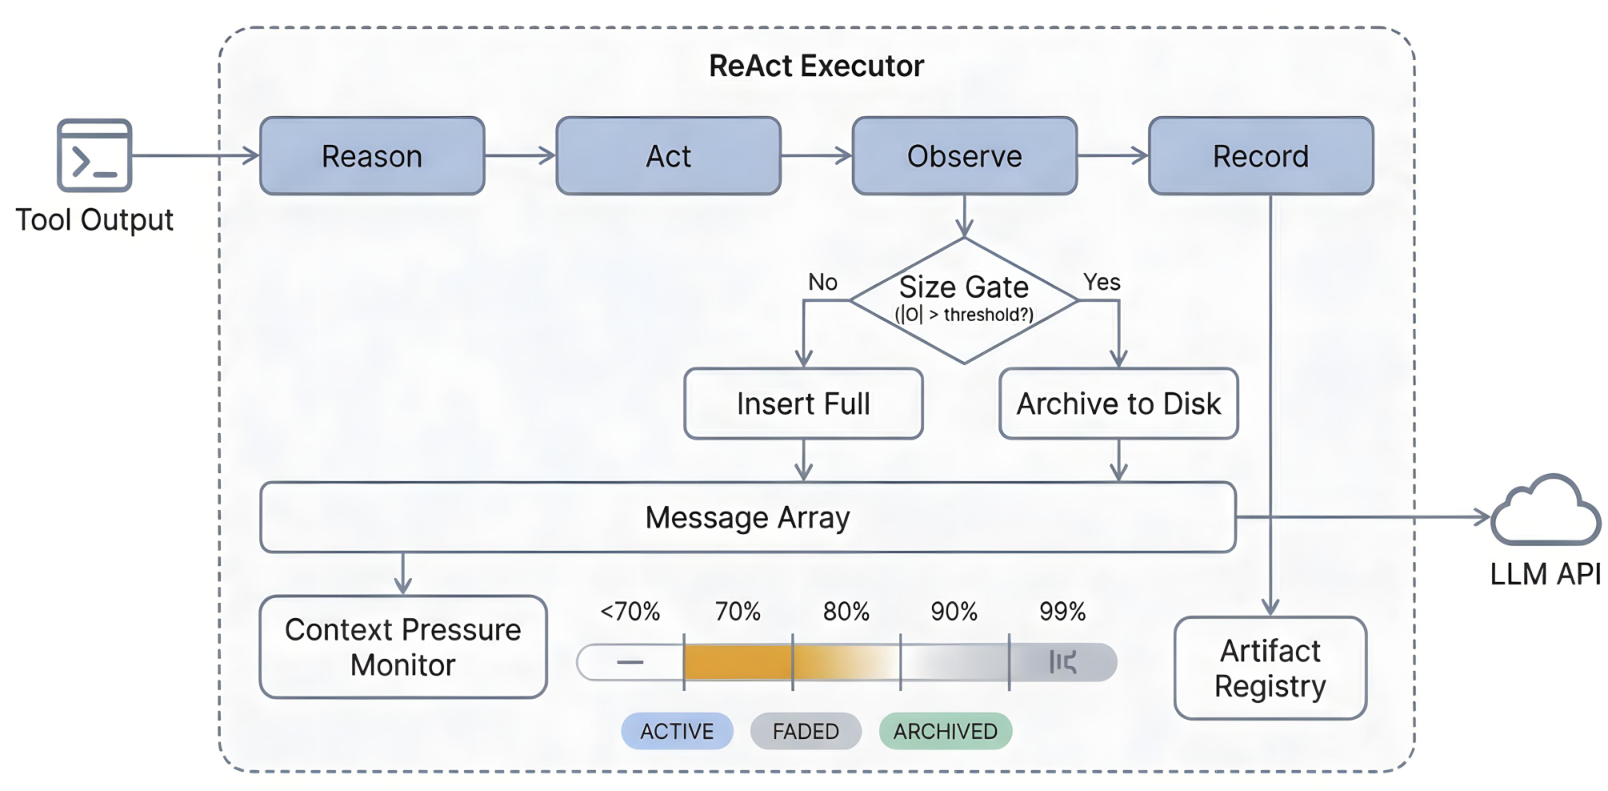
ACC 不等待上下窗口填满,而是在每次 ReAct 迭代开始时监控上下文压力并应用五个渐进阶段:
阶段 1 - 警告(70%):记录上下文压力用于监控。不发生数据削减,但系统开始跟踪利用率趋势。
阶段 2 - 观察掩蔽(80%):较旧的工具结果消息被就地替换为紧凑的引用指针(如 [output offloaded to scratch file]),在保留 LLM API 所需对话结构的同时,把每个观察的 token 占用从数千降到约 15。最近的工具输出以完整保真保留。
阶段 2.5 - 快速剪枝(85%):在诉诸激进掩蔽之前,一次轻量剪枝从后向前遍历工具结果消息。处于保护新近度预算内的结果被保留;更旧的结果替换为 [pruned] 标记。与观察掩蔽(替换为指向卸载文件的引用指针)不同,剪枝属于删除类操作(内容被丢弃而非卸载),但只针对远超新近度窗口的输出。这比基于 LLM 的压缩便宜得多,且往往足以回收空间,完全避开更具破坏性的阶段。
阶段 3 - 激进掩蔽(90%):保留窗口收缩到只有最近的工具输出。所有其他观察被掩蔽。
阶段 4 - 全量压缩(99%):整个对话历史被序列化到草稿文件(确保任何历史细节不永久丢失),一个基于 LLM 的摘要器压缩对话中段,同时逐字保留近期消息。
ACC 的压缩管线还维护一份工件索引(Artifact Index)——一个记录会话期间触及的全部文件与执行的全部操作(读、建、改、删)的结构化注册表。该索引被序列化进压缩摘要,确保代理在上下文被压缩后仍记得自己处理过哪些文件。历史归档路径也被注入摘要(「完整对话历史已归档于 <path>。如需恢复细节请用 read_file。」),使压缩实际上无损:代理可以通过读归档找回任何细节。定量评估表明,ACC 将观察的峰值上下文消耗降低约 54%,在典型 30 轮会话中往往完全消除紧急压缩的需要。
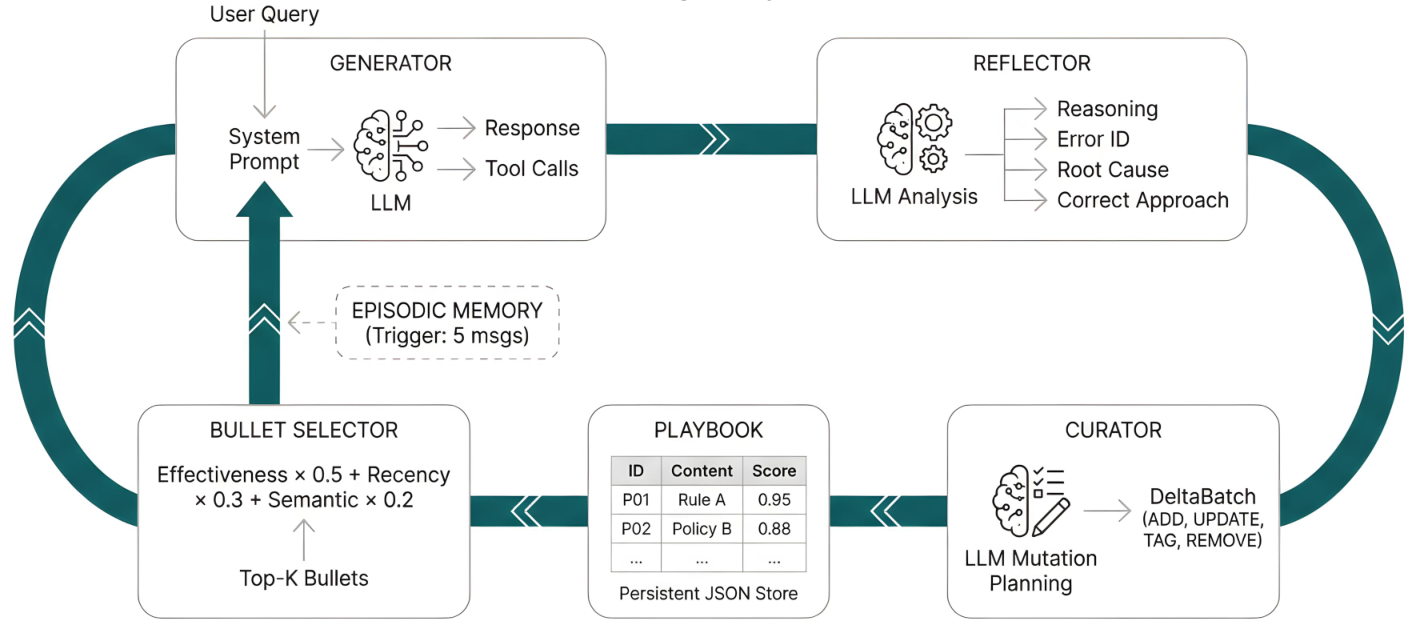
在同一个项目中跨多个会话工作的代理会积累哪些方法行得通、哪些行不通的经验。代理式上下文工程(Agentic Context Engineering,ACE)子系统把这种经验捕捉为一份 playbook:一组自然语言条目,每条标注有效性计数器(有益、有害或中性)与创建时间戳。图 14 展示了保持 playbook 与时俱进的四阶段管线。阶段 1 中,BulletSelector 用一个加权评分(结合有效性 0.5、新近度衰减 0.3、经缓存嵌入的余弦相似度与当前查询语义相似 0.2)为每条条目排序;评分最高的条目被注入 Generator 的系统提示词,让代理能依据既往经验行动。阶段 2 由情节记忆机制治理:每五条代理交互消息,系统激活 Reflector 分析累积经验。Reflector 产出推理轨迹、错误识别、根因分析与正确做法,随后被提炼为条目级有效性标签(有益 / 有害 / 中性),不对 playbook 提出任何结构性变更。阶段 3 的 Curator 读取反思并规划具体变更:添加新条目、更新既有条目、重标有效性计数器或删除陈旧条目,以 DeltaBatch 形式发出。最后在阶段 4,变更被应用到 Playbook 的条目表,更新后的状态持久化到会话级 JSON 文件,为下一个查询周期就绪。
2.3.7 上下文检索与组装管线
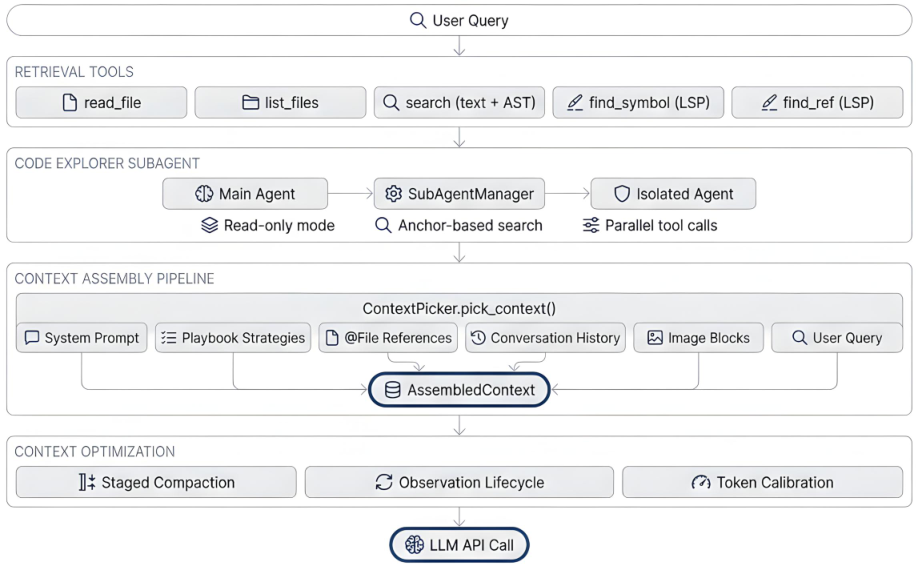
上下文检索是编码代理影响最大的单一能力:每个下游动作(编辑、测试、规划)的质量都受制于代理是否一开始就找到了正确的代码。在传统 RAG(检索增强生成)管线 [44] 中,检索是一次性的静态操作:嵌入查询、取回 top-
五个工具构成检索面:用于定点文件访问的 read_file、基于 glob 发现的 list_files、用于模式匹配的 text_search(ripgrep)、基于 LSP 语义解析的 find_symbol、以及用于结构模式匹配的 ast_search(ast-grep)(第 2.4.2 与 2.4.5 节)。核心设计问题不是提供哪些工具,而是代理如何在它们之间选择。朴素的代理对每次查找都默认用文本搜索——这类似于传统 RAG 中「检索一切」的反模式 [5]。有效检索应从识别查询中最强的锚点开始:约束搜索空间的最具体、信号最强的元素。符号名(如 AuthController.validate)路由到 find_symbol,后者经 LSP 语义解析定义;字符串字面量与错误消息路由到 text_search 做精确模式匹配;结构模式(如「所有检查 is_admin 的 Python if 语句」)路由到 ast_search 匹配语言感知模板;文件路径惯例路由到 list_files 做基于 glob 的发现。通过把检索工具匹配到锚点类型,代理避免了嘈杂的低精度搜索,以更少步骤触达相关代码。这是 Self-Ask [70] 分解策略在编码代理中的对应物:代理不是拿原始用户查询去搜,而是推理自己需要哪类信息,并据此选择检索机制。
当代理确切知道要找什么时,单工具检索就够了;但许多任务需要探索式检索:代理必须跟踪交叉引用、发现意外依赖、迭代收窄宽泛的搜索空间。这正是系统从静态工具调用转向代理式搜索特有的推理—检索交错循环的地方 [99, 80]。当主代理需要广泛的代码库理解而非精确查找时,它委托给 Code Explorer 子代理(第 2.2.7 与 2.4.8 节),后者运行在隔离的上下文窗口中,以只读模式访问同样的五个检索工具。子代理自主执行多步搜索:它可能先用 find_symbol 定位一个类定义,读该文件发现其依赖,再用 text_search 追踪这些依赖在项目中如何被使用。每一步都由子代理自己对「已发现什么、还缺什么」的推理引导,体现了「检索与思维链交错」模式 [80]。上下文隔离至关重要:中间搜索结果(可能有数千行代码)留在子代理的窗口里,只有提炼后的摘要返回主代理。这防止检索过程本身消耗主代理进行推理与行动所需的上下文预算。
仅有检索到的代码工件不够;代理还需要其行为指令、积累的经验与对话历史。每次模型调用之前,ContextPicker 从六个有序来源组装最终消息列表:(1) 系统提示词,附以自适应记忆中选出的 playbook 策略(第 2.3.6 节);(2) 项目级与用户级持久规则;(3) 用户提供的内联 @file 引用与图像块;(4) 从 SessionManager 取回的对话历史;(5) 在决策点注入的系统提醒(第 2.3.4 节);(6) 当前用户查询。每块上下文被包进一个 ContextPiece,跟踪其来源出处(源子系统、优先级、token 成本),使下游组件在预算紧张时能做出知情的保留决策。组装好的结构经 ValidatedMessageList 校验,它强制结构完整性(每条带工具调用的 assistant 消息在下一条 user 轮之前必须跟有匹配的工具结果),并用合成的错误占位符自动修复违规而非直接失败。
组装好的上下文经过第 2.3.6 节描述的分阶段压缩管线。观察遵循从 active(近期,完整保留)到 faded(80% 阈值后可被掩蔽)再到 archived(序列化到磁盘并以引用替换)的生命周期。token 预算对照上一轮 API 报告的 prompt_tokens 校准,而非本地估计,以纠正客户端不可见的供应商侧注入(安全前言、工具 schema)。这最后一步优化确保无论检索并组装了多少上下文,提交给 LLM 的载荷都遵守模型上下文窗口,同时保留最具决策相关性的材料。
这四层构成一条呼应代理式搜索系统升级模式的检索管线 [88]:简单查询在第 1 层以单次工具调用解决;复杂查询升级到第 2 层的多步搜索;所有结果汇聚于第 3 层的组装;第 4 层强制 token 预算。这种渐进升级意味着直接的查找(「读文件 X」)开销极小,而开放式探索(「认证系统是如何工作的?」)可以利用完整的代理式搜索循环,且成本不会渗入主代理的上下文。
上下文工程层塑造模型看到什么;工具系统定义模型能做什么:代理借以修改代码、运行命令并与开发环境交互的具体动作。
2.4 工具系统
代理与开发环境交互所经的工具构成一个可扩展生态系统,在全面能力与上下文效率、安全与灵活性、内置工具与动态发现之间取得平衡。附录 A 的表 1 提供 35 个内置工具的完整目录;本节余下部分先描述把它们组织进处理器类别的注册表架构,再逐类详述:文件操作、shell 执行、Web 交互、经 LSP 的语义代码分析、用户交互与任务管理、经 MCP 的外部工具发现,以及子代理委托。一套纵深防御安全架构横跨所有类别。
2.4.1 注册表架构与 Schema 构建
随着能力增长,平坦的工具命名空间会变得不可管理:硬编码的分发逻辑不灵活,无结构的动态插件加载不安全。备选方案从硬编码工具集(简单但不改代码就无法加能力)到平坦动态加载(灵活但混乱,导致命名冲突、缺乏组织、安全管理困难)。OpenDev 采用带处理器类别的注册表,把工具组织进基于 schema 注册的处理器类。
图 16 展示了该架构。工具系统把 schema 构建、分发路由与生命周期钩子分离为不同组件。
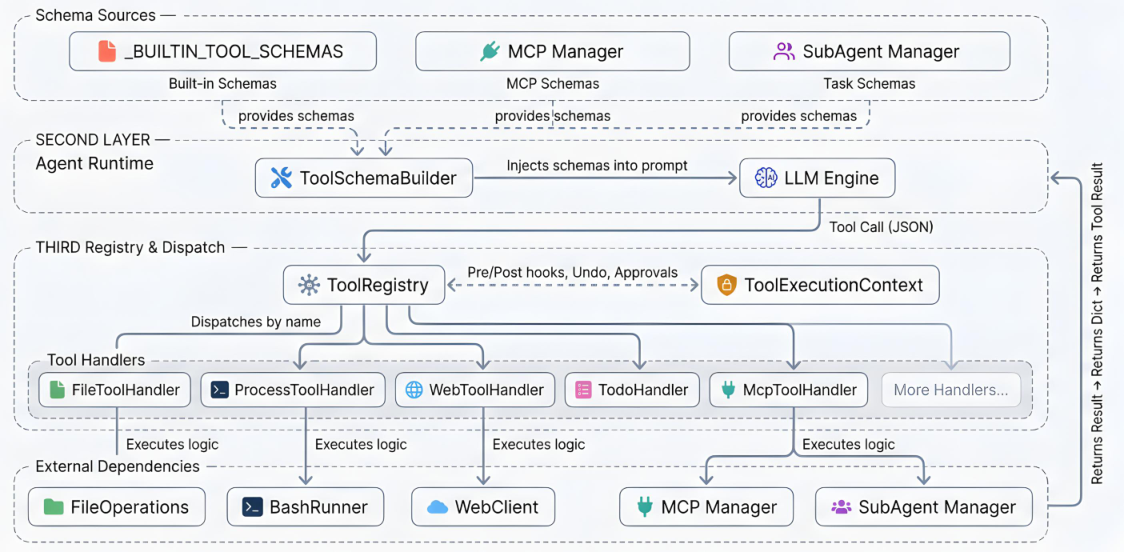
ToolSchemaBuilder 从三个来源组装 JSON schema:(1) 定义约 40 个内置工具的静态 _BUILTIN_TOOL_SCHEMAS,其描述经 load_tool_description() 从 markdown 模板加载;(2) 动态发现的 MCP schema,仅包含 _discovered_mcp_tools 集合中的工具,以避免上下文膨胀;(3) SubAgentManager 在场时注入的子代理 schema。组装好的 schema 被注入 LLM 提示词,让模型知晓可用能力。
ToolRegistry 充当中央分发器,把工具名映射到 12 个按类别组织的处理器类的方法(文件、进程、Web、笔记本、用户交互、任务管理、思考、MCP 发现、批量执行;完整映射见附录 A 的表 1)。每个处理器收到一个捆绑横切服务的 ToolExecutionContext:模式管理器、审批管理器、撤销管理器、任务监视器、会话管理器、UI 回调与文件时间跟踪器。注册表通过在规划模式中带明确错误信息地拦截写操作,在分发给处理器之前强制模式限制。
生命周期钩子在不修改处理器代码的情况下提供可扩展性。钩子系统定义十个生命周期事件(SESSION_START、USER_PROMPT_SUBMIT、PRE_TOOL_USE、POST_TOOL_USE、POST_TOOL_USE_FAILURE、SUBAGENT_START、SUBAGENT_STOP、PRE_COMPACT、SESSION_END 与 STOP),覆盖从会话初始化到关停的完整代理生命周期。PreToolUse 钩子在执行前同步触发:返回退出码 2 的钩子会硬阻断工具调用,向模型返回一个任何提示工程或审批配置都无法覆盖的错误。钩子还可以通过返回带 updatedInput 字段的 JSON 对象修改工具参数,实现透明的命令改写(如注入 --dry-run 标志)。PostToolUse 与 PostToolUseFailure 钩子在执行后经线程池异步触发,适合审计与记录而不拖慢代理。注册为钩子的外部脚本经 stdin 接收完整 JSON 事件上下文(包括会话 ID、工作目录、工具名、工具输入以及(对后置钩子)工具响应),支持诸如阻止向受保护路径写入、强制命名规范或向外部系统流式审计日志等项目专属策略。钩子匹配器对工具名使用编译后的正则模式,允许从单工具规则到兜底策略的细粒度定向。
早期版本把工具直接注册在全局命名空间,导致命名冲突与逐工具安全配置复杂化。基于类别的处理器同时解决了两者:安全规则作用于类别级别,且每个类别提供隐式命名空间。
任何工具调用到达其处理器之前,运行时审批系统基于用户配置的信任边界对执行设门。三个自主级别控制默认姿态:Manual 要求每次工具调用显式审批;Semi-Auto 自动批准只读操作(ls、cat、git status 等精选白名单命令)而对写入提示确认;Auto 为受信任工作流批准所有操作。在默认级别之外,ApprovalRulesManager 依据一套带优先级的规则集评估每条命令,规则有四种类型:Pattern(对完整命令串的正则匹配)、Command(精确匹配)、Prefix(前缀匹配,如 git 匹配 git push)与 Danger(带自动拒绝语义的正则匹配)。优先级 100 的默认危险规则(匹配 rm -rf /、rm -rf *、chmod 777 等模式)始终生效,不能被用户配置或审批级别变更覆盖。规则按优先级顺序评估;首个匹配决定动作(自动批准、自动拒绝、要求审批,或要求用户在执行前编辑命令)。
审批规则经两个 JSON 存储跨会话持久化:位于 ~/.opendev/permissions.json 的用户全局规则与位于 .opendev/permissions.json 的项目级规则。两者并存时,同一模式下项目规则优先,支持按仓库的信任边界(例如共享项目可以限制用户个人配置允许的 docker 命令)。审批流程适配活跃前端:TUI 呈现带键盘导航的阻塞式 prompt_toolkit 菜单,Web UI 则广播 approval_required WebSocket 事件并以 300 秒超时轮询一个 threading event,在浏览器中渲染审批对话框。每个审批决定(命令、采取的动作、匹配的规则与时间戳)都被记录进 CommandHistory 以供审计。
2.4.2 文件操作
五个工具处理所有文件系统交互(见表 1 的 File Ops 类别),覆盖从读写到结构化编辑与搜索。它们共同构成代理操作代码的主要手段。
read_file 读取文件内容,带 cat -n 风格的行号,为代理提供后续编辑所需的精确位置引用。三个参数控制读取窗口:file_path(必需)、offset(1 起始的行号,默认 1)与 max_lines(默认 2000)。处理器在把内容返回给代理之前应用若干输出变换:
二进制检测:非文本文件被检测并以描述性错误拒绝,而非返回损坏的字节序列。
输出截断:超过 30,000 字符的内容用保留头 10,000 与尾 10,000 字符的头尾策略截断,中间放置截断标记。这确保代理同时看到长文件的开头(导入、类声明)与结尾(近期新增)。
逐行截断:超过 2,000 字符的单行被截断,防止压缩版代码或数据文件消耗过多上下文。
陈旧读取跟踪:一个 FileTimeTracker 记录每次读取的时间戳。跟踪器在每次成功读取时以 (session_id, file_path) 为键记录 datetime.now()。任何编辑之前,assert_fresh() 校验 os.path.getmtime(file_path)
write_file 只创建新文件,拒绝覆写既有文件,引导代理改用 edit_file。该约束防止意外的整文件覆写——当代理凭记忆重建文件而非应用定点编辑时,这是一种常见失效模式。参数:file_path、content 与 create_dirs(设置时自动创建父目录)。处理器对写操作运行审批流程,把动作记录到撤销管理器以支持回滚,成功时返回文件路径与字节数。
当基于 LLM 的代理编辑文件时,它指定要查找的 old_content 与要替换的 new_content。实践中,LLM 产出的 old_content 常与实际文件略有出入:行尾空白差异、缩进不匹配、转义序列差异,或因凭记忆而非逐字复制重建代码带来的轻微重排。严格的精确匹配编辑工具在这些情况下失败,产生「content not found」错误,用错误消息与恢复尝试消耗上下文。
edit_file 工具实现带九个替换器类的责任链模式,每个类处理一类特定的不匹配,从精确匹配到空白归一化、缩进弹性、转义处理与上下文感知锚定(附录 D 逐一列举全部九趟及其说明)。每个替换器返回原文件中实际找到的子串(而非搜索查询),因此替换保留文件原有格式。调试日志记录哪一趟成功。链条首次匹配即短路,因此精确匹配不从模糊趟次承担任何开销。
除匹配之外,编辑处理器还强制若干安全与可观测措施。陈旧读取校验拒绝编辑自代理上次读取后被修改过的文件。唯一性校验确保匹配无歧义:多个匹配产生错误而非静默误编辑。创建备份状态用于撤销跟踪。成功编辑后,处理器调用 lsp.touch_file(filepath) 通知运行中的语言服务器,随后(去抖地)等待最多 3 秒获取诊断。只有 Error 严重级的诊断被纳入;警告与提示被抑制以免上下文噪音。最多 20 条诊断作为结构化反馈附加到工具输出(如「LSP errors detected: line 42: undefined variable 'foo'」),给代理即时反馈并支持同轮自我纠正。若该文件类型没有运行中的 LSP 服务器,该检查被静默跳过。同时生成一份统一 diff 展示给用户。
list_files 列出目录内容或执行基于 glob 的文件搜索。参数:path(要列的目录)、pattern(用于过滤的 glob 表达式)、max_results(默认 100)。结果渲染为展示目录结构的树状视图。常见忽略模式默认排除:node_modules、.git、pycache、.venv、.DS_Store 及其他平台专属产物。输出上限 500 条,防止大型仓库导致上下文溢出。
search 支持两种搜索模式,满足互补需求。type="text" 时,工具委托给 ripgrep 做高性能的基于正则的内容搜索,可配置上下文行数,支持完整 PCRE2 模式语法。type="ast" 时,工具委托给 ast-grep 做结构化代码搜索,使用带 $VAR 通配符的语言感知模式模板(如 if $COND: $BODY 匹配任何 Python if 语句,无论具体条件或内容)。参数:pattern(正则或 ast-grep 模板)、path(搜索根)、type("text" 或 "ast")、lang(ast 模式的语言提示)。结果上限 50 条匹配、总输出 30,000 字符。
最初的编辑工具采用两趟策略(精确匹配,然后去空白匹配)。这是「content not found」错误的头号来源。分析失败日志发现,LLM 格式漂移落入若干清晰可预测的类别(空白归一化、缩进位移、转义序列差异、部分上下文锚定),每一类都可以用一次针对性匹配趟处理。把这一观察泛化为带九个逐级放宽替换器的责任链架构,解决了绝大多数编辑失败,同时通过短路评估保持精确匹配的性能。
2.4.3 Shell 执行与后台任务
四个工具处理 shell 执行与后台任务管理(见表 1 的 Process 类别)。代理需要运行任意 shell 命令来做测试、构建与系统交互,但必须安全地做;开发服务器之类长驻进程需要带输出捕获的后台执行。
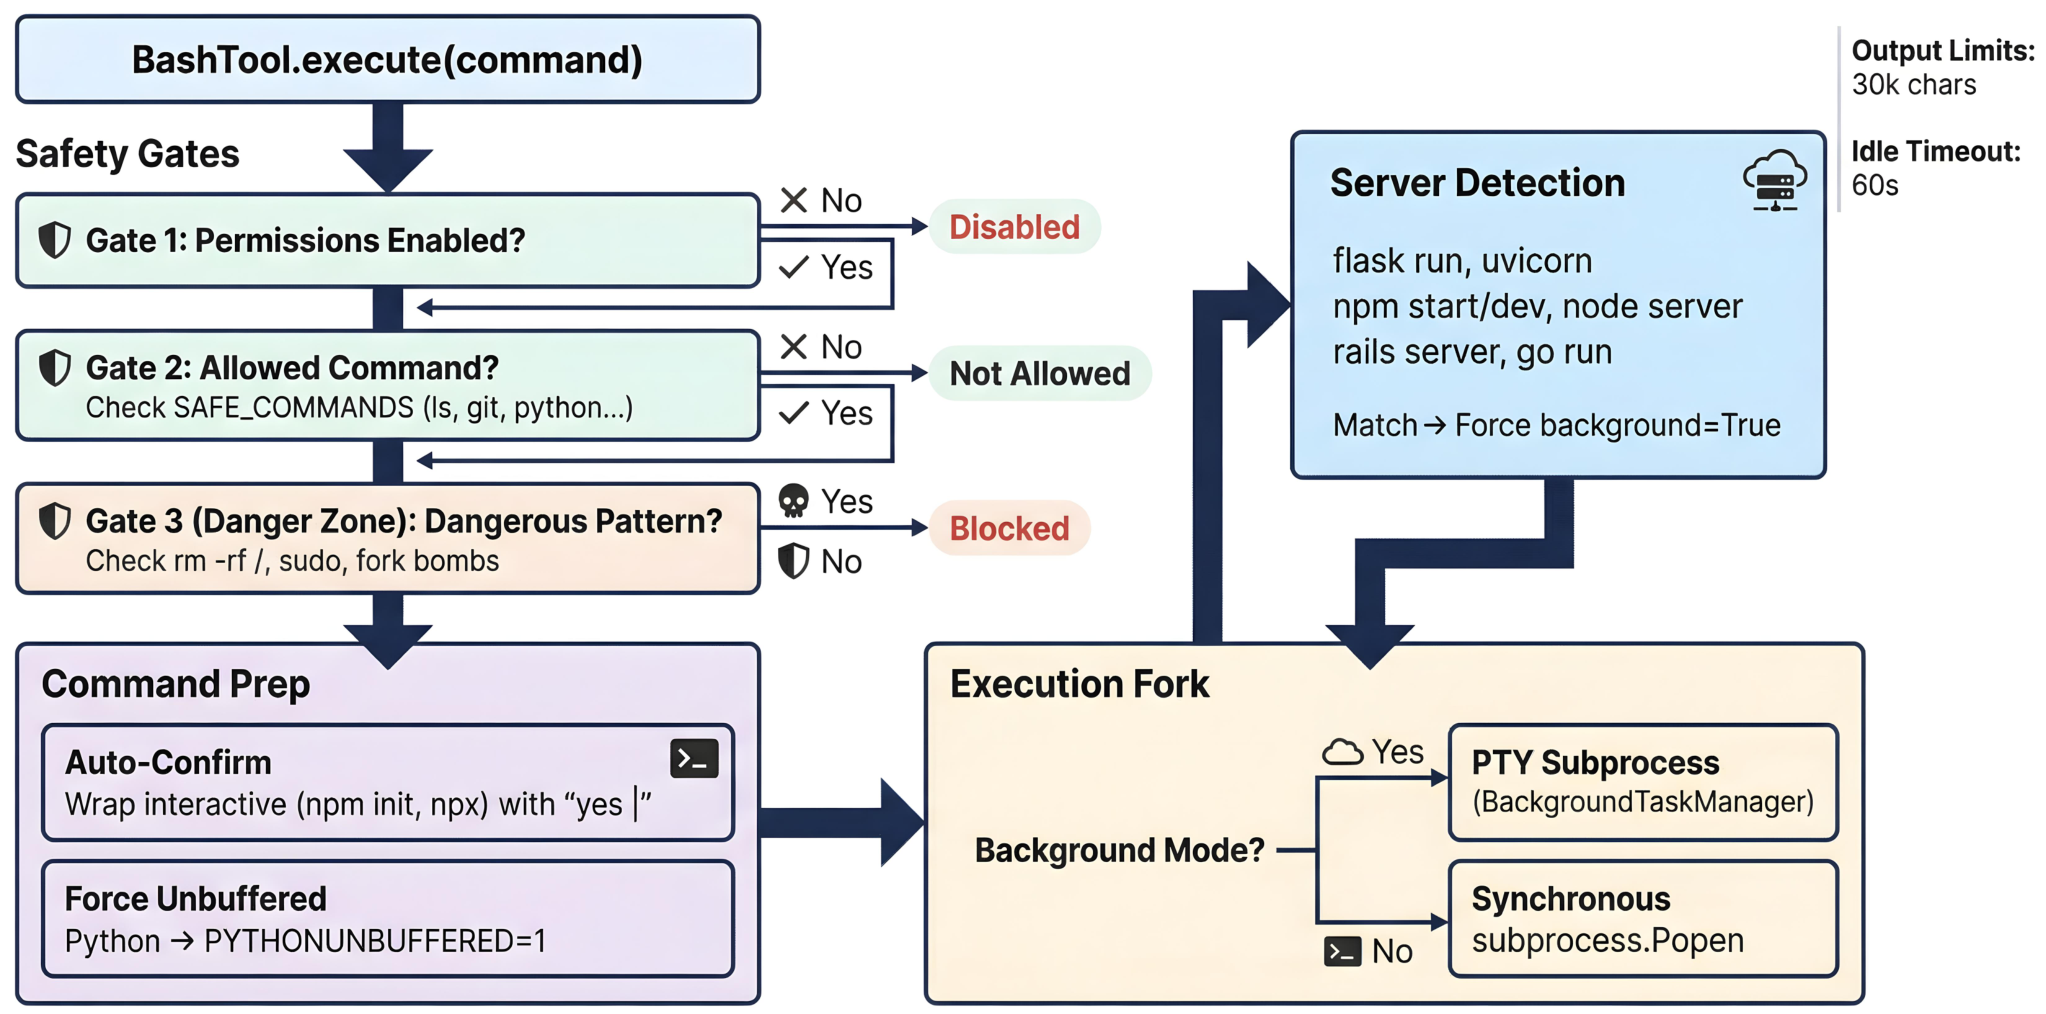
图 17 展示了该管线,每条 shell 命令经六个阶段处理:(1) 安全门以不可覆盖的方式拦截危险模式;(2) 命令准备自动确认包管理器提示并为 Python 输出去缓冲;(3) 服务器检测对 16 种框架模式做正则匹配(第 E.2 节),自动把长驻服务器提升为后台模式;(4) 在基于 PTY 的后台与带进程组隔离的管道前台之间执行分叉;(5) 输出管理带 30k 字符头尾截断与 100ms 轮询;(6) 超时处理带 60 秒空闲与 600 秒绝对上限。附录 E 提供完整的逐阶段细节与完整服务器模式表。
被提升为后台的命令注册到 BackgroundTaskManager,它分配 7 字符十六进制 ID(来自 uuid4().hex[:7],提供
list_processes 返回全部被跟踪的后台任务及其 PID、状态(running/completed/failed/killed)与墙上时钟运行时长。这使代理能看到哪些进程活跃,得以检查长驻服务器、识别停滞的构建,或判断哪些任务需要关注。
get_process_output 按任务 ID 取回后台任务输出文件的最后 100 行,让代理无需重跑命令即可访问服务器日志、构建输出与错误消息。这对监控开发服务器、检查后台运行的测试结果、诊断长驻进程故障至关重要。
kill_process 以优雅升级方式终止运行中的后台任务:经 os.killpg() 向整个进程组发 SIGTERM,等 5 秒优雅关停,进程仍在运行则升级到 SIGKILL。守护输出线程收到停止信号,PTY 主文件描述符被关闭。按进程组杀确保命令派生的子进程(如 webpack dev server 派生的文件监视器)随父进程一起终止。
最初实现用 subprocess.run() 加固定超时。开发服务器必然撞上超时然后被杀。基于活跃度的空闲超时解决了服务器问题,基于 PTY 的执行解决了输出缓冲问题——程序在进程终止前不产生任何可见输出。
2.4.4 Web 交互
四个工具提供 Web 交互能力(见表 1 的 Web 类别),用于文档调研、内容检查与基于浏览器的测试。所有 Web 工具均为只读,可安全用于规划模式。
fetch_url 用 Crawl4AI 检索 Web 内容——一个构建在 Playwright 之上的浏览器引擎爬取库。浏览器引擎方式能处理简单 HTTP 客户端会漏掉的 JavaScript 渲染内容(单页应用、动态加载的文档)。HTML 被转换为 markdown,供 LLM 高效消费。输出上限 50,000 字符,每页超时 30 秒。文件下载被阻止以防磁盘滥用。
对多页探索,该工具支持三种可配置策略的深度爬取:广度优先(BFS)、深度优先(DFS)或最佳优先(按内容相关性排序优先)。参数控制最大爬取深度、页面数上限与域名过滤器,防止爬出目标站点。Playwright Chromium 在首次使用时自动安装,安装在该工具首次被调用时透明触发。
web_search 经 DuckDuckGo 搜索网络——选择它是因其尊重隐私的设计(无用户跟踪、不保留搜索历史)。返回最多 10 条结果,每条含标题、URL 与文本摘要。域名过滤器允许把结果限定到特定站点(例如只搜官方文档域名)。工具返回结构化结果,代理随后可用 fetch_url 跟进获取完整内容。
capture_web_screenshot 经 Playwright 无头浏览器截取整页截图。可配置的视口尺寸(默认 1920$\times$1080)允许按不同响应式断点捕获页面。可选的 PDF 输出模式生成带分页的文档。对 JavaScript 初始化繁重的复杂页面,超时可延长至 180 秒。返回截图文件路径,代理可在后续分析中引用或展示给用户。
open_browser 经平台原生命令在系统默认浏览器中打开 URL 或本地文件。本地文件路径自动转换为 file:// URI。该工具在代理的无头环境与用户的可视工作流之间架起桥梁,适用于预览生成的 HTML、评审开发中的 Web 应用,或打开代理无法提供凭据的需登录文档链接。
最初实现用 requests 库做简单 HTTP 请求,在主导现代文档与 Web 框架的 JavaScript 渲染单页应用上失败。切换到带 Playwright 浏览器引擎的 Crawl4AI 解决了这一问题,实现内容提取前的完整 DOM 渲染。
2.4.5 经 LSP 的多语言语义代码分析
六个工具经 LSP 提供多语言语义代码分析(见表 1 的 Symbols 类别),分为两个只读导航工具与四个结构化编辑工具。基于文本的工具能搜字符串但错过语义结构:找一个方法的全部使用处需要区分方法调用与变量名、处理重载、跟踪跨文件引用。为每种语言自建解析器不可行,因此 OpenDev 采用经标准语言服务器的 Language Server Protocol(语言服务器协议)集成 [58],复用一个由领域专家维护各服务器的成熟生态。
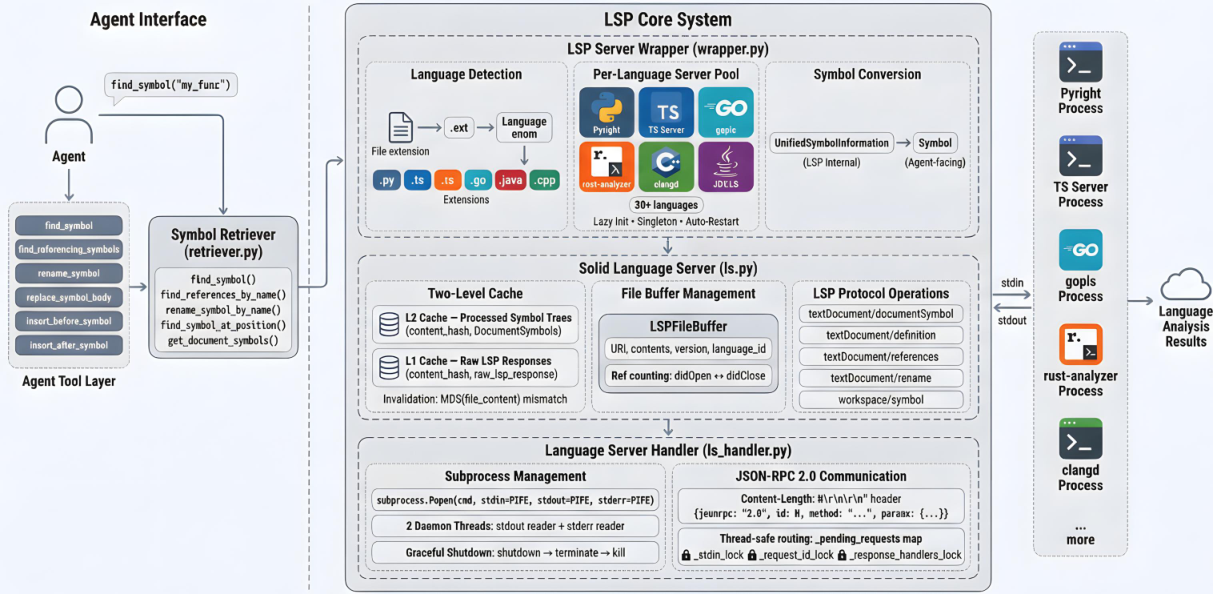
图 18 展示了组织为四层的架构,逐层把面向代理的工具调用翻译为语言服务器专属的协议消息。Agent Tool 层暴露下述六个工具;每个工具接受一个文件路径与符号名,语言检测、服务器选择与协议翻译由下层透明处理。Symbol Retriever 提供统一 API,用 NamePathMatcher 把符号名解析为位置,支持精确匹配(MyClass.method)、部分路径匹配(method 匹配任何路径以 .method 结尾的符号)与通配符匹配(My* 匹配 MyClass、MyModule)。LSP Server Wrapper 经单例池处理语言检测(30 多种文件扩展名;见图 18)与服务器生命周期:每种语言一个服务器、惰性启动、自动存活检查、崩溃时透明重启。Solid Language Server 经一个通过 stdio 上的 JSON-RPC 2.0 通信的子进程处理器管理底层 LSP 协议,每个服务器两条守护线程做 I/O、线程安全的请求 ID、可配置的逐请求超时。每个语言服务器扩展一个公共基类并做语言专属覆写(初始化参数、忽略目录、跨文件引用等待时间),使新增语言只需投入一个服务器类而无需修改核心框架。
为避免冗余 LSP 往返,每个语言服务器维护以文件内容哈希(MD5)为键的两级缓存。第 1 级缓存原始 LSP 响应;第 2 级缓存处理后的符号树(含父子关系与正文预览)。文件未变时,查询直接从第 2 级返回而不联系服务器。文件变了但原始响应 schema 未变时,仅基于缓存的第 1 级数据重算第 2 级。缓存存储用 pickle 序列化放在项目的 .solidlsp/cache/<language_id>/ 目录,带版本字段确保不兼容缓存被丢弃。
find_symbol 参数:symbol_name(支持 MyClass.method 这样的限定名、部分匹配与通配符)、可选 file_path 用于限定搜索范围。返回符号定义及其种类(函数、类、变量等)、位置(文件、行、列)、名称路径(如 module.Class.method)与正文预览(前 200 字符)。存在多个匹配时全部返回并附完整路径,让代理消歧。
find_referencing_symbols 参数:symbol_name、file_path(定义所在处)、include_declaration(是否包含定义本身)。按语义找出全部引用(调用、导入、类型标注)并按文件分组。用于重构前的影响分析与理解一个符号如何被代码库消费。
rename_symbol 参数:symbol_name、file_path、new_name(校验为合法标识符:以字母或下划线开头、仅含字母数字)。按逆序(每个文件内自底向上)应用 LSP 服务器 textDocument/rename 返回的工作区编辑,使先前的编辑不会移动后续编辑的行号。只重命名代码引用;字符串与注释保持不变。
replace_symbol_body 参数:symbol_name、file_path、new_body、preserve_signature(默认 true)。检测正文边界(Python 为冒号,类 C 语言为开花括号),只替换正文而保持签名、装饰器与 docstring 完整。这使代理能重写函数实现而不意外改动其公共接口。
insert_before_symbol / insert_after_symbol 参数:symbol_name、file_path、content。在命名符号之前或之后以匹配的缩进级别与空行分隔插入内容。适用于在相关代码旁添加方法、在调用者附近插入辅助函数,或把测试用例放在其测试的函数旁边。
最初方案考虑用 tree-sitter 语法自建基于 AST 的分析。tree-sitter 固然提供快速增量解析,但缺少语言服务器提供的语义理解:类型解析、跨文件引用跟踪与工作区级重命名。LSP 集成复用了每个语言服务器由领域专家维护的成熟生态,而按需的服务器生命周期确保资源消耗随实际使用而非支持语言数量扩展。
2.4.6 用户交互、任务管理与规划
八个工具支持用户交互、任务管理与基于计划的工作流(见表 1 的 Task Mgmt、User Input、Planning 与 Completion 类别)。它们构成系统的人在回路骨架,确保代理能在关键决策点收集需求、汇报进度并获得批准。
ask_user 每次调用最多呈现四个问题,每个问题都采用为高效用户交互设计的结构化格式。每个问题包含:一个头部标签(最多 12 字符,显示为紧凑的 chip/标签便于视觉扫读)、2–4 个各带标签与含义说明的选项,以及一个用于非互斥选择的可选 multiSelect 标志。每个问题自动附加一个带自由文本输入的「其他」选项,确保用户永远不会被限制在代理给出的候选之内。
渲染适配活跃 UI:TUI 把问题呈现为带键盘导航的模态对话框,Web UI 使用基于轮询的调查组件——代理线程阻塞直到用户经 WebSocket 提交响应。这种带超时的阻塞设计确保代理等待用户输入,既不空耗 CPU 也不带着假设推进。
四个工具管理一个跨代理迭代持久化的轻量看板式任务列表:
write_todos:从结构化定义创建或整体替换任务列表。每个任务有标题、描述与状态(todo、doing、done)。
update_todo:按数字 ID、标题或 slug 修改既有任务。强制同一时刻至多一个任务处于「doing」状态:把新任务设为「doing」会自动把先前活跃任务退回「todo」。
complete_todo:把任务标记为完成,可选附加一条记录完成了什么的完成日志消息。
list_todos:返回按状态优先级排序的全部任务:doing 最前,其次 todo,最后 done。这一排序确保代理的注意力被引向活跃与待办工作。
present_plan 读取计划文件(由代理在规划模式期间写就),向用户展示其内容,并在进入实现之前请求显式批准。用户以下列三种结果之一回应:
approve_auto:批准计划并自动批准实现该计划的全部后续编辑,为受信任计划最小化审批摩擦。
approve:批准计划但在实现期间逐项审查每个编辑,保持细粒度控制。
modify:带反馈拒绝,提供代理应在重新呈递前纳入的具体修改。
获批后,计划步骤被自动提取进 todo 列表,创建一个结构化执行跟踪器,代理用它有条不紊地实现每一步并汇报进度。
task_complete 示意代理已完成当前任务,提供摘要消息与成功/失败状态。该工具承担一个关键架构角色:它给 ReAct 执行器一个结构化终止信号,把有意完成与迭代耗尽(撞上最大迭代上限)区分开。没有这个工具,代理要么一直循环直到被切断,要么产出无结构的最终消息,使系统难以判断任务是否真正完成。
早期版本缺少结构化用户交互;代理输出难以可靠解析的自由文本问题。引入带类型化选项与描述的结构化多选格式改善了响应质量、减少了误解,并让 UI 在 TUI 与 Web 界面渲染出一致的问卷式对话框。
2.4.7 经 MCP 的 token 高效外部工具发现
一个工具 search_tools 经 Model Context Protocol(模型上下文协议)[1] 提供 token 高效的外部工具发现(见表 1 的 Discovery 类别)。经搜索发现的外部工具随后经 McpToolHandler 调用,由它把调用分发给相应服务器。核心问题是上下文效率:一个有 100 个外部工具、每个 schema 平均 200 token 的系统,光工具定义就消耗 20,000 token。全量纳入 schema 浪费;彻底排除外部工具又限制能力。OpenDev 采用惰性发现:工具按需经关键词搜索找到,只有已发现工具的 schema 进入上下文。
图 19 展示了三组件交互。系统集成 MCP 获得动态工具连通性。用户经管理命令配置外部工具服务器(数据库客户端、API 服务等)。系统维护一个已发现工具集合,只包含被显式搜索过或先前调用过的工具的 schema。初始上下文不含任何外部工具 schema。当代理调用 search_tools(例如查询 "database query tools")时,SearchToolsHandler 从所有已注册 MCP 工具的名称与描述构建词表,提取关键词(3 字符以上的 token),并用词表匹配对每个工具按查询打分。最高分的匹配以名称与描述返回给 LLM。随后 ToolRegistry 经 discover_mcp_tool() 把匹配到的工具标记为已发现,把其 schema 加入已发现集合,使下一次 LLM 调用包含它们。以限定名直接调用 MCP 工具(如 mcp__github__create_issue)会自动发现该工具,无需事先搜索。McpToolHandler 把调用转发给相应外部服务器,管理序列化与错误处理。
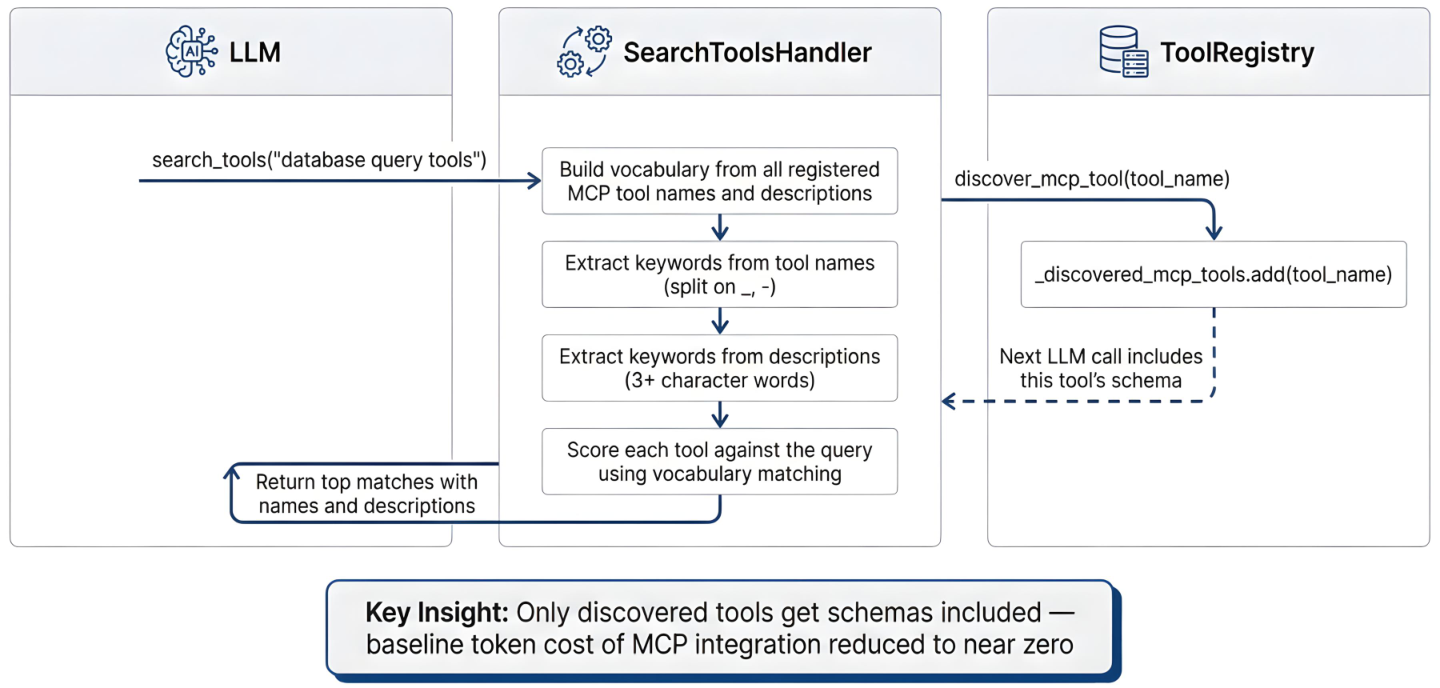
三个细节级别控制上下文投入:names 只返回工具名(token 最少),brief 附加简短描述,full 触发后续 LLM 调用中的完整 schema 纳入。名称匹配记 2 分、描述匹配记 1 分;结果按总分排序,最相关的工具排在最前。这是以发现开销(代理必须先搜后调)换取上下文节省(只加载相关工具)。对使用少量外部工具的工作流,节省可观;对使用大量外部工具的,开销累积但有界。
最初实现把所有外部工具 schema 纳入每次调用,在第一条用户消息之前就消耗多达 40% 的上下文。惰性发现把基础开销降到近乎为零($<$5%),只随能力被实际使用而增长。
2.4.8 子代理委托、Skills 与批量执行
本节描述三个把代理能力扩展到单工具调用之外的工具:处理复杂子任务的子代理委托、按需加载领域专长的 skill 加载,以及面向多工具效率的批量执行。
spawn_subagent 启动一个拥有自己的 ReAct 循环与过滤后工具注册表的隔离子代理。八种子代理类型各自把可用工具限定到其领域:Code-Explorer(只读导航)、Planner(读加写计划文件)、PR-Reviewer(带 diff 分析的代码评审)、Security-Reviewer(漏洞扫描)、Web-Clone(网站复刻)、Web-Generator(按规格建站)、Project-Init(脚手架生成)与 Ask-User(仅 UI 的结构化问卷)。工具隔离确保子代理不会互相意外干扰或越出其预定范围。附录 G 提供带逐子代理工具清单的完整能力矩阵。
一个关键设计属性是自动并行化:当主代理在同一次 LLM 响应中发出多次 spawn_subagent 调用时,SubAgentManager 经 asyncio.gather() 并发执行它们,每个子代理跑在独立线程中,拥有自己的迭代预算与工具工作线程池。这使代理能自然地铺开工作(例如并行地「调查认证模块」与「评审数据库 schema」),无需显式并发管理。
附加参数提供弹性:模型覆盖(快速低成本任务用 haiku,均衡能力用 sonnet,复杂推理用 opus)、后台执行(代理不等待完成继续运行),以及按代理 ID 恢复会话(支持上下文跨调用保留的多轮子代理工作流)。
Skills 是以带 YAML frontmatter 的 markdown 文件存储的模块化知识单元,提供领域专长(git 惯例、代码评审清单、部署流程),无条件加载会浪费上下文。系统分两阶段处理 skills:
阶段 1:元数据发现。启动时,SkillLoader 扫描所有 skill 目录,只解析 YAML frontmatter 提取名称与描述。这份轻量索引进入系统提示词,使代理无需加载教学内容即可发现可用专长。描述遵循「Claude Search Optimization」惯例,均以「Use when…」开头说明触发条件(如「Use when writing bash scripts that need to wait for external conditions」),面向代理可发现性优化。
阶段 2:按需加载。当代理判定某个 skill 相关时,它以 skill 名调用 invoke_skill。加载器读取完整 markdown 内容,剥去 frontmatter,把教学正文注入对话上下文。一个去重缓存确保每个 skill 每会话至多加载一次,防止冗余调用污染上下文。
Skills 从三个严格排序的层级发现:项目本地(.opendev/skills/,最高优先级)承载仓库专属惯例,用户全局(~/.opendev/skills/)承载跨项目的个人偏好,内置(随包分发,最低优先级)承载默认专长。两个 skill 同名时,高优先级来源胜出,支持对默认行为的项目专属覆盖。
batch_tool 在单个代理轮次中支持多次工具调用,减少往返开销。代理指定执行模式:parallel(线程池,最多 5 个并发 worker)用于读多个文件或跑多个搜索之类相互独立的操作,serial 用于先建目录再往里写文件之类有依赖的操作。由代理指定模式是因为只有它从上下文知道依赖关系,系统无法可靠推断操作是否独立。曾尝试自动依赖检测但不可靠;由掌握完整上下文的代理显式指定模式干净地解决了问题。
最初设计没有批量执行;每个工具都要一整次 LLM 往返,读多个文件要花多轮。Skills 原本在启动时全量加载,把上下文耗在会话中从未用到的专长上。子代理最初顺序运行,即使任务相互独立。当前架构同时解决了三个问题:批量执行消除多余往返,两阶段 skill 加载把基础开销降到一份紧凑的元数据索引,子代理调用自动并行化在不要求代理显式管理并发的情况下利用任务独立性。
上述工具产出工件与副作用;持久化层确保它们跨会话存活,并在代理犯错时提供回滚。
2.5 持久化层
持久化层用磁盘上的普通文件存储对话历史、配置、模型元数据与文件操作日志:结构化数据用 JSON,追加密集的流用 JSONL(每行一个 JSON 对象),讲究简单处用纯文本。不需要外部数据库。
所有持久状态位于两个根目录之下。用户全局状态(设置、缓存、已安装插件)放在 ~/.opendev/。项目级状态(会话转录、项目专属设置)放在一个由项目路径派生的子目录:~/.opendev/projects/{encoded-path}/,其中项目绝对路径以破折号替换路径分隔符编码(如 /Users/alice/myapp 变为 -Users-alice-myapp)。这一分离确保关于一个仓库的对话绝不出现在另一个仓库的对话旁边,项目专属设置也不会在无关代码库间泄漏。
2.5.1 会话存储
每个对话存为两个文件:一个 .json 元数据文件与一个 .jsonl 转录文件。元数据文件记录会话标识符、创建与最近活动时间戳、工作目录、标题与摘要,但不包含消息。转录文件存储实际消息,每行一条,序列化为带角色、内容、时间戳、工具调用与 token 计数的 JSON 对象。把元数据与消息分离意味着列出全部会话(向用户展示会话选择器)只需读取很小的元数据文件,而无需加载可能很大的转录历史。
会话经一个即便在并发访问下也防止数据丢失的写入流保存。写入前,系统对元数据文件获取带 10 秒超时的排他文件锁(fcntl.flock)以防死锁。元数据先写入临时文件,再经 os.rename() 原子改名就位——在 POSIX 系统上这保证文件要么完整写入要么原封不动,绝不会写一半。转录文件遵循同样的加锁协议。两个文件都更新后,会话索引也原子更新。
系统不要求显式保存命令,而是每 5 轮自动保存对话(可经 auto_save_interval 配置)。每次自动保存同时写入元数据与完整转录。两次自动保存之间,消息只存在于内存。对多通道部署(如 Web 界面),一条独立的追加路径在排他锁下把每条新消息单独写入转录文件,以每消息一次文件系统调用为代价换取即时持久性。
会话累积很多时,扫描项目目录里的每个元数据文件来列出会话很慢。一个轻量索引文件(sessions-index.json)以每条约 200 字节缓存关键字段(会话 ID、标题、消息数、最近修改时间戳),实现即时会话列举。索引在每次会话保存时原子更新。若索引文件缺失、损坏或权限错误,系统自动扫描目录中全部元数据文件重建它,为每个有效会话建条目并删除空条目。这种自愈行为意味着索引永远不成为单点故障:即使文件被误删或损坏,下一次 list_sessions 调用也会透明地重建它。
新会话首次保存时没有有意义的标题。一个轻量主题检测模型检查最近 4 条消息生成短标题(上限 50 字符)。它在后台守护线程运行,从不阻塞主对话循环。用户在一个项目目录启动代理而未指定会话时,系统默认使用该项目最近的会话,支持「从我上次停下的地方继续」的工作流。嵌套子项目的会话不出现在父项目的列表里,因为每个项目根产生不同的编码路径。
每个会话的元数据文件含一个 cost_tracking 对象,记录累计 API 用量:总输入 token、总输出 token、以美元计的总成本(按模型定价元数据计算)与 API 调用次数。该元数据在每次 LLM 调用后更新并随会话持久化。用户经 --continue 恢复会话时,CostTracker 服务从该元数据恢复自身状态,确保运行中成本显示反映完整会话历史而非仅当次调用。
较早版本把消息内联存在元数据 JSON 文件而非独立的 JSONL 转录里。当系统遇到带内联消息而无 JSONL 文件的会话时,会自动把消息迁移到新 JSONL 文件,清空元数据中的内联消息,并保存原文件备份。这一一次性迁移对用户透明。
2.5.2 操作日志与撤销
代理会犯错:写错文件、做了弄坏东西的编辑,或删了用户并不想删的文件。OpenDev 不要求用户用版本控制命令手动撤销这些变更,而是在日志中跟踪每次文件操作(创建、修改、删除),并提供单命令撤销。
每条操作记录包含操作类型、文件路径、时间戳、唯一标识符与操作前的文件内容。这些记录存在两处:一个用于当前会话内快速撤销的内存列表,与会话目录中保证持久性的 JSONL 文件(operations.jsonl)。JSONL 日志尽力而为:写失败(例如权限问题)时记录失败但不打断代理工作。内存列表是撤销操作的首要数据源。
用户调用撤销时,系统从内存列表弹出最近一次操作并逆转它:创建的文件被删除,修改的文件回退到备份内容,删除的文件从保存的副本恢复。内存历史上限 50 条操作以防无界内存增长。达到上限时最旧的条目先被逐出。实践中用户很少需要撤销最近十几次之前的操作,这一界限从未成为限制。
撤销系统与版本控制并行工作而非取而代之。它处理未提交变更而不要求用户会 git,比手打 git restore 更低摩擦地快速纠正代理的错误。
内存撤销日志只跟踪经代理工具执行的文件操作。它无法捕获 shell 命令(如 npm install 修改 package-lock.json)或构建进程的副作用。为实现全面的逐步撤销,系统维护一个影子 git 仓库——位于 ~/.opendev/snapshot/<project-id>/ 的裸仓库,与用户实际仓库不共享历史。在代理每个修改文件的步骤上,快照系统用影子仓库的对象存储对项目工作目录运行 git add . && git write-tree,把树哈希记录进会话元数据。/undo 命令计算当前树与快照树之间的 git diff,识别变更文件,并经 git checkout <hash> -- <file> 恢复它们。影子仓库的 .gitignore 从真实仓库同步以免跟踪构建产物。定期清理(git gc --prune=7.days)保持影子仓库紧凑。该方式利用 git 的内容寻址存储实现完美的文件级恢复,又不干扰用户的版本控制工作流。
2.5.3 配置
配置遵循一个四层层级,设计目标是用户开箱即得合理行为,又能随时在合适的范围内定制任何东西:
内置默认提供无需任何用户设置即可工作的配置(默认模型、temperature、自动保存间隔等)。
环境变量提供 API 凭据与 CI/CD 专属覆盖。API key 只从环境变量加载,绝不从配置文件加载,以防在版本控制中意外暴露。若在配置文件中发现 key,加载时自动剥离。
用户全局设置(~/.opendev/settings.json)存储跨项目偏好,如用户偏好的模型、UI 设置与工具自动批准规则。
项目本地设置(<project>/.opendev/settings.json)存储仓库专属覆盖,如特定代码库用不同模型,或项目专属编码规范。
每层覆盖其上一层:项目设置优先于用户全局设置,用户全局设置优先于环境变量,环境变量优先于内置默认。配置在启动时加载一次并缓存在内存;后续读取返回缓存值而不再读文件。
上下文窗口上限从模型能力自动推导,无需显式配置。用户选择模型时,系统从提供商缓存(见下文)查其最大上下文长度并据此设定 token 预算。这避免了一类常见误配置:用户设定的上下文上限与模型实际容量不符。
2.5.4 提供商与模型缓存
系统需要知道每个提供商有哪些模型及其能力(上下文长度、视觉支持、定价)。OpenDev 不硬编码这些信息,而是从外部目录 API 拉取并把结果缓存在本地 ~/.opendev/cache/ 之下。
缓存采用带 24 小时存活期的 stale-while-revalidate 策略。启动时,系统检查一个 .last_sync 标记文件的修改时间判断缓存上次刷新是何时。缓存不足 24 小时则原样使用。过期或缺失时,系统从 API 拉取新数据,变换为按提供商的 JSON 文件(每个提供商一个,含模型名、上下文长度、能力与定价),并更新标记。网络拉取失败时,系统回退到既有陈旧缓存,完全没有缓存则在没有能力信息的情况下继续。这确保代理离线也能启动:上次成功同步的缓存文件足以正常运作。
环境覆盖(本地目录文件的 OPENDEV_MODELS_DEV_PATH,完全跳过网络的 OPENDEV_DISABLE_REMOTE_MODELS)允许无网络填充缓存,适用于物理隔离环境或固定模型集测试。
上述架构体现了众多设计决策,其理据单从组件描述并不总是显然。下一节从逐组件细节中退出来,检视塑造这些选择的横切设计张力(上下文压力、行为导向、安全强制、LLM 不精确与资源有界),并为类似系统的构建者提炼可迁移的经验。
3 讨论
前几节详述了 OpenDev 的架构与工具生态。这里我们从逐组件描述中退出来,检视塑造系统的五个横切设计张力。每个小节综合跨多个组件的洞见,并为类似代理系统的构建者提炼可迁移的经验。
3.1 上下文压力是核心设计约束
与 CPU 或内存不同,上下文既被系统(提示词、工具 schema、安全前言)消耗,也被代理自身的行为(工具输出、对话历史)消耗。加进系统提示词的每一项能力、返回给代理的每一个工具结果,都在争夺同一份有限预算。以我们的经验,工具输出(文件内容、命令结果、搜索命中)在典型会话中消耗 70–80% 的上下文,令系统提示词与代理自身推理相形见绌。这使上下文利用率成为代理寿命最重要的单一指标,也带来一种无处不在的张力:更丰富的工具输出提升单轮准确率,却缩短会话的有效寿命。
对支持提示缓存的供应商,把系统提示词拆成稳定前缀与动态后缀、给前缀打上缓存控制头,能在多轮会话中获得可观的输入成本节省(第 2.3.1 节)。由于系统提示词在每次 LLM 调用时都要重发,缓存稳定部分摊薄了系统最丰富指令的成本。
向思考模型提供对话上下文时,把压缩的远期上下文(完整历史的 LLM 摘要)与详细的近期上下文(最近几次往来的逐字记录)分离,使思考预算无论对话多长都保持有界,同时保留战略目标与操作细节(第 2.3.3 节)。一个微妙之处:对摘要反复做摘要会在多轮中累积失真。周期性地从完整对话历史再生摘要、而非压缩上一份摘要,纠正这种漂移。
3.2 长时程上的行为导向
系统提示词的影响力随对话增长而衰减。头几轮可靠约束代理的指令,在 30 次以上工具调用之后屡被违反——此时指令远离模型注意力窗口,被数十条工具结果掩埋。因此行为导向本质上是一个信噪比工程问题:如何在不以重复指令淹没上下文的前提下维持遵从。
代理几乎对每次查找都默认用文本搜索(grep),哪怕存在更精确的工具。这浪费迭代并用误报淹没上下文。把一棵检索工具决策树直接编码进代理提示词(符号名路由到语义搜索、字符串模式路由到文本搜索、结构模式路由到 AST 搜索、文件名惯例路由到 glob),减少了不必要的 grep 调用并提升了首试检索准确率。关键在于判定标准必须具体、锚定在查询的可观察特征上(「若目标是函数或类名,用 find_symbol」),而非抽象(「用最合适的工具」)。
不同 LLM 供应商的能力差异明显:延伸思考、函数调用惯例、上下文上限。与其用供应商无关的指令塞满系统提示词,不如注册仅在相应供应商活跃时加载的供应商专属章节,让提示预算保持聚焦(第 2.3.1 节)。未知供应商不获得任何章节;优雅退化好过错误指引。
3.3 以架构约束实现安全
对代理安全而言,把运行时权限检查当作首要抽象是错误的选择。一个在 schema 中看到危险工具的模型可以推理如何调用它、论证为什么应该被允许、试探权限逻辑的边界。更稳健的做法是让违规在结构上不可能:若写工具不在代理的 schema 里,代理就无法尝试写入,因为它根本看不到调用它们的途径(第 2.2 节)。这就是护栏与根本没有路的区别:模型无法推理它不知道存在的能力。
用户把一条审批规则标记为「总是允许」时,把它持久化到磁盘使其在会话重启后存活至关重要。没有持久化,用户每个会话都要对同样的操作重新审批,造成审批疲劳,进而导致一刀切的自动批准,彻底瓦解安全系统。
观察或拦截代理生命周期事件的外部脚本支持自定义策略、日志、CI 集成与安全强制,而无需修改代理代码。钩子接口必须尽早设计:阻塞与非阻塞语义、输入变更支持、全局与项目级配置合并,这些都是钩子有用而非装饰的必要条件。
用户在模态对话框(审批提示、用户提问)激活时按下中断键,系统应取消对话框而非中断代理。对话框悬着时中断代理会制造孤儿 UI 状态(悬空的转圈、过期的 future、未决的 promise),需要人工清理。
3.4 为近似输出而设计
LLM 可靠地产出近似正确的输出。编辑目标偏离实际文件内容:行尾空白、缩进差异、转义序列变体。恢复策略引用代理没有的工具。搜索查询路由到次优工具。一个要求模型精确正确的系统会把大部分时间花在错误恢复循环里。替代方案是把工具与接口设计成把 LLM 不精确当作一等属性来吸收。
无限期运行的开发服务器、构建监视器与测试套件会撞上任何前台超时。用正则模式检测服务器式命令并自动提升为带输出捕获的后台执行,防止代理阻塞在一个本就不打算终止的进程上(第 2.4.3 节)。
依赖外部运行时的工具应在首次使用时自动安装依赖,而不是抛出不透明的错误。检查依赖、缺失即装、然后重试。这消除了一类既让代理也让用户困惑的安装相关失败,是「把工具设计成吸收环境不精确」的又一实例。
3.5 惰性加载与有界增长
急切加载在规模化时失败。启动时加载全部 MCP 工具 schema 会在代理处理第一条用户消息之前消耗 40% 的上下文预算。加载全部 skill 定义会把代理在多数会话中永远用不到的内容塞满提示词。两种情况的解法都是惰性发现:启动时只加载元数据索引,把完整内容推迟到使用点(第 2.4.7 节)。
对 MCP 工具,惰性发现把启动上下文成本从 40% 降到 5% 以下。代理收到一份可用服务器及其能力的紧凑摘要;完整工具 schema 只在代理为特定任务选中某服务器时加载。对 skills,两阶段方法服务于同一目的:启动时加载元数据索引(名称、描述、触发条件),完整 skill 内容(可能含多页提示模板)只在代理决定调用时加载。
外部元数据(模型能力、定价、上下文上限)受益于 stale-while-revalidate 缓存策略(第 2.5.4 节):启动时,新鲜即用缓存;陈旧则先供陈旧数据并后台刷新;刷新失败则继续用陈旧数据。这保证离线启动,消除阻塞整个系统的「无法连接」失败。
把频繁访问的元数据缓存在轻量索引文件中,无需扫描底层数据文件即可快速列举(第 2.5.1 节)。若索引缺失或损坏,自动从底层数据重建,使索引成为性能优化而非单点故障。同一原则适用于任何派生数据结构:把它的丢失设计成触发再生而非失败。
并非一切都要经过代理。会话管理、模式切换、模型选择与服务器配置是确定性操作,应在输入边界直接处理(经斜杠前缀分发或等价机制),无审批门、无撤销跟踪、无 token 成本(第 2.2.4 节)。把这些路由给 LLM 既浪费上下文又引入不必要的非确定性。
这五个设计张力(上下文即预算、长时程行为导向、以架构约束实现安全、为近似输出设计、约束无界增长)并非 OpenDev 独有。它们反映了构建任何长时程代理系统的根本挑战。下一节综述更广的研究共同体如何应对同样挑战,把 OpenDev 的设计决策置于代码智能、自主软件工程与上下文工程的演进版图之中。
4 相关工作
终端中心 AI 编码代理的开发依托于横跨代码智能、自主软件工程与交互式代理设计的一批丰富且快速演进的成果。本节综述为我们的系统设计提供依据的关键研究脉络,并把 OpenDev 置于更广阔的版图中。
4.1 代码生成与代码 LLM
LLM 在编程上的应用从 HumanEval [15] 与 MBPP [6] 基准的函数级生成,经 ClassEval [23] 等类级任务,发展到需要跨文件规划与多步推理的仓库级挑战 [47]。DeepSeek-Coder [33]、StarCoder [48]、CodeLlama [72] 与 CodeT5+ [87] 等专门代码 LLM 推动了这一进程,CodeTF [11] 等统一工具包标准化了跨模型的训练与推理;与此同时,检索增强生成(Retrieval-Augmented Generation,RAG)[44] 与强化学习处理孤立生成与真实仓库规模任务之间的鸿沟 [47]。OpenDev 在此基础上把代码 LLM 嵌入一个提供导航、编辑与执行能力的代理循环,使生成的代码得以应用于真实仓库。
4.2 自主议题解决
SWE-bench [40] 定义了自主议题解决任务,催化出横跨单代理、多代理与工作流式方法的研究前沿 [46]。SWE-Agent [94] 等单代理框架开创了自主文件导航与代码编辑,AutoCodeRover [108] 与 HyperAgent [69] 把它扩展到迭代精炼与通才任务求解。多代理系统把问题分布到专门角色:MAGIS [78] 采用角色扮演协作,CodeR [14] 引入任务图执行,OpenHands [84] 等平台经集成选择编排异构代理 [46]。Agentless [89] 等工作流式方法强制结构化管线(定位、修复、验证)以提升可复现性。
在架构选择之外,社区探索了训练侧与推理时两类方法提升代理能力。结合课程学习 [91] 与合成数据 [68] 的监督微调,加上利用面向过程奖励 [53] 的 RL 算法,赋予模型更强的议题解决技能。推理时方面,蒙特卡洛树搜索 [112] 支持在修复轨迹上灵活回溯,CodeMonkeys [86] 等并行探索策略最大化解覆盖 [46]。OpenDev 吸收这些进展,把单代理自主性与结构化子代理委托、工作流式安全强制相结合。纵观这些范式,代理越来越多地把代码本身当作推理与行动的首要介质。
4.3 代码作为通才代理的核心介质
近期工作凸显了从纯自然语言推理到代码驱动代理交互的范式转变 [47]。把代码用作通用介质,赋予代理精确的工具调用、可复现的状态管理与可组合的动作原语。
ReAct [99] 与 ReWOO [92] 等标准化工具使用模式实现精确的工具调用与状态管理。Model Context Protocol(MCP)[1] 引入结构化消息格式以支持可靠的多轮工具编排,而 Agent-to-Agent(A2A)等多代理协调方案支持代理间直接通信 [47]。
Program-Aided Language Models(PAL)[27]、Program-of-Thoughts [47] 与 Chain-of-Code [47] 等推理方法让 LLM 生成并执行代码以进行结构化推理。动作执行框架把计划翻译为可运行代码:CodeAct [83] 经可执行 Python 实现交互操作,TaskWeaver [71] 把请求转换为基于插件的函数调用,CodeAgents [77] 提供额外的编排模式。领域应用把这一范式扩展到软件工程之外,从医疗(EHRAgent [36])到机器人控制(Code as Policies [52])。
基于代码的存储策略已被证明对管理 LLM 上下文约束有效。Voyager [81] 把已验证技能存为可执行代码供日后复用,Reasoning Bank [54] 支持从修复轨迹进行基于规则的学习。MemGPT [66] 与 ExpeRepair [106] 分别引入层次化与双记忆架构管理上下文,下文上下文工程小节将进一步讨论。
通过在终端环境中运作并经 shell 命令拥抱执行反馈,OpenDev 直接契合「Acting in Code」哲学,把 shell 当作通用解释器来编排复杂的多步工作流。
4.4 代理式软件工程工作流
代理式软件工程(Agentic Software Engineering)形式化了人类工程师与 LLM 在软件任务上协作的工作流。Hassan 等 [35] 提供了全面的研究路线图,识别出代理编排、环境设计与生命周期管理等基础支柱。
Plan–Do–Assess–Review(PDAR)循环形式化单个任务的生命周期:经 Product Requirement Prompts(PRP)规划、由 dev-agent 实现、自我评估与人工评审 [35]。SuperClaude 等 CLI 工具包把这些循环模板化以保持一致与便利,但未上升到团队级方法论。
一个日益壮大的框架家族把结构化规格(而非源代码)当作 AI 辅助开发的首要事实源。GitHub 的 Spec Kit [31] 引入四阶段工作流(Specify、Plan、Tasks、Implement),由正式的 spec.md 与可选的 constitution.md 治理每次代理驱动的变更,确保 AI 生成代码对齐显式声明的意图与架构约束。OpenSpec [26] 采取互补的棕地优先路线,面向既有代码库的演进而非绿地项目:每次提议的变更对持久的规格基线生成规格增量(GIVEN/WHEN/THEN 格式的 ADDED/MODIFIED/REMOVED 需求),使修改在任何代码写就之前即可审计。两个框架都与代理无关,经斜杠命令与文件系统惯例(而非工具专属 API)集成 17+ 编码助手。
BMAD [9] 把团队隐喻推得更远,把代理组织为敏捷角色(Product Owner、Architect、Developer、Scrum Master、Tester),用 PRD 与 story 文件支持跨隔离 Git 分支的并行执行 [35]。一个关键架构决策是工作分片:Scrum Master 代理把任务分解为自包含的 story 文件,每个携带 Developer 代理所需的恰好上下文,从设计上而非靠压缩解决上下文窗口限制。更广 SASE 路线图中的一个关键划分提议把工作区拆分为面向人类监督编排的 Agent Command Environment(ACE)与面向可扩展代理运作的 Agent Execution Environment(AEE)[35]。
SASE 路线图 [35] 提出 Mentorship-as-Code 概念:评审反馈成为版本化、可测试的 MentorScript 规则,支持跨任务的累积改进。代理生命周期管理把代理从无状态的承包者转变为有记忆、可观测、安全执行的持久队友。
OpenDev 体现了一个执行导向的终端枢纽的特质:经命令行交互原生衔接迭代开发循环,并把命令输出当作自主调试与循环精炼的直接信号。
4.5 代理工具系统与模块化组件
在免训练框架中,LLM 依靠专门工具增强推理而无需微调。这些工具沿修复管线组织:bug 复现、缺陷定位、代码搜索、补丁生成、验证与测试生成 [46]。
AEGIS [51] 等 bug 复现工具提供自动化环境搭建与复现工作流,保证执行上下文一致。缺陷定位工具包括基于频谱的缺陷定位(SBFL)与构建代码依赖图的基于图的方法 [46]。代码搜索工具涵盖用 BM25 与基于 AST 的 API 做交互检索,到经知识图谱与 Language Server Protocol 做基于图的理解 [58, 46]。补丁生成工具采用健壮的编辑格式(如 AutoDiff)与经回归测试的集成选择 [46]。SpecRover [16] 用规格引导的搜索产出高质量补丁。Otter [109] 与 Issue2Test [82] 等测试生成工具用反馈驱动机制合成能复现所报缺陷的失败测试 [46]。
OpenDev 采用带惰性发现的基于注册表的工具架构、层次化 skill 模板与纵深防御安全机制,在全面能力与 token 效率之间取得平衡。
4.6 面向长时程代理的上下文工程
上下文管理是长时程代理系统的根本挑战。议题解决任务常需要长时程、多轮的交互,既推高 API 成本,也因上下文腐烂(context rot)加剧性能退化 [46]。
Mei 等 [56] 提供了首个全面的 LLM 上下文工程(context engineering,CE)综述,把供给模型的上下文形式化为结构化元组
Hua 等 [39] 把上下文工程置于更宏阔的思想史中,追溯四个发展时代:聚焦单轮指令的早期提示工程、引入外部知识的检索增强生成、扩展动作空间的工具增强代理,以及把上下文当作一等工程关注点的当前 CE 2.0 时代。借鉴 Dey 从普适计算出发的上下文形式定义与 Weiser 的冷静技术愿景,他们提出三条指导原则:熵减(每个上下文元素都应降低对期望输出的不确定性)、最小充分性(只纳入必要内容以免注意力稀释)与语义连续性(上下文应跨轮连贯演进而非从零重建)。他们还识别出当前系统的狭隘性缺口:绝大多数系统聚焦聊天历史管理,忽视工具状态、环境信号与跨会话知识等整体上下文维度。OpenDev 在注意力关键位置注入事件驱动上下文的系统提醒直接回应语义连续性原则,其分阶段压缩则通过渐进摘要低价值历史实现熵减。
综述文献记录了结构化上下文处理带来的可观定量收益 [56]。思维链变体(tree-of-thought [98]、graph-of-thought [8])通过结构化中间上下文改进多步推理;压缩方法在不成比例损失质量的前提下降低 token 成本:In-context Autoencoder [29] 实现 4$\times$ 压缩,PREMISE 在保持任务表现的同时把提示长度削减 87.5%。检索侧,Self-RAG [5] 引入自反思检索——自适应决定何时检索并批评自身输出,RAPTOR [73] 构建递归树结构摘要支持层次化检索,GraphRAG 利用知识图谱结构(如 HippoRAG [34])提升复杂查询的检索精度。这些进展揭示一个根本的不对称性:LLM 在理解任务中对比生成任务中更能耐受压缩上下文,暗示激进压缩最适合服务于推理的上下文,而非直接塑造输出文本的上下文。OpenDev 的压缩策略利用这一不对称性:激进摘要工具输出与历史轮次(理解性上下文),同时逐字保留系统指令与近期用户消息(生成性上下文)。
Ye 等 [101] 提出 Meta Context Engineering(MCE),一个把上下文工程本身当作优化问题而非手工设计任务的框架。他们把代理上下文形式化为双层优化:外层在上下文配置(系统提示词、工具 schema、记忆策略)上搜索,内层在下游任务上评估代理表现。一个关键洞见是固定评估 harness 会给代理基准引入系统性偏差,因为 harness 本身以可能偏袒某些策略的方式塑造上下文。MCE 用带交叉的
记忆集成让代理超越孤立解题,通过积累历史上下文获得延续性。方法从区分通用知识与仓库专属细节的层次化存储 [46],到把知识划分为情节、语义与程序存储的认知架构 [56, 111, 38]。在上文讨论的记忆原语(MemGPT 的虚拟分页 [66]、ExpeRepair 的双记忆 [106])之上,较新的工作探索种群级记忆:代理变体种群 [17] 维护多样的探索历史以稳健决策,经验库 [85] 以积累的知识引导搜索。当前前沿优先蒸馏可迁移的推理策略,从存储原始数据转向从轨迹抽象高层策略 [46]。
记忆驱动的扩展方法与上文推理时策略互补:集成持久上下文以减少冗余探索,让代理在既往尝试之上构建而非每次从零开始。长时程代理的上下文压缩已有显著进展:ACON [41] 为长程代理会话优化压缩策略,Context-Folding [76] 经递归上下文摘要扩展代理能力。在前沿,Agentic Context Engineering [107] 让模型经自我改进循环演化自身上下文。多代理通信经一系列标准化协议走向成熟:从早期知识共享语言(KQML、FIPA ACL)到现代互操作标准,包括面向工具集成的 MCP [1]、面向代理间直接消息的 Agent-to-Agent(A2A)、以及面向结构化多代理协调的 Agent Communication Protocol(ACP)[56]。OpenDev 经保留关键信息的同时摘要历史的自动压缩、结合双记忆架构与基于模板的错误恢复来应对这些挑战。Young [102] 形式化了代理 harness 的概念——为长时间运行的代理协调工具分发、上下文生命周期、进度跟踪与上下文窗口间干净交接的运行时框架。
4.7 评估代理式编码系统的基准
在上文介绍基础代码生成基准之后,这里聚焦代理式系统周边的评估生态。基准的范围逐步扩大:从函数与类级生成(APPS [37]、CodeContests [50]),经以 SWE-bench [40] 及其变体(SWE-bench Verified [64]、Multi-SWE-bench [104]、SWE-bench Multimodal [96]、SWE-bench Pro [21]、SWE-Lancer [59])为锚点的仓库级议题解决,到环境接地的交互任务如 WebArena [113]、OSWorld [90] 与 EnvBench [24]。互补基准针对特定维度:测试工作流的 SWT-Bench [60]、特性实现的 FEA-Bench [49]、仓库生成的 NL2Repo-Bench [22]、覆盖完整开发生命周期的 DevEval [45],以及长时程软件演化的 SWE-EVO [79]。
专门基准评估通用代码编辑之外的能力。
4.8 评估方法论与最佳实践
对代理式系统的严格评估要求超越简单准确率指标的细致基准设计。Agentic Benchmark Checklist [114, 115] 形式化了包括清晰任务定义、可复现性保证、污染防范与效率感知指标在内的最佳实践。MT-Bench [110] 等 LLM-as-Judge 方法在传统指标无法捕捉语义正确性时支持可扩展的质量评估,不过数据污染仍是需要持续基准更新的关键隐忧 [93, 20]。效率指标(API 成本、推理时间与 token 消耗 [55])与长任务完成度量 [42, 43] 为代理在真实部署中的实用性提供整体评估。
4.9 人机协作
LongCLI-Bench 提供了人机协作显著提升任务完成率的有力证据。执行前注入关键计划的静态计划注入,在通过率与效率上均优于自我纠正。代理依据自身状态请求人工介入的动态交互引导取得更高表现。二者结合的设置取得最佳结果,同时降低对人工介入的需求 [25]。这些发现强烈表明:与其一味追求完全自主,未来系统应发展能兼顾代理高效执行与人类战略指引协同的工作流。OpenDev 经其审批工作流、交互式命令执行与结构化反馈回路支持这一范式。
上述研究版图揭示了一条清晰轨迹:从孤立的代码生成走向必须在能力、安全与上下文效率之间取得平衡的集成式长时程代理系统。基准日益要求在真实环境中持续多步推理,而方法则逐步应对这种持续运作所需的工程挑战(上下文管理、工具编排、记忆与安全)。下一节综合 OpenDev 架构经验与这些更广研究趋势交汇处浮现的具体未来方向。
5 结论与未来方向
本文提出了面向软件工程的开放式 AI 命令行代理 OpenDev,并记录了构建一个生产可用系统的架构决策、设计权衡与经验教训。关键贡献包括:带多模型路由的复合 AI 系统架构 [103](第 2.2.5 节)、带思考与批评阶段的扩展 ReAct 管线(第 2.2.6 节)、自适应上下文压缩(第 2.3.6 节)、事件驱动的系统提醒(第 2.3.4 节)、经验驱动的记忆管线、经 MCP 的惰性工具发现(第 2.4.7 节),以及双接口抽象。
核心架构洞见是:按工作流绑定 LLM(第 2.2.5 节)带来模型无关性——适配新模型只需改配置,无需改代码。schema 级安全强制(第 2.2 节)被证明比运行时权限检查更稳健:把写工具从规划代理的 schema 中移除,就消灭了一整类绕过尝试。条件化提示组装(第 2.3.1 节)通过排除无关指令降低了开销,同时在需要时保留完整指引。在上下文工程一侧,管理有限上下文窗口呈现为一等工程关注点而非次要优化。让观察在 active、faded 与 archived 状态间转移的自适应上下文压缩(第 2.3.6 节)把峰值上下文消耗降低约 54%,且常能完全免除紧急摘要。三层上下文架构(静态系统提示词、动态即时提醒(第 2.3.4 节)与长时程持久化)解决了 30 次以上工具调用后代理可靠违反指令的注意力衰减问题。代理式上下文工程记忆管线让代理在会话内与会话间从工具结果中学习,而无需把策略硬编码进提示词。
本工作浮现的横切设计张力与可迁移经验综合于第 3 节,检视了作为一等约束的上下文压力、长时程行为导向、经架构强制而非运行时检查的安全、吸收 LLM 不精确的工具设计,以及长时会话的资源有界策略。
此前被列为未来工作的若干能力——如经影子 git 快照的逐步撤销(第 2.5.2 节)——已在持续开发中实现,展示了分层架构的可扩展性。
本工作识别的挑战引出若干有前景的研究方向:
在既有基准上做定量评估。本文记录架构决策与设计理据,但缺少系统的定量评估。在 SWE-bench [95]、Terminal-Bench [57] 与 LongCLI-Bench [25](第 4 节综述的更广评估生态的一部分)上做基准测试,将把该架构对照既有基线加以验证并定位具体改进空间。Terminal-Bench 发现前沿代理任务解决率不足 65%,LongCLI-Bench 观察到长时程任务通过率低于 20%,都暗示上下文管理与多步推理仍有大幅改进余地。
自适应资源分配。当前参数——70% 压缩阈值、3 次轻推尝试、6 个思考深度级别——是全局固定的。依据任务复杂度、当前上下文压力与错误历史动态调整的自适应方法,可以按任务优化成本—质量—延迟三角,而非依赖一刀切的常数。例如,一个简单的调试任务应完全跳过思考阶段,而一次复杂的架构重构可能受益于更深的深思与更保守的压缩策略。
扩展记忆管线。ACE playbook 目前按项目运作,带有效性评分与语义检索。跨项目知识迁移——在一个仓库学到的经验指导相似项目中的行为——区分通用编程启发式与项目专属惯例的层次化条目组织,以及对不确定条目选择性请求用户反馈的主动学习,都能显著提升代理随时间积累与应用经验的能力。
面向记忆的结构化代码表示。当前记忆管线把经验存为扁平的自然语言条目。更丰富的表示——捕获模块间关系的代码依赖图、跟踪函数交互的调用图、编码领域概念的项目级本体——可以支持更精确的检索与推理。把图结构化的代码理解与不仅跨会话而且跨整个项目生命周期的长期持久记忆结合,将让代理对代码库建立深度的演化模型,而非积累孤立的观察。
超越层次委托的多代理协调。当前子代理在主代理协调下独立执行,仅经完成标记通信。更丰富的协调模式——子代理间的点对点通信、面向协作解题的共享黑板架构、解决工具结果冲突的协商协议——可以支持更复杂的工作流,如并发的代码评审与实现,或带结果综合的并行探索。
学习式系统提醒优化。24 模板的提醒目录及其注入时机是基于观察到的失效模式手工设计的。经注意力衰减指标上的强化学习、基于对话动态的学习式注入时机、或以代理状态为条件的自适应模板选择,自动发现有效提醒模式,可以在减轻设计维护提醒模板的人工负担的同时提升轻推效果。
CLI–IDE 混合集成。双接口架构证明一个共享回调协议可以服务根本不同的前端。把它扩展到 IDE 插件——同一套代理逻辑同时驱动终端工作流与富编辑器集成——将服务那些想在终端自主性之外获得可视便利(行内 diff、符号导航、测试结果浮层)的用户,而无需跨环境复制代理逻辑。
构建高效的代理式编码系统需要在相互竞争的关注点之间导航:能力与复杂度、自主与安全、通用性与 token 效率。设计空间充满权衡,没有一个选择处处占优。我们希望本文记录的架构模式、工程经验与对成败的坦率反思,能帮助未来的代理系统构建者在这些选择面前做出更明智的决策。
参考文献
附录 A 完整工具目录
表 1 提供 OpenDev 全部内置工具按处理器类别的完整目录。每个工具在正文(第 2.4 节)中均有描述;本附录作为快速参考。除这些内置工具外,任意数量的外部工具都可经 MCP 动态发现(第 2.4.7 节)。
| 类别 | 工具 | 描述 |
|---|---|---|
| File Ops | read_file† | 读取文件内容,带行号输出与可选 offset/limit |
| write_file | 创建新文件(拒绝覆写;引导改用 edit_file) | |
| edit_file | 经 9 趟模糊匹配链应用定点编辑 | |
| list_files† | 目录列举与基于 glob 的文件搜索 | |
| search† | 双模式搜索:正则(ripgrep)或结构化(ast-grep) | |
| Process | run_command | 执行 shell 命令,服务器自动转后台 |
| list_processes† | 列出被跟踪的后台任务及状态与运行时长 | |
| get_process_output† | 取回后台任务的最后 100 行 | |
| kill_process | 终止运行中的任务(SIGTERM | |
| Web | fetch_url† | 浏览器引擎 Web 抓取,支持深度爬取 |
| web_search† | 经 DuckDuckGo 的尊重隐私网络搜索 | |
| capture_web_screenshot† | 经 Playwright 无头浏览器的整页截图 | |
| open_browser† | 在系统默认浏览器中打开 URL 或本地文件 | |
| Symbols (LSP) | find_symbol† | 查找符号定义,支持通配符匹配 |
| find_referencing_symbols† | 跨文件查找符号的全部引用 | |
| rename_symbol | 跨全部引用重命名符号 | |
| replace_symbol_body | 替换函数/方法正文并保留签名 | |
| insert_before_symbol | 在符号定义之前插入代码 | |
| insert_after_symbol | 在符号定义之后插入代码 | |
| Visual | capture_screenshot† | 捕获桌面截图,可选区域 |
| analyze_image† | 经视觉语言模型分析图像 | |
| read_pdf† | 从 PDF 文件提取文本与元数据 | |
| Notebooks | notebook_edit | 创建、修改或删除 Jupyter notebook 单元 |
| Task Mgmt | write_todos | 创建或替换任务列表 |
| update_todo | 按 ID 更新任务(强制单一「doing」约束) | |
| complete_todo | 把任务标记为完成,可选完成日志 | |
| list_todos† | 按状态优先级列出全部任务 | |
| User Input | ask_user† | 向用户呈现结构化多选题 |
| Discovery | search_tools† | 按关键词搜索 MCP 工具,带打分排序 |
| Batch | batch_tool | 以并行或串行模式执行多个工具 |
| Subagents | spawn_subagent | 启动带过滤工具注册表的隔离子代理 |
| get_subagent_output† | 取回后台子代理的输出 | |
| Skills | invoke_skill† | 从 skill 文件按需加载领域专长 |
| Planning | present_plan | 呈递计划供用户批准(approve/modify) |
| Completion | task_complete |
表 1:OpenDev 内置工具完整目录(按处理器类别组织)。标
附录 B LSP 语言服务器矩阵
表 2 列出经 LSP 集成支持的全部编程语言及对应语言服务器。系统支持大量标准语言外加若干实验性服务器,全部定义于 ls_config.py。
| 语言 | 服务器 | 语言 | 服务器 |
|---|---|---|---|
| Python | Pyright | Perl | Perl::LanguageServer |
| TypeScript/JS | tsserver | Clojure | clojure-lsp |
| Rust | rust-analyzer | Elm | elm-language-server |
| Go | gopls | Terraform | terraform-ls |
| Java | Eclipse JDT LS | Bash | bash-language-server |
| C/C++ | clangd | Nix | nixd |
| C# | csharp-ls | Erlang | erlang_ls |
| Ruby | Ruby LSP | AL | AL Language Extension |
| PHP | Intelephense | Rego | Regal |
| Swift | SourceKit-LSP | Fortran | fortls |
| Kotlin | kotlin-language-server | OCaml | ocamllsp |
| Lua | lua-language-server | Markdown† | Marksman |
| Elixir | ElixirLS | YAML† | yaml-language-server |
| Haskell | haskell-language-server | Dart | dart analyze |
| Scala | Metals | Zig | zls |
| Julia | LanguageServer.jl | R |
表 2:OpenDev 支持的 LSP 语言服务器。标
附录 C 模块化系统提示词组装
本附录记录 OpenDev PromptComposer(第 2.3.1 节)使用的完整提示词章节注册表。正文描述了过滤—排序—加载—拼接管线及其理据;本附录提供全部章节、其条件与角色的完整清单。每个模板的逐字内容复现于附录 K。
C.1 主代理提示词章节
默认行动模式代理经 create_default_composer() 注册其章节。表 3 列出每个章节及其激活条件、对 Anthropic 提示缓存的 cacheability,以及简要摘要。
| 章节 | 条件 | 缓存 | 摘要 |
|---|---|---|---|
| mode-awareness | always | ✓ | 指导对非平凡任务使用规划器子代理 |
| security-policy | always | ✓ | 经授权的安全测试边界 |
| tone-and-style | always | ✓ | 沟通标准:简洁、直接、无表情符号 |
| no-time-estimates | always | ✓ | 绝不提供工期估计 |
| interaction-pattern | always | ✓ | ReAct 循环:Think |
| available-tools | always | ✓ | 工具类别总览与描述 |
| tool-selection | always | ✓ | 何时用直接工具 vs. 子代理 |
| code-quality | always | ✓ | 遵循惯例、最小改动、不越范围 |
| action-safety | always | ✓ | 对破坏性/不可逆动作的风险评估 |
| read-before-edit | always | ✓ | 编辑前必须先读文件 |
| error-recovery | always | ✓ | 错误模式 |
| subagent-guide | has_subagents | ✓ | 子代理参考:8 种类型及何时/如何使用 |
| git-workflow | in_git_repo | ✓ | Git 安全协议、commit/PR 工作流 |
| task-tracking | todo_enabled | ✓ | Todo 生命周期:create |
| provider-openai | openai | ✓ | 函数调用、推理模型、视觉格式 |
| provider-anthropic | anthropic | ✓ | Tool_use 块、延伸思考、缓存控制 |
| provider-fireworks | fireworks | ✓ | 较小上下文、快速推理、无思考 |
| output-awareness | always | ✓ | 工具输出截断上限与分页 |
| scratchpad | session_id set | ✗ | 会话专属草稿目录路径 |
| code-references | always | ✓ | 用于导航的 file_path:line_number 格式 |
| reminders-note | always | ✗ |
表 3:主代理提示词章节完整注册表(21 个章节)。条件:always = 无条件;其余求值某个运行时上下文谓词。缓存:该章节是否纳入 Anthropic 提示缓存的稳定(可缓存)分区。
C.2 思考模式提示词章节
思考模式代理经 create_thinking_composer() 只注册 4 个章节,刻意省去工具使用与代码质量指引,避免让无工具推理偏向过早行动。
| 章节 | 摘要 |
|---|---|
| thinking-available-tools | 工具感知而不带调用压力 |
| thinking-subagent-guide | 委托推理:何时委托、委托哪个子代理 |
| thinking-code-references | 用于导航的代码引用格式 |
| thinking-output-rules |
表 4:思考模式提示词章节(4 个)。全部无条件且可缓存。
C.3 专门模板
五个独立模板服务于常规章节注册表之外的特定角色。它们由各自子系统直接加载,而非经 PromptComposer 自动注册。
| 模板 | 角色 | 关键输出 |
|---|---|---|
| compaction.md | 对话压缩器 | 结构化摘要($\leq$800 词)附工件索引 |
| critique.md | 推理批评器 | 对思考轨迹的可操作反馈($\leq$100 词) |
| init.md | 会话初始化器 | 经 Code-Explorer 生成 OPENDEV.md |
| main.md | 核心身份包装器 | 资深工程师角色,完整工具访问 |
| thinking.md | 思考包装器 |
表 5:专门提示模板(不自动注册)。
C.4 组装机制
组装管线按如下方式运作:
过滤
面向提示缓存的两段式组装:compose_two_part() 方法把章节划分为稳定(可缓存)与动态两部分。对 Anthropic 的 API,稳定部分获得 cache_control 头,多轮会话中缓存部分约省 88% 成本。通常 21 个章节中 19 个稳定;只有 scratchpad 与 reminders-note 是动态的。
模式专属组装器:工厂函数 create_composer(templates_dir, mode) 返回相应组装器:"system/main" 产出 21 章节的行动组装器;"system/thinking" 产出 4 章节的思考组装器。规划模式使用为只读探索优化的独立模板。
变量替换:模板使用由 PromptRenderer 在渲染时解析的
两级回退:若某个章节文件缺失,组装器跳过它并带缩减提示词继续。若模块化组装整体失败(如模板目录缺失),构建器回退到单体核心模板,保证部分部署条件下代理仍能启动。
附录 D 编辑工具模糊匹配链
edit_file 工具(第 2.4.2 节)实现带九个替换器类的责任链模式,每个类处理 LLM 给定的 old_content 与实际文件内容之间一类特定不匹配。链条首次匹配即短路,精确匹配因此不从模糊趟次承担开销。每个替换器返回原文件中实际找到的子串(而非搜索查询),保留文件原有格式。
Simple:精确字符串匹配(基线)。
Line-trimmed:比较前逐行剥离行尾空白。
Block-anchor:以首末行为锚点;多候选匹配时以 0.3 相似度阈值对中间区域用 SequenceMatcher 打分。
Whitespace-normalized:把所有空白连续段折叠为单空格。
Indentation-flexible:忽略全部前导空白,跳过空行。
Escape-normalized:反转义常见序列(\n、\t、\)。
Trimmed-boundary:先尝试修剪过的内容;发现部分匹配时扩展到完整行边界。
Context-aware:以第一个与最后一个非空行为锚点,以 0.5 相似度阈值对全部候选区域打分。
Multi-occurrence:最后手段,对所有出现位置做逐行修剪后的精确匹配。
附录 E Shell 执行管线
Shell 执行管线(第 2.4.3 节)对每次 run_command 调用经六个阶段处理,如图 17 所示。
E.1 六阶段管线细节
安全门。任何命令执行前运行三项检查:(a) 权限配置判断该命令类别是否需要审批;(b) 允许命令匹配对照用户配置的安全模式检查;(c) 危险模式拦截以不可覆盖的方式拒绝灾难性操作(rm -rf /、sudo、fork 炸弹、curl|bash 管道链、dd 写设备文件)。
命令准备。已知包管理器(npm init、npx)的交互提示经前置 yes | 自动确认。Python 命令收到 PYTHONUNBUFFERED=1 以防输出缓冲破坏实时流式。
服务器检测。对 16 种服务器模式(表 6)的正则匹配把命中的命令自动提升为后台模式,无视调用方设置。
执行分叉。后台命令在伪终端中派生(pty.openpty(),Popen 附属从属文件描述符)以获得能正确处理 ANSI 码、进度条与交互程序的终端仿真输出。前台命令用 subprocess.Popen 加管道与 start_new_session=True 做进程组隔离,确保杀命令时杀掉全部子进程。
输出管理。输出上限 30,000 字符,用头尾截断(溢出时保留前 10,000 + 后 10,000)。实时流式经回调把输出送达 UI。select.select() 以 100ms 间隔轮询,在响应性与 CPU 开销之间平衡。
超时与中断。空闲超时在 60 秒无输出后杀命令。绝对超时把执行上限定在 600 秒。InterruptToken(每用户查询共享)在每个轮询周期被检查;触发时处理器经 os.killpg() 杀掉整个进程组。
E.2 服务器检测模式
表 6 列出用于把命令自动提升为后台模式的 16 个正则模式。全部模式以 re.IGNORECASE 匹配。
| # | 正则模式 | 框架 |
|---|---|---|
| 1 | flask\s+run | Flask |
| 2 | python.*app.py | Generic Python app |
| 3 | python.*manage.py\s+runserver | Django (manage.py) |
| 4 | django.*runserver | Django (direct) |
| 5 | uvicorn | Uvicorn (ASGI) |
| 6 | gunicorn | Gunicorn (WSGI) |
| 7 | python.*-m\s+http.server | Python http.server |
| 8 | npm\s+(run\s+)?(start|dev|serve) | npm |
| 9 | yarn\s+(run\s+)?(start|dev|serve) | Yarn |
| 10 | node.*server | Node.js |
| 11 | nodemon | Nodemon |
| 12 | next\s+(dev|start) | Next.js |
| 13 | rails\s+server | Ruby on Rails |
| 14 | php.*artisan\s+serve | Laravel |
| 15 | hugo\s+server | Hugo |
| 16 | jekyll\s+serve |
表 6:用于自动转后台的服务器检测模式。
附录 F 系统提醒目录
本附录提供第 2.3.4 节所述 24 个命名系统提醒按类别的完整目录,以及每个 ReAct 迭代内的 9 步注入时机。
F.1 提醒类别
24 个提醒组织为六个功能类别:
阶段控制(4 个提醒):管理思考/行动阶段转移。把思考轨迹注入行动阶段上下文;控制代理应深谋远虑还是直接行动。
任务生命周期(5 个提醒):引导多步工作流中的阶段转移。子代理返回后,轻推主代理综合结果。计划获批后,以明确的工作流指令复述计划与 todo。会话恢复时,引用既有计划文件。
Todo 强制(2 个提醒):拦截过早完成。代理带未完成 todo 调用 task_complete 时,拒绝调用并列出剩余条目。全部 todo 完成时,发出收尾信号。每次运行最多轻推 2 次。
错误恢复(8 个提醒):一条通用轻推加六条按错误分类(权限、文件未找到、语法、限流、超时、编辑不匹配)选择的类型专属轻推,外加一条 Docker 专属轻推。每个错误序列最多尝试 3 次。
行为(5 个提醒):纠正可观察的反模式。连续 5 次以上只读工具调用后,打断探索螺旋。用户拒绝工具调用后,防止重试。完成消息为空时,请求简短结果摘要。到达迭代安全上限时,强制摘要。
JSON 重试(2 个提醒):记忆系统 Reflector 与 Curator 组件 JSON 输出解析失败时的专门重试提示。
F.2 注入时机
提醒由 ReAct 执行器在每次迭代内以严格的 9 步次序注入:
自动压缩检查(上下文压力评估)。
中断检查(用户取消)。
思考阶段,可选地把轨迹注入行动上下文。
子代理完成信号(若有子代理返回结果)。
排空 UI 线程消息(审批结果、用户输入)。
中断检查(LLM 调用前的第二道闸)。
行动阶段 LLM 调用。
响应分发:提醒按响应类型分流:
无工具调用路径:依次检查失败工具轻推、未完成 todo 轻推与空完成轻推。
有工具调用路径:工具执行后,检查计划获批信号、全部 todo 完成信号、工具被拒轻推与连续读取轻推。
会话持久化(自动保存)。
两个机制防止提醒退化为噪音:(1) 一次性标志保证某些提醒每次代理运行至多触发一次(plan_approved_signal_injected、all_todos_complete_nudged、completion_nudge_sent);(2) 尝试预算为可重复提醒设上限(MAX_TODO_NUDGES = 2,MAX_NUDGE_ATTEMPTS = 3)。
附录 G 子代理能力矩阵
表 7 记录完整的子代理注册表。每个子代理收到限定于其领域的过滤工具集,防止范围蔓延并限制影响范围。默认情况下所有子代理以无限迭代预算运行;ask-user 子代理是特例,完全绕过 LLM 执行路径。
| 子代理 | 可用工具 | 用途 |
|---|---|---|
| Code-Explorer | read_file, search, list_files, find_symbol, find_referencing_symbols | 深度代码库探索、架构分析、模式发现 |
| Planner | 全部只读 + write_file, edit_file, spawn_subagent, ask_user, task_complete | 结合代码库分析与计划文件编写的实施规划 |
| PR-Reviewer | read_file, search, list_files, find_symbol, find_referencing_symbols, run_command | 拉取请求代码评审、diff 分析、合并前审查 |
| Security-Reviewer | read_file, search, list_files, find_symbol, find_referencing_symbols, run_command | 安全审计、漏洞评估、严重度/置信度打分 |
| Web-Clone | capture_web_screenshot, analyze_image, write_file, read_file, run_command, list_files | 可视化网站分析与 UI 复刻 |
| Web-Generator | write_file, edit_file, run_command, list_files, read_file | 按规格创建 Web 应用(React/TypeScript/Tailwind) |
| Project-Init | read_file, search, list_files, run_command, write_file | 从代码库分析生成 OPENDEV.md 项目指令文件 |
| Ask-User | (无;仅 UI) |
表 7:子代理类型、工具访问与用途。工具数量反映过滤后的注册表;主代理可访问全部 35 个内置工具。
附录 H 配置 Schema
表 8 描述 OpenDev AppConfig 模型中的关键配置字段。
| 字段 | 类型 | 描述 |
|---|---|---|
| model | str | LLM 模型标识符 |
| provider | str | API 提供商(openai、azure 等) |
| max_context_tokens | int | 最大上下文窗口尺寸 |
| temperature | float | LLM 采样温度 |
| max_tokens | int | 最大响应 token 数 |
| thinking_model | str | 思考阶段所用模型 |
| thinking_provider | str | 思考模型提供商 |
| auto_approve | bool | 跳过审批对话框 |
| web_search_provider | str | 网络搜索后端 |
| mcp_servers | dict | MCP 服务器配置 |
| blocked_commands | list |
表 8:OpenDev 中的关键配置字段。
附录 I 实现常量
本节记录关键实现常量及其理据。
| 常量 | 值 | 理据 |
|---|---|---|
| 压缩阶段 | 70/80/90/99% | 四档渐进阈值:警告、掩蔽、激进掩蔽、全量压缩 |
| 最大撤销历史 | 50 ops | 有界增长防止长会话 OOM |
| 最大轻推尝试 | 3 | 平衡恢复机会与推进 |
| 死循环阈值 | 3 repeats | 滑动窗口内同一 (tool, args) 指纹 3$\times$ 触发警告 |
| 死循环窗口 | 20 calls | 近期工具调用指纹的滑动窗口 |
| 思考级别 | 4 (OFF–HIGH) | OFF、LOW、MEDIUM、HIGH(含自我批评) |
| 编辑模糊趟数 | 9 | 责任链(附录 D) |
| 工具输出卸载 | 8,000 chars | 写入草稿文件;保留 500 字符预览 |
| 观察掩蔽 | 6/3 recent | 80%/90% 压缩时全保真输出数量 |
| 子代理迭代上限 | 15 | 既约束探索又允许充分调查 |
| 最大并发工具 | 5 | 平衡并行开销与利用率 |
| 会话 ID 长度 | 8 chars | 人类可读,628 个唯一值 |
| 提供商缓存 TTL | 24 hours | 平衡陈旧性与网络调用 |
| 摘要再生 | Every 5 msgs | 摊薄成本,防止漂移累积 |
| 近期消息尾部 | 3–10 msgs | 依对话长度自适应 |
| 工具结果最大长度 | 300 tokens |
表 9:OpenDev 实现常量及其依据。
附录 J CLI 命令参考
常用命令行选项与交互命令:
opendev - 启动交互式终端 UI
opendev -p "prompt" - 非交互式单提示执行
opendev --continue - 恢复最近的会话
opendev --working-dir /path - 设置项目上下文
opendev run ui - 启动 Web UI
/mode - 在普通与规划模式间切换
/undo - 撤销近期文件操作
/clear - 清除对话历史
/sessions - 列出可用会话
/thinking - 配置思考级别
/exit - 退出会话
opendev mcp list - 列出已配置的 MCP 服务器
opendev mcp add <name> <command> - 添加 MCP 服务器
opendev mcp enable <name> - 启用 MCP 服务器
opendev mcp disable <name> - 停用 MCP 服务器
Shift+Tab - 切换普通/规划模式
Ctrl+C - 中断代理执行
Ctrl+L - 清屏
/ + 文本 - 触发命令自动补全
附录 K 完整系统提示模板
本附录逐字复现 OpenDev 使用的每个系统提示模板。每个模板是存放在 templates/system/ 之下的 Markdown 文件,由 PromptComposer 剥去 HTML frontmatter 后加载(附录 C)。此处展示的内容正是 LLM 作为系统提示词一部分收到的内容。模板按角色分组:核心身份(第 K.1 节)、按优先级带排序的 21 个主代理章节(第 K.2 节)、4 个思考模式章节(第 K.3 节),以及 3 个专门独立模板(第 K.4 节)。
K.1 核心身份模板
核心身份模板确立代理的角色设定,作为包装器在模块化章节追加之前加载。
K.2 主代理提示词章节
以下 21 个章节由 create_default_composer() 注册,并经第 C.4 节描述的过滤—排序—加载—拼接管线组装。此处按优先级顺序呈现(优先级数字更小 = 在组装后的提示词中更早出现)。
K.2.1 核心身份与策略(Priority 10–30)
K.2.2 交互与工具指引(Priority 40–50)
K.2.3 代码质量与安全(Priority 55–65)
K.2.4 条件章节(Priority 70–80)
这些章节只在其运行时条件求值为 True 时被包含(例如项目是 Git 仓库、todo 跟踪已启用,或正在使用特定模型提供商)。
K.2.5 上下文感知(Priority 85–95)
K.3 思考模式模板
思考模式使用独立的提示词组装:一个独立包装模板加 4 个聚焦章节。它们刻意保持极简,以避免让无工具推理偏向过早行动。
K.4 专门独立模板
这些模板由各自子系统直接加载,而非经 PromptComposer 自动注册管线。
- [1] Anthropic. Model context protocol. https://modelcontextprotocol.io, 2024. Accessed: 2025-01-15.
- [2] Anthropic. Claude code: An agentic coding tool. https://docs.anthropic.com/en/docs/agents-and-tools/claude-code/overview, 2025. Accessed: 2025-01-15.
- [3] Anthropic. Effective context engineering for ai agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents, 2025.
- [4] Anysphere. Cursor: The ai code editor. https://cursor.com, 2025.
- [5] Akari Asai, Zeqiu Wu, Yizhong Wang, Avirup Sil, and Hannaneh Hajishirzi. Self-rag: Learning to retrieve, generate, and critique through self-reflection. International Conference on Learning Representations, 2024.
- [6] Jacob Austin et al. Program synthesis with large language models. arXiv preprint arXiv:2108.07732, 2021.
- [7] Alan Baddeley. Working memory. Science, 255(5044):556–559, 1992.
- [8] Maciej Besta, Nils Blach, Aleš Kubíček, Robert Gerstenberger, Lukas Gianinazzi, Joanna Gajda, Tomasz Lehmann, Michal Podstawski, Hubert Niewiadomski, Piotr Nyczyk, and Torsten Hoefler. Graph of thoughts: Solving elaborate problems with large language models. AAAI Conference on Artificial Intelligence, 2024.
- [9] Adam Blackington. BMAD-METHOD: Breakthrough method for agile AI-driven development. https://github.com/bmad-code-org/BMAD-METHOD, 2025.
- [10] Block. Goose: An open-source ai agent. https://github.com/block/goose, 2025.
- [11] Nghi D. Q. Bui, Hung Le, Yue Wang, Junnan Li, Akhilesh Deepak Gotmare, and Steven C. H. Hoi. Codetf: One-stop transformer library for state-of-the-art code llm. arXiv preprint arXiv:2306.00029, 2023.
- [12] Jun Shern Chan, Neil Chowdhury, Oliver Jaffe, James Aung, Dane Sherburn, Evan Mays, Giulio Starace, Kevin Liu, Leon Maksin, Tejal Patwardhan, et al. MLE-bench: Evaluating machine learning agents on machine learning engineering. In The Thirteenth International Conference on Learning Representations, 2025.
- [13] Charm. Crush: An agentic coding tool for the terminal. https://github.com/charmbracelet/crush, 2025.
- [14] et al. Chen. Coder: Issue resolving with multi-agent and task graphs. arXiv preprint arXiv:2406.01304, 2024.
- [15] Mark Chen et al. Evaluating large language models trained on code. arXiv preprint arXiv:2107.03374, 2021.
- [16] Yuhao Chen, Xin Zhang, Tao Wang, et al. Specrover: Specification-guided patch generation. arXiv preprint, 2024.
- [17] Jeff Clune, Kenneth Stanley, et al. Diverse agent populations for more robust exploration. arXiv preprint, 2024.
- [18] Cognition. Introducing devin, the first ai software engineer. https://cognition.ai/blog/introducing-devin, 2024.
- [19] OpenCode Contributors. Opencode: Ai-powered terminal assistant. https://github.com/opencode-ai/opencode, 2025.
- [20] Chunyuan Deng, Yilun Zhao, Xiangru Tang, Mark Gerstein, and Arman Cohan. Investigating data contamination in modern benchmarks for large language models. NAACL, pages 8706–8719, 2024.
- [21] Xiang Deng, Jeff Da, Edwin Pan, Yannis Yiming He, Charles Ide, Kanak Garg, Niklas Lauffer, et al. Swe-bench pro: Can ai agents solve long-horizon software engineering tasks? arXiv preprint arXiv:2509.16941, 2025.
- [22] Jingzhe Ding, Shengda Long, Changxin Pu, Huan Zhou, Hongwan Gao, Xiang Gao, Chao He, Yue Hou, Fei Hu, Zhaojian Li, et al. Nl2repo-bench: Towards long-horizon repository generation evaluation of coding agents, 2025.
- [23] Xueying Du, Mingwei Liu, Kaixin Wang, Hanlin Wang, Junwei Liu, Yixuan Chen, Jiayi Feng, Chaofeng Sha, Xin Peng, and Yiling Lou. Evaluating large language models in class-level code generation. In Proceedings of the 46th IEEE/ACM International Conference on Software Engineering (ICSE 2024), pages 81:1–81:13. ACM, 2024.
- [24] Aleksandra Eliseeva, Alexander Kovrigin, Ilia Kholkin, Egor Bogomolov, and Yaroslav Zharov. Envbench: A benchmark for automated environment setup. In ICLR 2025 Third Workshop on Deep Learning for Code, 2025.
- [25] Yukang Feng, Jianwen Sun, Zelai Yang, et al. Longcli-bench: A preliminary benchmark and study for long-horizon agentic programming in command-line interfaces. arXiv preprint, 2025.
- [26] Fission AI. OpenSpec: Spec-driven development framework. https://github.com/Fission-AI/OpenSpec, 2025.
- [27] Luyu Gao et al. Pal: Program-aided language models. In ICML, 2023.
- [28] Paul Gauthier. Aider: Ai pair programming in your terminal. https://aider.chat, 2024. Accessed: 2025-01-15.
- [29] Tao Ge, Jing Hu, Xun Wang, Si-Qing Chen, and Furu Wei. In-context autoencoder for context compression in a large language model. International Conference on Learning Representations, 2024.
- [30] GitHub. Github copilot: Meet the new coding agent. https://github.blog/news-insights/product-news/github-copilot-meet-the-new-coding-agent/, 2025.
- [31] GitHub. Spec kit: Toolkit for spec-driven development. https://github.com/github/spec-kit, 2025.
- [32] Google. Gemini cli. https://github.com/google-gemini/gemini-cli, 2025.
- [33] Daya Guo et al. Deepseek-coder: When the large language model meets programming. arXiv preprint arXiv:2401.14196, 2024.
- [34] Bernal Jimenez Gutierrez, Yiheng Shu, Yu Gu, Michihiro Yasunaga, and Yu Su. Hipporag: Neurobiologically inspired long-term memory for large language models. Advances in Neural Information Processing Systems, 37, 2024.
- [35] Ahmed E. Hassan, Hao Li, Dayi Lin, Bram Adams, Tse-Hsun Chen, Yutaro Kashiwa, and Dong Qiu. Agentic software engineering, foundational pillars and a research roadmap. arXiv preprint arXiv:2509.06216, 2025.
- [36] Wenqi He, Zonghai Chen, Xianwei Li, et al. Ehragent: Code empowers large language models for few-shot complex tabular reasoning on electronic health records. arXiv preprint arXiv:2401.07128, 2024.
- [37] Dan Hendrycks, Steven Basart, Saurav Kadavath, Mantas Mazeika, Akul Arora, Ethan Guo, Collin Burns, Samir Puranik, Horace He, and Dawn Song. Measuring coding challenge competence with apps. arXiv preprint arXiv:2105.09938, 2021.
- [38] Yuyang Hu, Shichun Liu, Yanwei Yue, Guibin Zhang, Boyang Liu, Fangyi Zhu, Jiahang Lin, Honglin Guo, Shihan Dou, Zhiheng Xi, et al. Memory in the age of ai agents. arXiv preprint arXiv:2512.13564, 2025.
- [39] Qishuo Hua, Lyumanshan Ye, Dayuan Fu, Yang Xiao, Xiaojie Cai, Yunze Wu, Jifan Lin, Junfei Wang, and Pengfei Liu. Context engineering 2.0: The context of context engineering. arXiv preprint arXiv:2510.26493, 2025.
- [40] Carlos E Jimenez et al. Swe-bench: Can language models resolve real-world github issues? In ICLR, 2024.
- [41] Minki Kang, Wei-Ning Chen, Dongge Han, Huseyin A. Inan, Lukas Wutschitz, Yanzhi Chen, Robert Sim, and Saravan Rajmohan. Acon: Optimizing context compression for long-horizon llm agents. arXiv preprint arXiv:2510.00615, 2025.
- [42] Thomas Kwa, Ben West, Joel Becker, Amy Deng, Katharyn Garcia, Max Hasin, Sami Jawhar, Megan Kinniment, Nate Rush, Sydney von Arx, et al. Measuring ai ability to complete long tasks. arXiv preprint arXiv:2503.14499, 2025.
- [43] Thomas Kwa, Ben West, Joel Becker, Amy Deng, Katharyn Garcia, Max Hasin, Sami Jawhar, Megan Kinniment, Nate Rush, Sydney von Arx, et al. Measuring ai ability to complete long tasks. arXiv preprint arXiv:2503.14499, 2025.
- [44] Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, Naman Goyal, Heinrich Küttler, Mike Lewis, Wen-tau Yih, Tim Rocktäschel, Sebastian Riedel, and Douwe Kiela. Retrieval-augmented generation for knowledge-intensive nlp tasks. In NeurIPS, 2020.
- [45] Bowen Li, Wenhan Wu, Ziwei Tang, Lin Shi, John Yang, Jinyang Li, Shunyu Yao, Chen Qian, Binyuan Hui, Qicheng Zhang, et al. Prompting large language models to tackle the full software development lifecycle: A case study. In Proceedings of the 31st International Conference on Computational Linguistics, pages 7511–7531, Abu Dhabi, UAE, 2025. Association for Computational Linguistics.
- [46] Caihua Li et al. Advances and frontiers of llm-based issue resolution in software engineering: A comprehensive survey. arXiv preprint, 2025.
- [47] Caihua Li et al. From code foundation models to agents and applications, a comprehensive survey and practical guide to code intelligence. arXiv preprint, 2025.
- [48] Raymond Li et al. Starcoder: May the source be with you! arXiv preprint arXiv:2305.06161, 2023.
- [49] Wei Li, Xin Zhang, Zhongxin Guo, Shaoguang Mao, Wen Luo, Guangyue Peng, Yangyu Huang, Houfeng Wang, and Scarlett Li. Fea-bench: A benchmark for evaluating repository-level code generation for feature implementation. arXiv preprint arXiv:2503.06680, 2025.
- [50] Yujia Li, David Choi, Junyoung Chung, Nate Kushman, Julian Schrittwieser, Rémi Leblond, Tom Eccles, James Keeling, Felix Gimeno, Agustin Dal Lago, et al. Competition-level code generation with alphacode. Science, 378(6624):1092–1097, 2022.
- [51] Yuntong Li, Yanjie Zhou, Zheng Liu, et al. Aegis: Automated environment setup for bug reproduction. arXiv preprint, 2024.
- [52] Jacky Liang, Wenlong Huang, Fei Xia, Peng Xu, Karol Hausman, Brian Ichter, Pete Florence, and Andy Zeng. Code as policies: Language model programs for embodied control. ICRA, 2023.
- [53] Hunter Lightman, Vineet Kosaraju, Yura Burda, Harri Edwards, Bowen Baker, Teddy Lee, Jan Leike, John Schulman, Ilya Sutskever, and Karl Cobbe. Let’s verify step by step. arXiv preprint arXiv:2305.20050, 2023.
- [54] Tianyu Liu, Daoguang Zan, Bei Chen, et al. Reasoning bank: Learning from trajectories for program repair. arXiv preprint, 2024.
- [55] Yuchen Liu, Tianyi Zhang, Yiming Wang, et al. Efficient evaluation of llm agents: Cost, latency, and token consumption. arXiv preprint, 2024.
- [56] Lingrui Mei, Jiayu Yao, Yuyao Ge, Yiwei Wang, Baolong Bi, Yujun Cai, Jiazhi Liu, Mingyu Li, Zhong-Zhi Li, Duzhen Zhang, et al. A survey of context engineering for large language models. arXiv preprint arXiv:2507.13334, 2025.
- [57] Mike A. Merrill, Alexander G. Shaw, Nicholas Carlini, et al. Terminal-bench: Benchmarking agents on hard, realistic tasks in command line interfaces. arXiv preprint, 2025.
- [58] Microsoft. Language server protocol specification. https://microsoft.github.io/language-server-protocol/, 2016. Accessed: 2025-01-15.
- [59] Samuel Miserendino, Michele Wang, Tejal Patwardhan, and Johannes Heidecke. SWE-lancer: Can frontier LLMs earn $1 million from real-world freelance software engineering? In Forty-second International Conference on Machine Learning, 2025.
- [60] Niels Mündler, Mark Niklas Mueller, Jingxuan He, and Martin Vechev. SWT-bench: Testing and validating real-world bug-fixes with code agents. In The Thirty-eighth Annual Conference on Neural Information Processing Systems, 2024.
- [61] Deepak Nathani, Lovish Madaan, Nicholas Roberts, Nikolay Bashlykov, Ajay Menon, Vincent Moens, Mikhail Plekhanov, et al. MLGym: A new framework and benchmark for advancing AI research agents. In Second Conference on Language Modeling, 2025.
- [62] Isaac Ong, Amjad Almahairi, Vincent Wu, Wei-Lin Chiang, Tianhao Wu, Joseph E Gonzalez, M Waleed Kadous, and Ion Stoica. Routellm: Learning to route llms with preference data. arXiv preprint arXiv:2406.18665, 2024.
- [63] Open Interpreter. Open interpreter. https://github.com/OpenInterpreter/open-interpreter, 2023. Accessed: 2025-01-15.
- [64] OpenAI. Introducing swe-bench verified. https://openai.com/index/introducing-swe-bench-verified/, 2024.
- [65] OpenAI. Introducing codex. https://openai.com/index/introducing-codex/, 2025.
- [66] Charles Packer et al. Memgpt: Towards llms as operating systems. arXiv preprint arXiv:2310.08560, 2023.
- [67] Shishir G. Patil, Huanzhi Mao, Charlie Cheng-Jie Ji, Fanjia Yan, Vishnu Suresh, Ion Stoica, and Joseph E. Gonzalez. The berkeley function calling leaderboard (bfcl): From tool use to agentic evaluation of large language models. In Forty-second International Conference on Machine Learning, 2025.
- [68] Minh VT Pham, Huy N Phan, Hoang N Phan, Cuong Le Chi, Tien N Nguyen, and Nghi DQ Bui. Swe-synth: Synthesizing verifiable bug-fix data to enable large language models in resolving real-world bugs. arXiv preprint arXiv:2504.14757, 2025.
- [69] Huy Nhat Phan, Tien N Nguyen, Phong X Nguyen, and Nghi DQ Bui. Hyperagent: Generalist software engineering agents to solve coding tasks at scale. arXiv preprint arXiv:2409.16299, 2024.
- [70] Ofir Press, Muru Zhang, Sewon Min, Ludwig Schmidt, Noah A. Smith, and Mike Lewis. Measuring and narrowing the compositionality gap in language models. arXiv preprint arXiv:2210.03350, 2022.
- [71] Bo Qiao et al. Taskweaver: A code-first agent framework. arXiv preprint arXiv:2311.17541, 2023.
- [72] Baptiste Rozière et al. Code llama: Open foundation models for code. arXiv preprint arXiv:2308.12950, 2023.
- [73] Parth Sarthi, Salman Abdullah, Aditi Tuli, Shubh Khanna, Anna Goldie, and Christopher D. Manning. Raptor: Recursive abstractive processing for tree-organized retrieval. International Conference on Learning Representations, 2024.
- [74] Noah Shinn, Federico Cassano, Ashwin Gopinath, Karthik Narasimhan, and Shunyu Yao. Reflexion: Language agents with verbal reinforcement learning. Advances in Neural Information Processing Systems, 36:8634–8652, 2023.
- [75] Zachary S Siegel, Sayash Kapoor, Nitya Nadgir, Benedikt Stroebl, and Arvind Narayanan. CORE-bench: Fostering the credibility of published research through a computational reproducibility agent benchmark. Transactions on Machine Learning Research, 2024.
- [76] Weiwei Sun, Miao Lu, Zhan Ling, Kang Liu, Xuesong Yao, Yiming Yang, and Jiecao Chen. Scaling long-horizon llm agent via context-folding. arXiv preprint arXiv:2510.11967, 2025.
- [77] Zhiyu Tang, Yue Wang, Xu Zhou, Xin Eric Wang, et al. Codeagents: Interactive code generation through multi-agent programming. arXiv preprint, 2024.
- [78] Wei Tao et al. Magis: Llm-based multi-agent framework for github issue resolution. arXiv preprint arXiv:2403.17927, 2024.
- [79] Minh VT Thai, Tue Le, Dung Nguyen Manh, Huy Phan Nhat, and Nghi DQ Bui. Swe-evo: Benchmarking coding agents in long-horizon software evolution scenarios. arXiv preprint arXiv:2512.18470, 2025.
- [80] Harsh Trivedi, Niranjan Balasubramanian, Tushar Khot, and Ashish Sabharwal. Interleaving retrieval with chain-of-thought reasoning for knowledge-intensive multi-step questions. arXiv preprint arXiv:2212.10509, 2022.
- [81] Guanzhi Wang et al. Voyager: An open-ended embodied agent with large language models. arXiv preprint arXiv:2305.16291, 2023.
- [82] Shuang Wang, Bowen Li, Yong Chen, et al. Issue2test: From issue reports to test cases. arXiv preprint, 2024.
- [83] Xingyao Wang et al. Executable code actions elicit better llm agents. arXiv preprint arXiv:2402.01030, 2024.
- [84] Xingyao Wang et al. Openhands: An open platform for ai software developers as generalist agents. arXiv preprint arXiv:2407.16741, 2024.
- [85] Yiming Wang, Jun Zhang, Yizhe Li, et al. Experience-driven monte carlo tree search. arXiv preprint, 2024.
- [86] Yiming Wang, Tianyi Zhang, Zhengyang Chen, et al. Codemonkeys: Massively parallel state machines for inference-time scaling. arXiv preprint, 2024.
- [87] Yue Wang, Hung Le, Akhilesh Deepak Gotmare, Nghi D. Q. Bui, Junnan Li, and Steven C. H. Hoi. Codet5+: Open code large language models for code understanding and generation. In Proceedings of the 2023 Conference on Empirical Methods in Natural Language Processing (EMNLP), 2023.
- [88] Tianxin Wei, Ting-Wei Li, Zhining Liu, Xuying Ning, Ze Yang, Jiaru Zou, Zhichen Zeng, Ruizhong Qiu, Xiao Lin, Dongqi Fu, et al. Agentic reasoning for large language models. arXiv preprint arXiv:2601.12538, 2026.
- [89] Chunqiu Steven Xia et al. Agentless: Demystifying llm-based software engineering agents. arXiv preprint arXiv:2407.01489, 2024.
- [90] Tianbao Xie, Danyang Zhang, Jixuan Chen, Xiaochuan Li, Siheng Zhao, Ruisheng Cao, Toh Jing Hua, Zhoujun Cheng, Dongchan Shin, Fangyu Lei, et al. OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments. In The Thirty-eight Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2024.
- [91] Benfeng Xu, Licheng Zhang, Zhendong Mao, Quan Wang, Hongtao Xie, and Yongdong Zhang. Curriculum learning for natural language understanding. ACL, 2020.
- [92] Binfeng Xu et al. Rewoo: Decoupling reasoning from observations for efficient augmented language models. arXiv preprint arXiv:2305.18323, 2023.
- [93] Cheng Xu, Shuhao Guan, Derek Greene, and M-Tahar Kechadi. Benchmark data contamination of large language models: A survey. arXiv preprint arXiv:2406.04244, 2024.
- [94] John Yang et al. Swe-agent: Agent-computer interfaces enable automated software engineering. arXiv preprint arXiv:2405.15793, 2024.
- [95] John Yang, Carlos E Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan, and Ofir Press. Swe-agent: Agent-computer interfaces enable automated software engineering. Advances in Neural Information Processing Systems, 37:50528–50652, 2024.
- [96] John Yang, Carlos E Jimenez, Alex L Zhang, Kilian Lieret, Joyce Yang, Xindi Wu, Ori Press, Niklas Muennighoff, Gabriel Synnaeve, Karthik R Narasimhan, et al. SWE-bench multimodal: Do AI systems generalize to visual software domains? In The Thirteenth International Conference on Learning Representations, 2025.
- [97] Shunyu Yao, Noah Shinn, Pedram Razavi, and Karthik R Narasimhan. {
}-bench: A benchmark for Tool-Agent-User interaction in real-world domains. In The Thirteenth International Conference on Learning Representations, 2025. - [98] Shunyu Yao, Dian Yu, Jeffrey Zhao, Izhak Shafran, Thomas L. Griffiths, Yuan Cao, and Karthik Narasimhan. Tree of thoughts: Deliberate problem solving with large language models. Advances in Neural Information Processing Systems, 36, 2023.
- [99] Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, and Yuan Cao. React: Synergizing reasoning and acting in language models. In International Conference on Learning Representations (ICLR), 2023.
- [100] Christine Ye, Sihan Yuan, Suchetha Cooray, Steven Dillmann, Ian L. V. Roque, Dalya Baron, Philipp Frank, Sergio Martin-Alvarez, et al. Replicationbench: Can ai agents replicate astrophysics research papers? arXiv preprint arXiv:2510.24591, 2025.
- [101] Haoran Ye, Xuning He, Vincent Arak, Haonan Dong, and Guojie Song. Meta context engineering via agentic skill evolution. arXiv preprint arXiv:2601.21557, 2026.
- [102] Justin Young. Effective harnesses for long-running agents. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents, 2025. Anthropic Engineering Blog.
- [103] Matei Zaharia, Omar Khattab, Lingjiao Chen, Jared Quincy Davis, Heather Miller, Chris Potts, James Zou, Michael Carbin, Jonathan Frankle, Naveen Rao, and Ali Ghodsi. The shift from models to compound ai systems. https://bair.berkeley.edu/blog/2024/02/18/compound-ai-systems/, 2024.
- [104] Daoguang Zan, Zhirong Huang, Wei Liu, Hanwu Chen, Shulin Xin, Linhao Zhang, Qi Liu, Aoyan Li, Lu Chen, Xiaojian Zhong, et al. Multi-swe-bench: A multilingual benchmark for issue resolving. arXiv preprint arXiv:2504.02605, 2025.
- [105] Genghan Zhang, Weixin Liang, Olivia Hsu, and Kunle Olukotun. Adaptive self-improvement llm agentic system for ml library development. arXiv preprint arXiv:2502.02534, 2025.
- [106] Lei Zhang, Weizheng Chen, Yuting Liu, et al. Experepair: Dual-memory architecture for autonomous program repair. arXiv preprint, 2024.
- [107] Qizheng Zhang, Changran Hu, Shubhangi Upasani, Boyuan Ma, Fenglu Hong, Vamsidhar Kamanuru, Jay Rainton, Chen Wu, Mengmeng Ji, Hanchen Li, et al. Agentic context engineering: Evolving contexts for self-improving language models. The Fourteenth International Conference on Learning Representations (ICLR), 2026.
- [108] Yuntong Zhang, Haifeng Ruan, Zhiyu Fan, and Abhik Roychoudhury. Autocoderover: Autonomous program improvement. In Proceedings of the 33rd ACM SIGSOFT International Symposium on Software Testing and Analysis, pages 1592–1604. ACM, 2024.
- [109] Yuting Zhang, Zhiyuan Fan, Wei Liu, et al. Otter: Generating failing tests from issue descriptions. arXiv preprint, 2024.
- [110] Lianmin Zheng, Wei-Lin Chiang, Ying Sheng, Siyuan Zhuang, Zhanghao Wu, Yonghao Zhuang, Zi Lin, Zhuohan Li, Dacheng Li, Eric Xing, et al. Judging LLM-as-a-judge with MT-bench and chatbot arena. In Thirty-seventh Conference on Neural Information Processing Systems Datasets and Benchmarks Track, 2023.
- [111] Wanjun Zhong, Lianghong Guo, Qiqi Gao, He Ye, and Yanlin Wang. Memorybank: Enhancing large language models with long-term memory. AAAI Conference on Artificial Intelligence, 2024.
- [112] Jieyi Zhou, Shreyas Agarwal, Kiante Brantley, et al. Tree search for language model agents. arXiv preprint arXiv:2407.01476, 2024.
- [113] Shuyan Zhou, Frank F. Xu, Hao Zhu, Xuhui Zhou, Robert Lo, Abishek Sridhar, Xianyi Cheng, Tianyue Ou, Yonatan Bisk, Daniel Fried, Uri Alon, and Graham Neubig. Webarena: A realistic web environment for building autonomous agents. In The Twelfth International Conference on Learning Representations, 2024.
- [114] Yuxuan Zhu, Tengjun Jin, Yada Pruksachatkun, Andy Zhang, Shu Liu, Sasha Cui, Sayash Kapoor, et al. Establishing best practices for building rigorous agentic benchmarks. arXiv preprint arXiv:2507.02825, 2025.
- [115] Yuxuan Zhu, Tengjun Jin, Yada Pruksachatkun, Andy Zhang, Shu Liu, Sasha Cui, Sayash Kapoor, et al. Establishing Best Practices for Building Rigorous Agentic Benchmarks, 2025.