原文:Attention Is All You Need 作者:Vaswani 等 8 人(Google Brain / Google Research)· 发表:2017-06
导读:Transformer 的开山之作,NeurIPS 2017 论文,深度学习史上引用量最高的文章之一。核心结论:彻底抛弃 RNN 与 CNN,仅用自注意力机制搭建编码器-解码器架构,训练可大规模并行,在 WMT 2014 英德、英法翻译任务上以更低的训练成本取得当时最佳成绩。适合想从源头理解 Transformer 架构的读者。
摘要
当前主流的序列转换模型建立在含有编码器和解码器的复杂循环或卷积神经网络之上,其中表现最好的模型还会借助注意力机制把编码器与解码器连接起来。我们提出一种全新的简洁网络架构——Transformer,它只依赖注意力机制,彻底舍弃了循环与卷积。在两个机器翻译任务上的实验表明,这类模型质量更优、可并行性更强,所需训练时间也大幅缩短。我们的模型在 WMT 2014 英德翻译任务上取得 28.4 BLEU,比包括集成系统在内的既有最佳结果高出 2 BLEU 以上;在 WMT 2014 英法翻译任务上,我们的模型经 8 块 GPU 训练 3.5 天后,创下 41.8 的单模型最先进 BLEU 纪录,训练开销仅为文献中最佳模型的一小部分。我们还将 Transformer 成功应用于训练数据充足与受限两种情形下的英语成分句法分析,证明其对其他任务同样具有良好的泛化能力。
1 引言
循环神经网络——尤其是长短期记忆网络(LSTM)[13] 与门控循环神经网络 [7]——早已牢固确立了其在语言建模、机器翻译 [35, 2, 5] 等序列建模与转换问题上的最先进方法地位。此后,大量研究仍在继续拓展循环语言模型与编码器-解码器架构的边界 [38, 24, 15]。
循环模型通常沿输入、输出序列的符号位置来分解计算:把各个位置与计算时间的步序对齐,进而生成一列隐状态
在各类任务中,注意力机制已成为优秀序列建模与转换模型不可或缺的组成部分,它让模型在建模依赖关系时,无需考虑这些依赖在输入或输出序列中的距离 [2, 19]。然而除个别例外 [27],这类注意力机制都与循环网络搭配使用。
本文提出 Transformer——一种摒弃循环、完全依靠注意力机制在输入与输出之间建立全局依赖的模型架构。Transformer 带来显著更强的可并行性,只需在 8 块 P100 GPU 上训练短短 12 小时,便可在翻译质量上刷新最先进纪录。
2 背景
降低串行计算这一目标同样是 Extended Neural GPU [16]、ByteNet [18] 与 ConvS2S [9] 的立足之本——它们都以卷积神经网络为基本构件,对所有输入和输出位置并行计算隐表示。在这些模型里,关联来自任意两个输入或输出位置的信号所需的运算次数会随位置间距增长:ConvS2S 呈线性增长,ByteNet 呈对数增长,这让学习远距离位置间的依赖变得更加困难 [12]。而在 Transformer 中,这一开销被降至常数次运算,代价是对注意力加权后的位置取平均会降低有效分辨率——对此我们用 3.2 节介绍的多头注意力加以抵消。
自注意力(self-attention),有时也称内部注意力(intra-attention),是一种把单一序列中不同位置关联起来、借以计算该序列表示的注意力机制。自注意力已在阅读理解、抽象式摘要、文本蕴含以及任务无关的句子表示学习等多种任务中取得成功 [4, 27, 28, 22]。
端到端记忆网络则以循环注意力机制取代按序列对齐的循环结构,已被证明能在简单语言的问答与语言建模任务上表现出色 [34]。
然而据我们所知,Transformer 是第一个完全依靠自注意力来计算输入与输出表示、而不借助序列对齐 RNN 或卷积的转换模型。后续章节将描述 Transformer 的设计,论证选择自注意力的缘由,并讨论它相较于 [17, 18] 与 [9] 等模型的优势。
3 模型架构
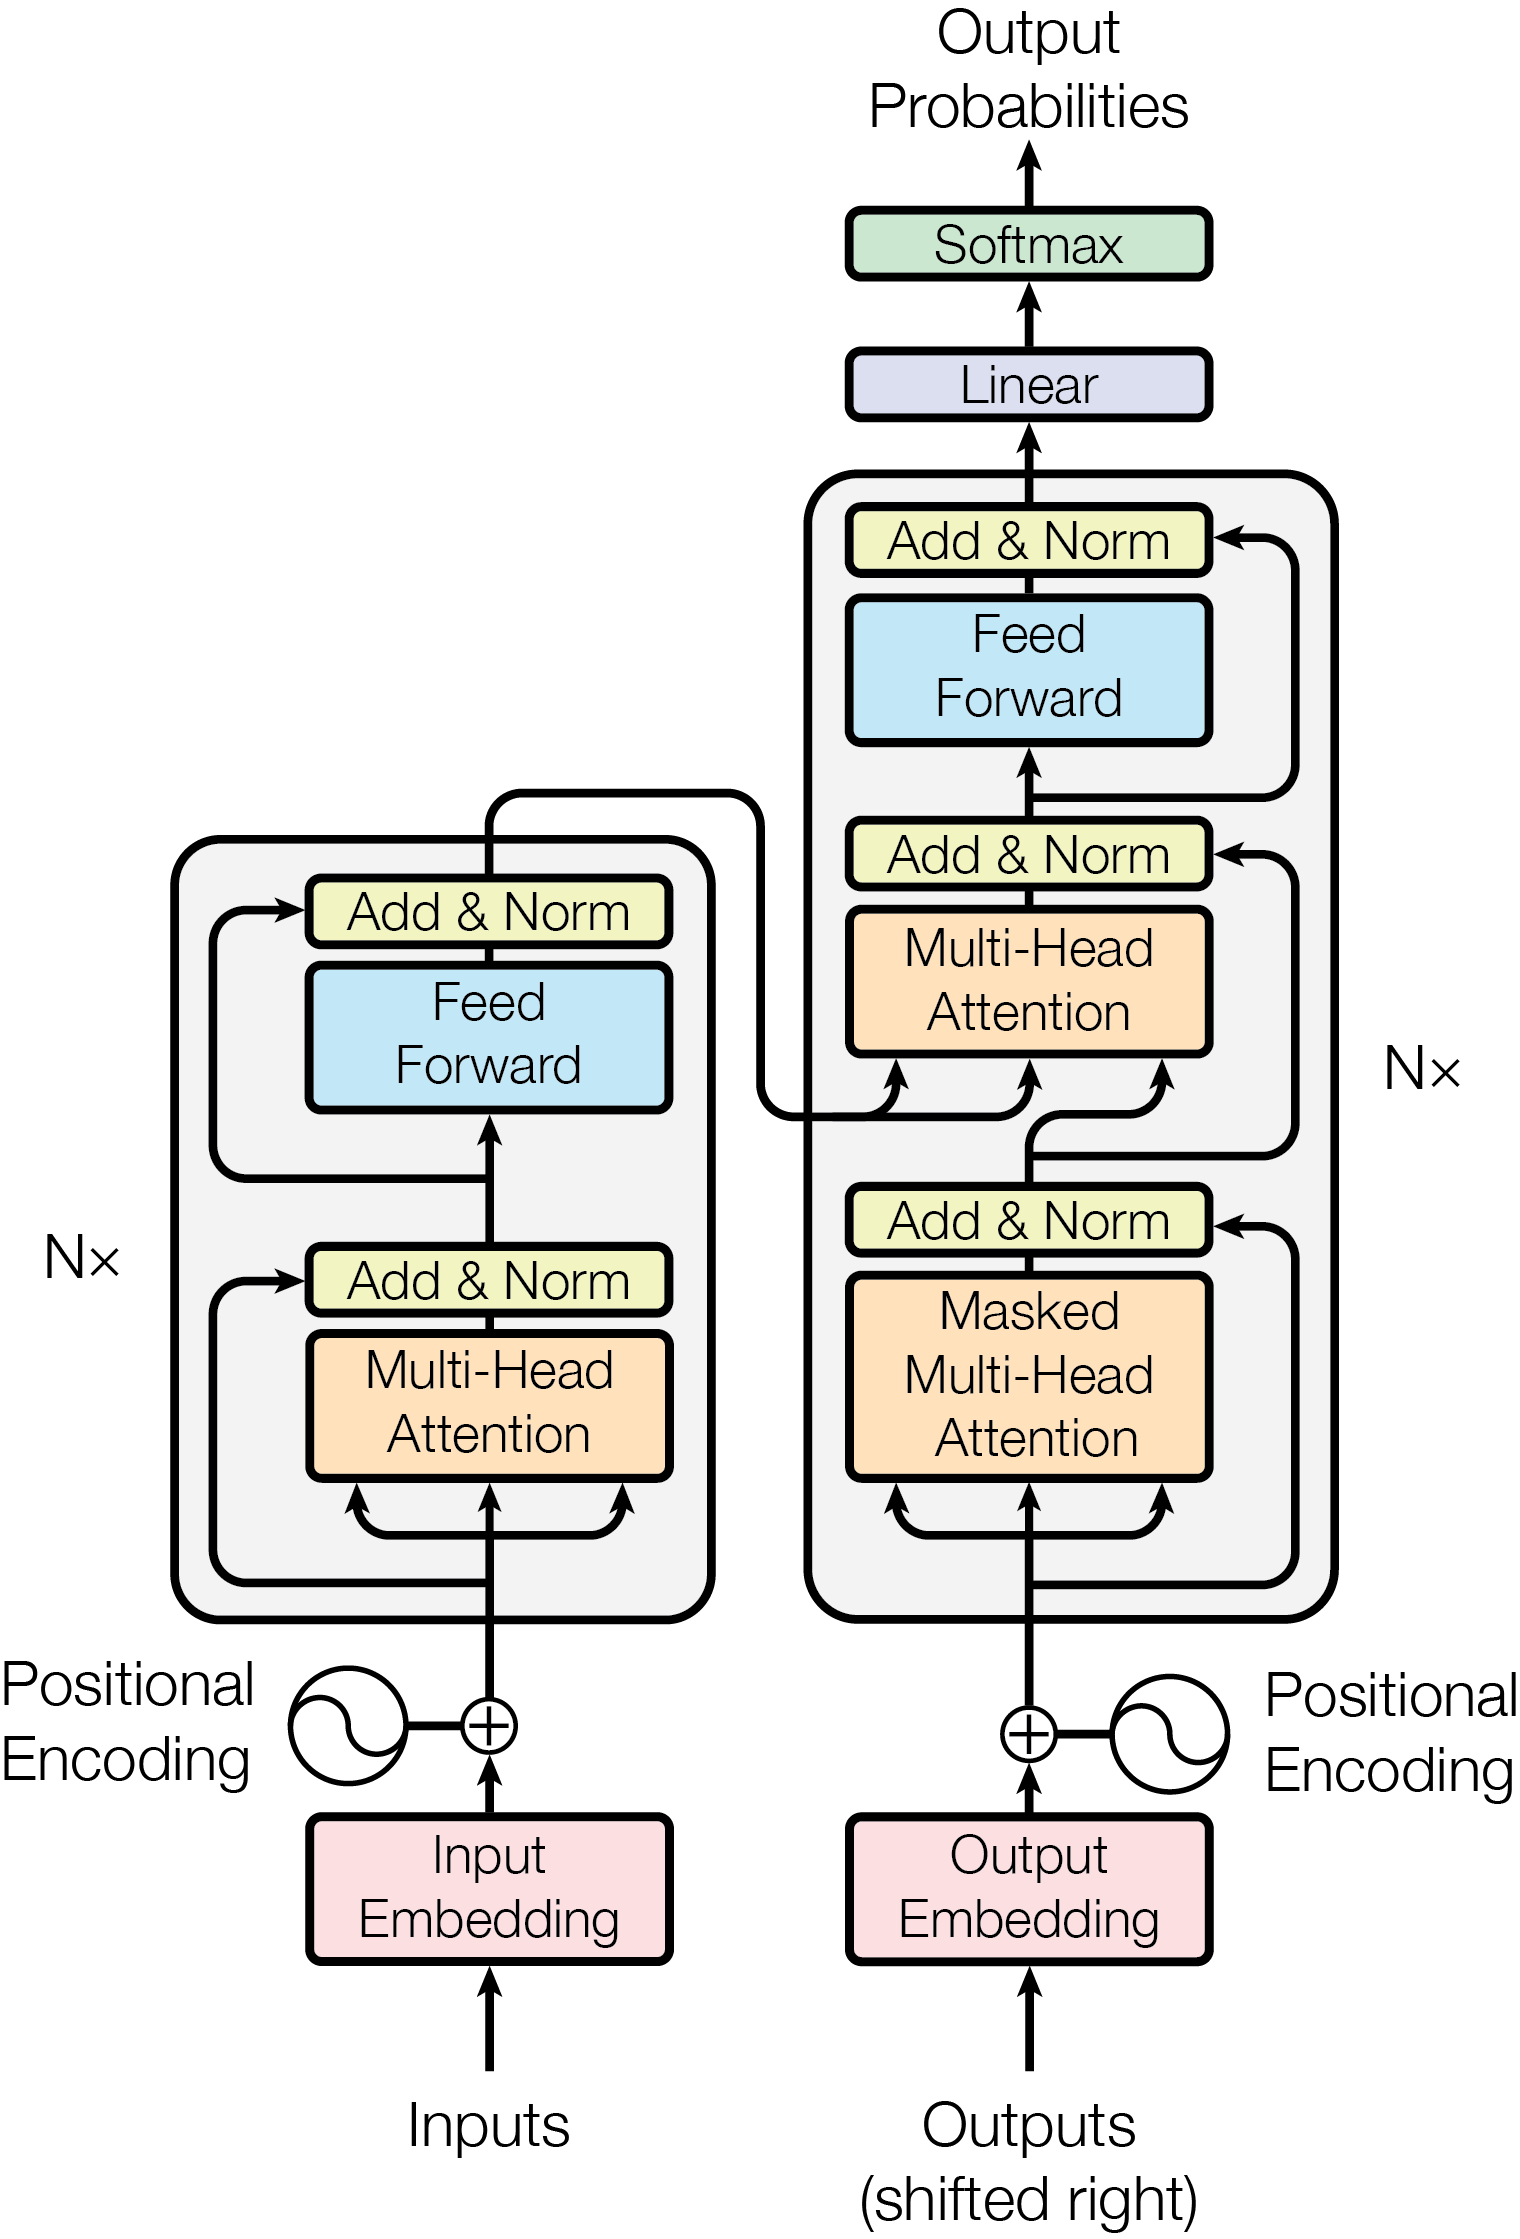
绝大多数有竞争力的神经序列转换模型都采用编码器-解码器结构 [5, 2, 35]:编码器把符号表示的输入序列
Transformer 沿用这一总体架构,其编码器与解码器均由堆叠的自注意力层和逐点全连接层构成,分别对应图 1 的左右两半。
3.1 编码器与解码器堆叠
编码器由
解码器同样由
3.2 注意力
注意力函数可以描述为把一个查询(query)和一组键值对(key-value pairs)映射到一个输出,其中查询、键、值与输出都是向量。输出按值的加权和计算,而分配给每个值的权重,由查询与相应键经某个兼容性函数计算得出。
3.2.1 缩放点积注意力
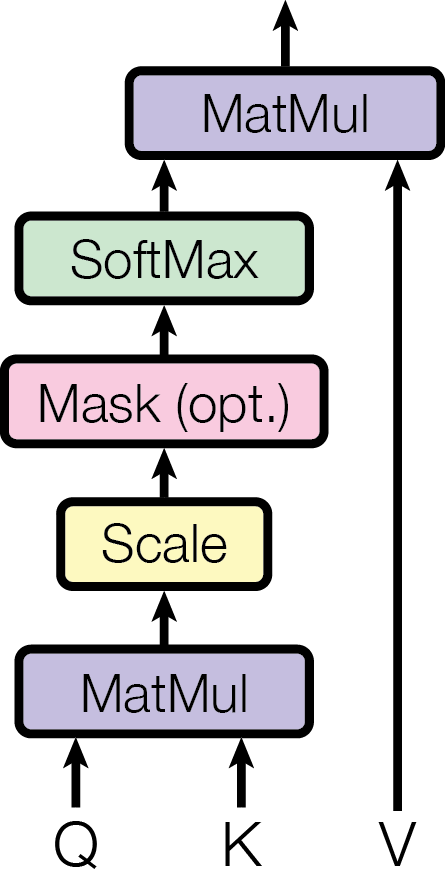
我们把本文这种特定的注意力称为「缩放点积注意力」(图 2)。它的输入是维度为
实践中,我们会同时对一整组查询计算注意力函数:把它们打包成矩阵
最常用的两种注意力函数是加性注意力 [2] 与点积(乘性)注意力。点积注意力与我们的算法完全一致,只差一个
当
3.2.2 多头注意力
与其用
多头注意力让模型能够同时关注不同位置上、来自不同表示子空间的信息;若只有一个注意力头,取平均会抑制这种能力。
式中的投影是参数矩阵
本文使用
3.2.3 注意力在我们模型中的应用
Transformer 以三种方式使用多头注意力:
在「编码器-解码器注意力」层中,查询来自上一个解码器层,记忆的键与值来自编码器的输出。这使解码器中的每个位置都能关注输入序列的所有位置,沿袭了 [38, 2, 9] 等序列到序列模型中典型的编码器-解码器注意力机制。
编码器内含自注意力层。在自注意力层中,所有键、值和查询都来自同一处——在本场景下即编码器中前一层的输出。这样,编码器中的每个位置都能关注编码器前一层的所有位置。
类似地,解码器中的自注意力层允许解码器的每个位置关注解码器中该位置及其之前的所有位置。为保持自回归性质,必须阻止解码器中的信息向左流动。我们在缩放点积注意力内部实现这一点:把 softmax 输入中对应非法连接的所有值全部掩掉(置为
3.3 逐位置前馈网络
除注意力子层外,我们的编码器和解码器的每一层还各含一个全连接前馈网络,它对每个位置独立且相同地施加。该网络由两个线性变换构成,中间夹一个 ReLU 激活。
这些线性变换在不同位置上相同,但层与层之间使用的参数各不相同。换一种说法,它相当于两个卷积核大小为 1 的卷积。输入和输出的维度是
3.4 嵌入与 Softmax
与其他序列转换模型一样,我们使用学得的嵌入把输入词元和输出词元转换为
3.5 位置编码
我们的模型既无循环也无卷积,为了让模型利用序列的顺序信息,必须注入一些词元在序列中相对或绝对位置的信息。为此,我们在编码器和解码器堆叠底部的输入嵌入上叠加「位置编码」(positional encoding)。位置编码与嵌入同为
本文使用不同频率的正弦与余弦函数:
其中
我们也实验了用学得的位置嵌入 [9] 替代上述编码,发现两个版本的结果几乎一模一样(见表 3 行 (E))。我们最终选择正弦版本,是因为它或许能让模型外推到比训练时见过的更长的序列长度。
4 为什么用自注意力
本节把自注意力层与常用的循环层、卷积层做多方面比较——这两类层常用于把一个变长的符号表示序列
其一是每层的总计算复杂度;其二是可并行化的计算量,以所需的最少串行操作数衡量。
其三是网络中长程依赖之间的路径长度。学习长程依赖是许多序列转换任务的关键难题,而影响这种学习能力的一个关键因素,就是前向与反向信号在网络中必须穿越的路径长度。输入、输出序列任意位置组合之间的路径越短,长程依赖就越容易学到 [12]。因此,我们还比较了由不同类型层组成的网络中,任意两个输入与输出位置之间的最大路径长度。
表 1:不同层类型的最大路径长度、每层复杂度与最少串行操作数。
| 层类型 | 每层复杂度 | 串行操作数 | 最大路径长度 |
|---|---|---|---|
| 自注意力 | |||
| 循环 | |||
| 卷积 | |||
| 受限自注意力 |
如表 1 所示,自注意力层只需常数次串行操作就能连接所有位置,循环层却需要
核宽
一个附带的好处是,自注意力可以带来更具可解释性的模型。我们检视了模型的注意力分布,并在附录中展示和讨论了若干实例。不仅单个注意力头会清晰地学到执行不同任务,许多头还表现出与句子句法、语义结构相关的行为。
5 训练
本节介绍我们模型的训练配置。
5.1 训练数据与批处理
我们在标准的 WMT 2014 英德数据集上训练,其中约含 450 万个句子对;句子采用 byte-pair 编码 [3],源语言与目标语言共享一个约 37000 词元的词表。英法任务则使用规模大得多的 WMT 2014 英法数据集(3600 万句),并把词元切分成 32000 大小的 word-piece 词表 [38]。句子对按近似序列长度分批,每个训练批次包含一组句子对,约含 25000 个源词元和 25000 个目标词元。
5.2 硬件与训练时长
我们在一台搭载 8 块 NVIDIA P100 GPU 的机器上训练模型。对于采用全文所述超参数的基础模型(base model),每个训练步约需 0.4 秒,总共训练 100,000 步(12 小时)。对于大模型(big model,配置见表 3 末行),每步耗时 1.0 秒,训练了 300,000 步(3.5 天)。
5.3 优化器
我们使用 Adam 优化器 [20],取
这相当于在前
5.4 正则化
训练期间我们采用了三类正则化:
我们在每个子层的输出与子层输入相加并归一化之前,先对子层输出应用 dropout [33]。此外,编码器和解码器堆叠中嵌入与位置编码之和也要应用 dropout。对基础模型,我们使用的比率为
训练期间,我们采用了取值
6 结果
6.1 机器翻译
表 2:Transformer 在 newstest2014 英德与英法测试上,以远低于以往最先进模型的训练成本取得了更高的 BLEU 分数。
| 模型 | BLEU EN-DE | BLEU EN-FR | 训练成本 (FLOPs) EN-DE | 训练成本 (FLOPs) EN-FR |
|---|---|---|---|---|
| ByteNet [18] | 23.75 | |||
| Deep-Att + PosUnk [39] | 39.2 | |||
| GNMT + RL [38] | 24.6 | 39.92 | ||
| ConvS2S [9] | 25.16 | 40.46 | ||
| MoE [32] | 26.03 | 40.56 | ||
| Deep-Att + PosUnk Ensemble [39] | 40.4 | |||
| GNMT + RL Ensemble [38] | 26.30 | 41.16 | ||
| ConvS2S Ensemble [9] | 26.36 | 41.29 | ||
| Transformer (base model) | 27.3 | 38.1 | ||
| Transformer (big) | 28.4 | 41.8 |
在 WMT 2014 英德翻译任务上,Transformer 大模型(表 2 中的 Transformer (big))比此前报道的最佳模型(包括集成系统)高出逾
在 WMT 2014 英法翻译任务上,我们的大模型取得
对基础模型,我们使用由最后 5 个检查点平均得到的单一模型,这些检查点每 10 分钟写盘一次;对大模型,我们平均了最后 20 个检查点。我们使用束大小为
表 2 汇总了我们的结果,并把我们的翻译质量与训练成本同文献中的其他模型架构做了比较。训练一个模型所用的浮点运算次数,我们以训练时间、所用 GPU 数量与每块 GPU 持续单精度浮点算力的估计值三者相乘来估算 [^2]。
6.2 模型变体
表 3:Transformer 架构上的变体实验。 未列出的值与基础模型相同;所有指标均在英德翻译开发集 newstest2013 上测得;所列困惑度按本文 byte-pair 编码以每 word-piece 计,不应与每词困惑度直接比较。
| 训练步数 | PPL(开发集) | BLEU(开发集) | 参数量( | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0.1 | 0.1 | 100K | 4.92 | 25.8 | 65 |
| (A) | 1 | 512 | 512 | 5.29 | 24.9 | |||||||
| 4 | 128 | 128 | 5.00 | 25.5 | ||||||||
| 16 | 32 | 32 | 4.91 | 25.8 | ||||||||
| 32 | 16 | 16 | 5.01 | 25.4 | ||||||||
| (B) | 16 | 5.16 | 25.1 | 58 | ||||||||
| 32 | 5.01 | 25.4 | 60 | |||||||||
| (C) | 2 | 6.11 | 23.7 | 36 | ||||||||
| 4 | 5.19 | 25.3 | 50 | |||||||||
| 8 | 4.88 | 25.5 | 80 | |||||||||
| 256 | 32 | 32 | 5.75 | 24.5 | 28 | |||||||
| 1024 | 128 | 128 | 4.66 | 26.0 | 168 | |||||||
| 1024 | 5.12 | 25.4 | 53 | |||||||||
| 4096 | 4.75 | 26.2 | 90 | |||||||||
| (D) | 0.0 | 5.77 | 24.6 | |||||||||
| 0.2 | 4.95 | 25.5 | ||||||||||
| 0.0 | 4.67 | 25.3 | ||||||||||
| 0.2 | 5.47 | 25.7 | ||||||||||
| (E) | 用位置嵌入代替正弦位置编码 | 4.92 | 25.7 | |||||||||
| big | 6 | 1024 | 4096 | 16 | 0.3 | 300K | 4.33 | 26.4 | 213 |
为评估 Transformer 各组件的重要性,我们以多种方式改动基础模型,并在英德翻译开发集 newstest2013 上测量性能变化。束搜索按上一节的设置进行,但不做检查点平均。结果见表 3。
表 3 (A) 组行中,我们在保持计算量不变(如 3.2.2 节所述)的前提下,改变注意力头数以及注意力键、值的维度。单头注意力比最佳设置低 0.9 BLEU,但头数过多时质量同样会下滑。
表 3 (B) 组行中,我们观察到减小注意力键尺寸
6.3 英语成分句法分析
表 4:Transformer 能很好地泛化到英语成分句法分析(结果在 WSJ 第 23 节上测得)。
| 解析器 | 训练设置 | WSJ 23 F1 |
|---|---|---|
| Vinyals & Kaiser el al. (2014) [37] | 仅 WSJ,判别式 | 88.3 |
| Petrov et al. (2006) [29] | 仅 WSJ,判别式 | 90.4 |
| Zhu et al. (2013) [40] | 仅 WSJ,判别式 | 90.4 |
| Dyer et al. (2016) [8] | 仅 WSJ,判别式 | 91.7 |
| Transformer (4 layers) | 仅 WSJ,判别式 | 91.3 |
| Zhu et al. (2013) [40] | 半监督 | 91.3 |
| Huang & Harper (2009) [14] | 半监督 | 91.3 |
| McClosky et al. (2006) [26] | 半监督 | 92.1 |
| Vinyals & Kaiser el al. (2014) [37] | 半监督 | 92.1 |
| Transformer (4 layers) | 半监督 | 92.7 |
| Luong et al. (2015) [23] | 多任务 | 93.0 |
| Dyer et al. (2016) [8] | 生成式 | 93.3 |
为检验 Transformer 能否泛化到其他任务,我们在英语成分句法分析上做了实验。这个任务挑战独特:输出受很强的结构约束,且显著长于输入;此外,RNN 序列到序列模型在小数据场景下一直未能取得最先进结果 [37]。
我们在 Penn Treebank [25] 的《华尔街日报》(WSJ)部分(约 4 万条训练句)上训练了一个 4 层、
我们只在第 22 节开发集上做了少量实验来选定 dropout(注意力与残差两处都设,见 5.4 节)、学习率和束大小,其余所有参数沿用英德基础翻译模型的取值。推理时,最大输出长度提高到输入长度 +
表 4 的结果显示,尽管未做面向任务的专门调优,我们的模型表现出人意料地好,成绩优于此前所有已报道的模型,仅逊于循环神经网络语法(Recurrent Neural Network Grammar)[8]。
与 RNN 序列到序列模型 [37] 形成对照的是,Transformer 即便只在 4 万句的 WSJ 训练集上训练,也胜过 BerkeleyParser [29]。
7 结论
本文提出了 Transformer——第一个完全基于注意力的序列转换模型,用多头自注意力取代了编码器-解码器架构中最常用的循环层。
在翻译任务上,Transformer 的训练速度显著快于基于循环层或卷积层的架构。在 WMT 2014 英德与 WMT 2014 英法两个翻译任务上,我们都取得了新的最先进成绩;在前一个任务上,我们的最佳模型甚至超过此前报道的所有集成系统。
我们对基于注意力的模型的未来充满期待,计划把它们应用到更多任务上:把 Transformer 扩展到输入输出涉及文本以外模态的问题,并研究局部、受限的注意力机制,以高效处理图像、音频、视频等大型输入与输出。让生成过程少一些串行,也是我们的研究目标之一。
我们训练和评估模型所用的代码发布于 https://github.com/tensorflow/tensor2tensor 。
我们感谢 Nal Kalchbrenner 与 Stephan Gouws 提供的富有成效的意见、指正与启发。
[^1]: 为说明点积为何会变大,假设
[^2]: 对 K80、K40、M40 与 P100,我们分别取 2.8、3.7、6.0 与 9.5 TFLOPS。
参考文献
- [1] Jimmy Lei Ba, Jamie Ryan Kiros, and Geoffrey E Hinton. Layer normalization. arXiv preprint arXiv:1607.06450, 2016.
- [2] Dzmitry Bahdanau, Kyunghyun Cho, and Yoshua Bengio. Neural machine translation by jointly learning to align and translate. CoRR, abs/1409.0473, 2014.
- [3] Denny Britz, Anna Goldie, Minh-Thang Luong, and Quoc V. Le. Massive exploration of neural machine translation architectures. CoRR, abs/1703.03906, 2017.
- [4] Jianpeng Cheng, Li Dong, and Mirella Lapata. Long short-term memory-networks for machine reading. arXiv preprint arXiv:1601.06733, 2016.
- [5] Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Fethi Bougares, Holger Schwenk, and Yoshua Bengio. Learning phrase representations using rnn encoder-decoder for statistical machine translation. CoRR, abs/1406.1078, 2014.
- [6] Francois Chollet. Xception: Deep learning with depthwise separable convolutions. arXiv preprint arXiv:1610.02357, 2016.
- [7] Junyoung Chung, Çaglar Gülçehre, Kyunghyun Cho, and Yoshua Bengio. Empirical evaluation of gated recurrent neural networks on sequence modeling. CoRR, abs/1412.3555, 2014.
- [8] Chris Dyer, Adhiguna Kuncoro, Miguel Ballesteros, and Noah A. Smith. Recurrent neural network grammars. In Proc. of NAACL, 2016.
- [9] Jonas Gehring, Michael Auli, David Grangier, Denis Yarats, and Yann N. Dauphin. Convolutional sequence to sequence learning. arXiv preprint arXiv:1705.03122v2, 2017.
- [10] Alex Graves. Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850, 2013.
- [11] Kaiming He, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, pages 770–778, 2016.
- [12] Sepp Hochreiter, Yoshua Bengio, Paolo Frasconi, and Jürgen Schmidhuber. Gradient flow in recurrent nets: the difficulty of learning long-term dependencies, 2001.
- [13] Sepp Hochreiter and Jürgen Schmidhuber. Long short-term memory. Neural computation, 9(8):1735–1780, 1997.
- [14] Zhongqiang Huang and Mary Harper. Self-training PCFG grammars with latent annotations across languages. In Proceedings of the 2009 Conference on Empirical Methods in Natural Language Processing, pages 832–841. ACL, August 2009.
- [15] Rafal Jozefowicz, Oriol Vinyals, Mike Schuster, Noam Shazeer, and Yonghui Wu. Exploring the limits of language modeling. arXiv preprint arXiv:1602.02410, 2016.
- [16] Łukasz Kaiser and Samy Bengio. Can active memory replace attention? In Advances in Neural Information Processing Systems, (NIPS), 2016.
- [17] Łukasz Kaiser and Ilya Sutskever. Neural GPUs learn algorithms. In International Conference on Learning Representations (ICLR), 2016.
- [18] Nal Kalchbrenner, Lasse Espeholt, Karen Simonyan, Aaron van den Oord, Alex Graves, and Koray Kavukcuoglu. Neural machine translation in linear time. arXiv preprint arXiv:1610.10099v2, 2017.
- [19] Yoon Kim, Carl Denton, Luong Hoang, and Alexander M. Rush. Structured attention networks. In International Conference on Learning Representations, 2017.
- [20] Diederik Kingma and Jimmy Ba. Adam: A method for stochastic optimization. In ICLR, 2015.
- [21] Oleksii Kuchaiev and Boris Ginsburg. Factorization tricks for LSTM networks. arXiv preprint arXiv:1703.10722, 2017.
- [22] Zhouhan Lin, Minwei Feng, Cicero Nogueira dos Santos, Mo Yu, Bing Xiang, Bowen Zhou, and Yoshua Bengio. A structured self-attentive sentence embedding. arXiv preprint arXiv:1703.03130, 2017.
- [23] Minh-Thang Luong, Quoc V. Le, Ilya Sutskever, Oriol Vinyals, and Lukasz Kaiser. Multi-task sequence to sequence learning. arXiv preprint arXiv:1511.06114, 2015.
- [24] Minh-Thang Luong, Hieu Pham, and Christopher D Manning. Effective approaches to attention-based neural machine translation. arXiv preprint arXiv:1508.04025, 2015.
- [25] Mitchell P Marcus, Mary Ann Marcinkiewicz, and Beatrice Santorini. Building a large annotated corpus of english: The penn treebank. Computational linguistics, 19(2):313–330, 1993.
- [26] David McClosky, Eugene Charniak, and Mark Johnson. Effective self-training for parsing. In Proceedings of the Human Language Technology Conference of the NAACL, Main Conference, pages 152–159. ACL, June 2006.
- [27] Ankur Parikh, Oscar Täckström, Dipanjan Das, and Jakob Uszkoreit. A decomposable attention model. In Empirical Methods in Natural Language Processing, 2016.
- [28] Romain Paulus, Caiming Xiong, and Richard Socher. A deep reinforced model for abstractive summarization. arXiv preprint arXiv:1705.04304, 2017.
- [29] Slav Petrov, Leon Barrett, Romain Thibaux, and Dan Klein. Learning accurate, compact, and interpretable tree annotation. In Proceedings of the 21st International Conference on Computational Linguistics and 44th Annual Meeting of the ACL, pages 433–440. ACL, July 2006.
- [30] Ofir Press and Lior Wolf. Using the output embedding to improve language models. arXiv preprint arXiv:1608.05859, 2016.
- [31] Rico Sennrich, Barry Haddow, and Alexandra Birch. Neural machine translation of rare words with subword units. arXiv preprint arXiv:1508.07909, 2015.
- [32] Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le, Geoffrey Hinton, and Jeff Dean. Outrageously large neural networks: The sparsely-gated mixture-of-experts layer. arXiv preprint arXiv:1701.06538, 2017.
- [33] Nitish Srivastava, Geoffrey E Hinton, Alex Krizhevsky, Ilya Sutskever, and Ruslan Salakhutdinov. Dropout: a simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(1):1929–1958, 2014.
- [34] Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston, and Rob Fergus. End-to-end memory networks. In C. Cortes, N. D. Lawrence, D. D. Lee, M. Sugiyama, and R. Garnett, editors, Advances in Neural Information Processing Systems 28, pages 2440–2448. Curran Associates, Inc., 2015.
- [35] Ilya Sutskever, Oriol Vinyals, and Quoc VV Le. Sequence to sequence learning with neural networks. In Advances in Neural Information Processing Systems, pages 3104–3112, 2014.
- [36] Christian Szegedy, Vincent Vanhoucke, Sergey Ioffe, Jonathon Shlens, and Zbigniew Wojna. Rethinking the inception architecture for computer vision. CoRR, abs/1512.00567, 2015.
- [37] Vinyals & Kaiser, Koo, Petrov, Sutskever, and Hinton. Grammar as a foreign language. In Advances in Neural Information Processing Systems, 2015.
- [38] Yonghui Wu, Mike Schuster, Zhifeng Chen, Quoc V Le, Mohammad Norouzi, Wolfgang Macherey, Maxim Krikun, Yuan Cao, Qin Gao, Klaus Macherey, et al. Google's neural machine translation system: Bridging the gap between human and machine translation. arXiv preprint arXiv:1609.08144, 2016.
- [39] Jie Zhou, Ying Cao, Xuguang Wang, Peng Li, and Wei Xu. Deep recurrent models with fast-forward connections for neural machine translation. CoRR, abs/1606.04199, 2016.
- [40] Muhua Zhu, Yue Zhang, Wenliang Chen, Min Zhang, and Jingbo Zhu. Fast and accurate shift-reduce constituent parsing. In Proceedings of the 51st Annual Meeting of the ACL (Volume 1: Long Papers), pages 434–443. ACL, August 2013.