原文:Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs 作者:Ovadia、Brief 等 4 人(Microsoft)· 发表:2023-12(EMNLP 2024)
导读:RAG 与微调之争的代表性实证研究(Microsoft 团队,EMNLP 2024)。论文在 MMLU 五个学科任务和自建的 2023 时事问答上系统对比两种知识注入方式:无论注入全新知识还是更新已有知识,RAG 都显著优于无监督微调,且不损害模型已有能力;LLM 难以靠无监督微调学会新事实,除非把同一事实以多种改写反复呈现。适合正在 RAG 与微调之间做技术选型的工程师与研究者阅读。
摘要
大语言模型(LLM)在其预训练权重中封装了大量事实性信息,它们能回答跨不同领域的多样化问题,便是明证。然而,这些知识存在固有局限,严重依赖训练数据的特性。因此,利用外部数据集来纳入新信息,或提升 LLM 在此前见过的信息上的能力,是一项重大挑战。在本研究中,我们比较了两种常见方法:无监督微调与检索增强生成(RAG)。我们在跨不同主题的多种知识密集型任务上对这两种方法进行了评估。我们的研究结果表明,虽然无监督微调能带来一定提升,但无论是对训练中接触过的已有知识,还是对全新的知识,RAG 都始终表现更优。此外,我们发现 LLM 难以通过无监督微调学会新的事实性信息,而在训练期间让它们接触到同一事实的众多变体,则可以缓解这一问题。
关键词:LLM、NLP、微调 vs. RAG、知识与事实性。
1 引言
大语言模型(LLM)能够捕捉大量事实性信息(Petroni et al. 2019; Cohen et al. 2023; Hu et al. 2023)。凭借规模庞大的预训练数据集,LLM 在各个领域都展现出卓越的知识水平。然而,这些知识存在两个显著局限。第一,它是静态的,不随时间更新。第二,它缺乏针对性,因而可能在特定领域缺少细致的专业知识。虽然这是两个不同的问题,但它们密切相关,因为解决方案是同一个:增强模型的知识。
近年来,让 LLM 适应特定领域并更新其知识的思路日益普遍(Yu et al. 2022)。为提升医疗(Singhal et al. 2023a; Singhal et al. 2023b; Wu et al. 2023a)、金融(Wu et al. 2023b; Yang et al. 2023)、法律(Huang et al. 2023; Nguyen 2023)等不同领域的事实性知识与能力,人们已经提出了多种模型。
在本工作中,我们关注对模型知识的评估,以及模型记忆、理解和检索事实数据的能力。我们旨在理解知识注入这一概念(Wang et al. 2020; Chen et al. 2022; Liu et al. 2020; Lauscher et al. 2020)。给定一个以文本语料库形式呈现的知识库,让预训练模型学会这些知识的最佳方式是什么?
向预训练模型添加知识的一种方式是微调。通过微调,我们延续模型的训练过程,用任务特定的数据对它进行适配。让模型接触特定的知识库后,我们期望模型权重做出相应的调整。这一过程旨在面向目标应用优化模型,提升其在专业领域中的性能与上下文相关性。
另一种增强模型知识库的方法是使用上下文学习(ICL)(Chen et al. 2021; Radford et al. 2019; Min et al. 2021; Lampinen et al. 2022)。ICL 的核心思想是:在不直接改动模型权重的前提下,通过修改输入给模型的查询,来提升预训练 LLM 在新任务上的表现。ICL 的一种形式是检索增强生成(RAG)(Lewis et al. 2020; Neelakantan et al. 2022)。RAG 利用信息检索技术,使 LLM 能够从知识源中获取相关信息,并将其融入生成的文本。
本研究旨在通过比较微调与 RAG 来评估 LLM 的知识注入能力。为了说明其中的道理,让我们用一个类比。设想三名大学生参加某个特定主题的考试。他们都拿到过课程材料,但事先不知道考试主题。第一名学生只在考试期间持有教材;第二名学生考前拿到材料并作了学习;第三名学生则在考试消息公布之时就失去了对材料的访问权。谁可能会表现得更好?
2 背景
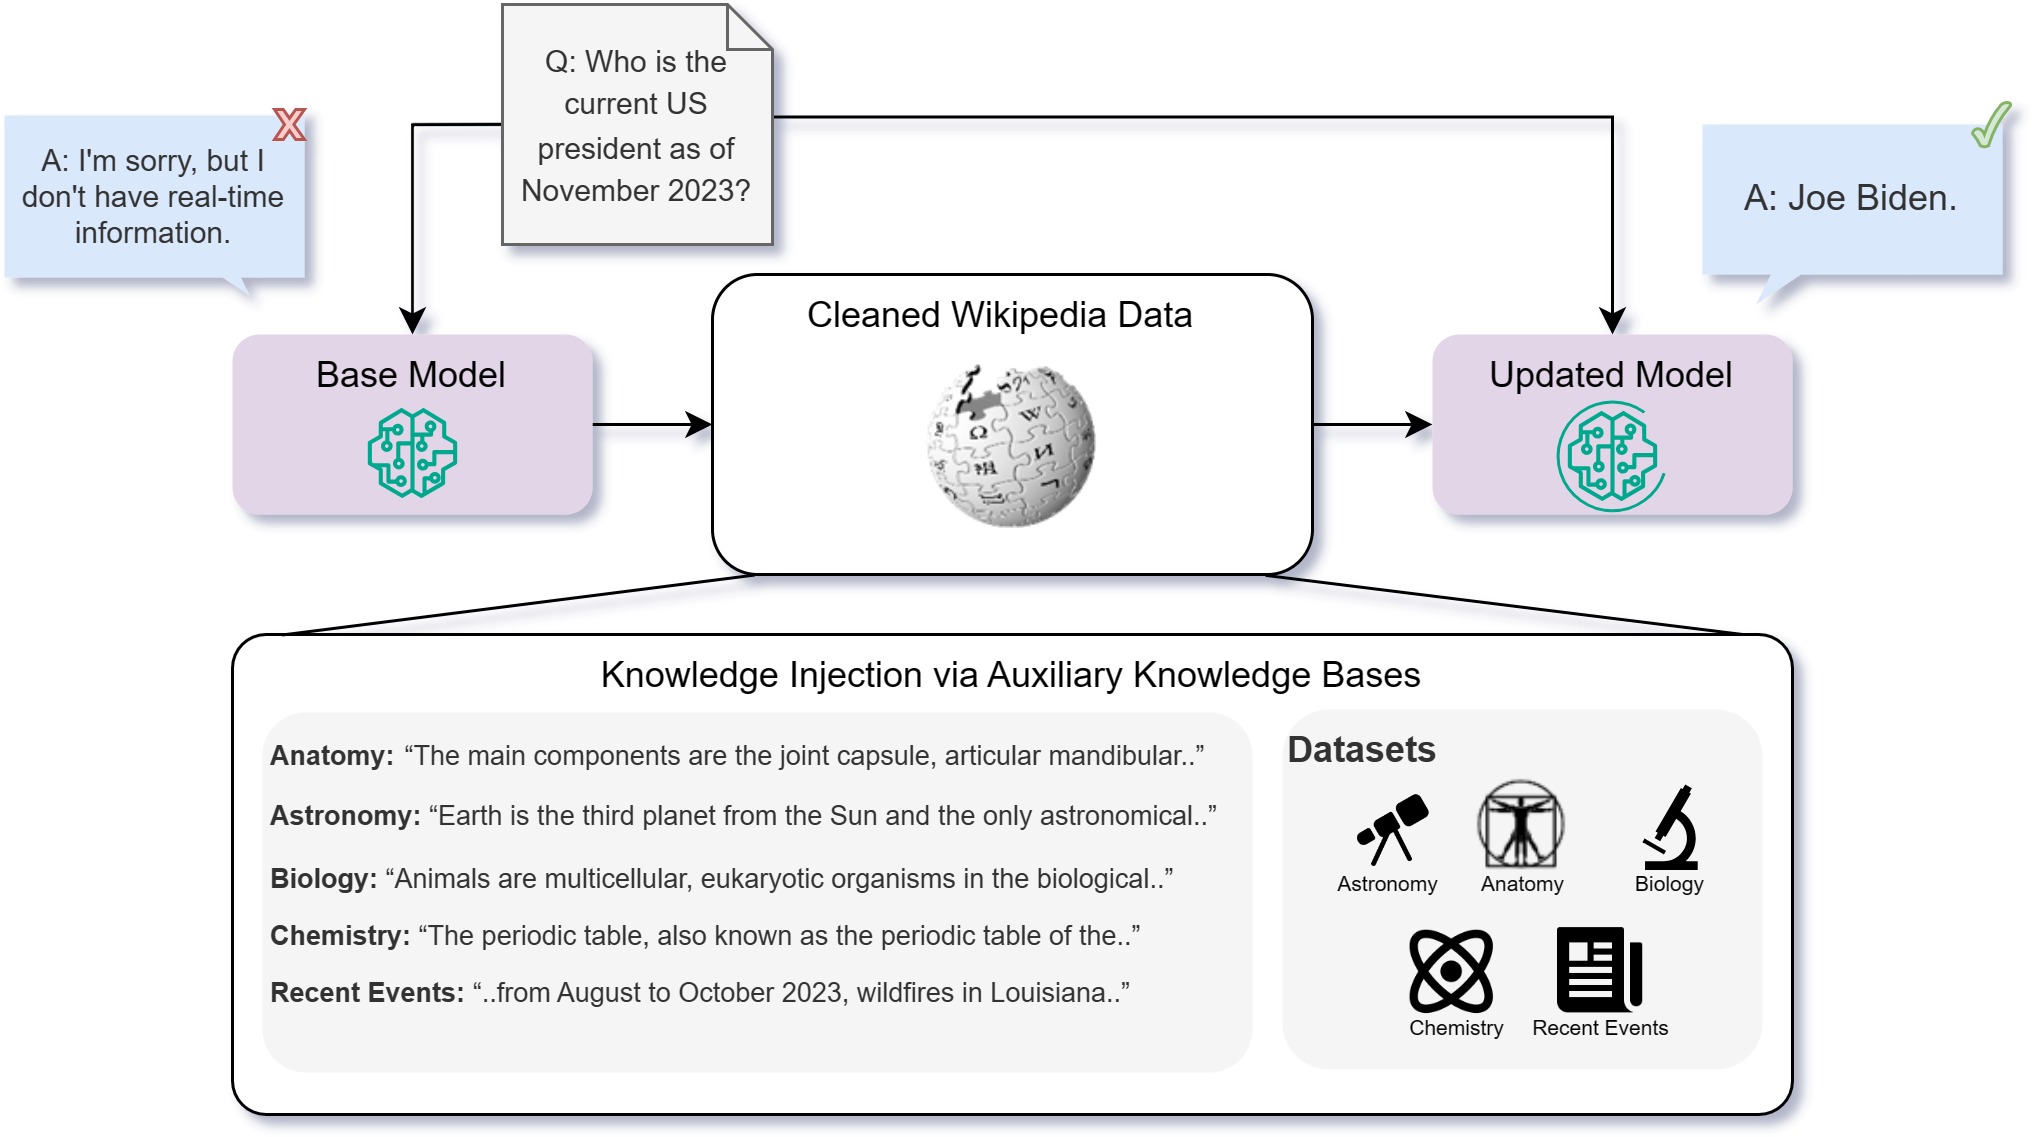
要评估知识注入,我们必须首先理解知识对 LLM 而言意味着什么。
知识与语言模型 定义知识是一项复杂的哲学任务,远远超出本研究的范围。不过,我们可以考察事实性知识在语言模型语境下的含义。如果一个模型知道某个事实,它就能准确而一致地回答与该事实相关的问题。此外,它还能可靠地辨别与该事实相关的陈述的真伪。我们还可以把这一定义从单个事实扩展到整个知识库。
在数学上,设
设
我们将
若以下条件成立,我们就说模型
简单来说,模型能够持续给出正确答案,优于简单的随机猜测基线。自然地,若一个模型的知识得分
先前见过的知识 需要做一个重要区分:一边是模型在预训练期间已经接触过的知识,另一边是全新的事实。考虑到现代 LLM 训练集的规模,它们覆盖了网络文本中可得的海量信息。因此,即便在小众领域,知识注入的目标也不一定是教给模型全新的事实,而是通过诱导模型偏向特定领域来「刷新」它的记忆。
知识与推理 我们强调,这一面向 LLM 的知识评估框架并不完美。重要的是,它没有纳入影响模型响应的其他质量指标。构建一个完全不涉及任何推理的纯知识密集型数据集十分困难。因此,推理能力强的模型可能凭借在多项选择考试中做出「有根据的猜测」,在不熟悉的知识密集型任务上表现出色。所以,对 LLM 知识的任何评估都应把这一点考虑在内,其结果应被看作推理(Sakaguchi et al. 2021)、阅读理解(Dua et al. 2019)与通用语言能力(Srivastava et al. 2022)等更广泛的一系列基准的一部分。尽管如此,这一评估框架仍然最强调事实性信息。
事实性错误的原因 模型无法准确回答事实性问题,可能有许多原因。在(Wang et al. 2023)中,Wang 等人提出了一个包含五种主要模型层面成因的分类体系:
领域知识缺失: 语言模型可能缺乏其未曾接触过的某个特定领域的全面专业知识。例如,一个仅在威廉·莎士比亚所写文本上训练的模型,在被问及马克·吐温的作品时表现会很差。
信息过时: LLM 无一例外都有一个由其训练数据集决定的知识截止日期。因此,最后一次训练更新之后发生的任何事件、发现或变化,若无法访问外部来源,都不会进入模型的知识范围。
未能记住: 有时,模型在训练过程中接触过某些知识,却没有把它保留下来。对于那些在训练数据集中仅零星出现的罕见事实,情况尤其如此(Kandpal et al. 2023)。
遗忘: 语言模型在预训练阶段之后往往要经历额外的训练(微调)。某些情况下,这可能导致一种称为灾难性遗忘(catastrophic forgetting)的现象(Kirkpatrick et al. 2017; Goodfellow et al. 2013; Chen et al. 2020; Luo et al. 2023):模型会丢失一部分它在微调之前已经掌握的知识。
推理失败: 在某些情况下,语言模型可能掌握关于某个事实的相关知识,却未能正确地加以运用。这在复杂的多步推理任务(Tan et al. 2023)中尤为明显,在就同一事实提出不同问题却得到迥异结果(Berglund et al. 2023)时同样如此。
我们注意到,这些问题大多产生于预训练阶段,灾难性遗忘是一个显著的例外。因此,无论经历怎样的后训练流程,许多 LLM 都会出现这类事实性错误。
3 向语言模型注入知识
根据第 2 节给出的背景,显然通用的预训练对许多知识密集型任务而言并不足够。为解决这一问题,必须增加一个额外的后处理步骤来增强预训练模型的知识。这一步骤通常被称为知识注入(Wang et al. 2020; Chen et al. 2022; Liu et al. 2020; Lauscher et al. 2020)。
在本节中,我们考察两种广泛使用的知识注入框架:微调(FT)与检索增强生成(RAG)。我们首先对知识注入问题进行形式化,力求用一致的术语解释这两种方法。
3.1 问题形式化
在公式 1 和公式 2 中,我们从问答(Q&A)的视角给出了语言模型中知识的一种形式化表述。现在,我们用相同的术语将这一表述扩展到知识注入问题。
给定一组事实性问题,总存在某个文本语料库,其中包含与这些问题相关的信息。知识注入的核心假设是:在完全访问这一语料库的前提下,它可以充当辅助知识库,提升模型在这组问题上的表现。
在数学上,设
在本工作中,我们旨在比较
3.2 微调
微调是在一个特定的(通常范围更窄的)数据集或任务上调整预训练模型,以提升其在该领域表现的过程。这里必须区分不同类型的微调。FT 技术通常分为监督式、无监督式和基于强化学习(RL)的方法。下面我们简要回顾这些方法及其与知识注入问题的关系。
监督微调 监督微调(SFT)需要带标注的输入-输出对集合。最常见的 SFT 方法之一是指令微调(Wang et al. 2022; Mishra et al. 2021; Ouyang et al. 2022; Taori et al. 2023),它已成为提升模型表现的最强大方法之一。在指令微调中,输入是自然语言的任务描述,输出则是期望行为的示例。当前许多最先进的 LLM 都在预训练阶段之后进行过指令微调。
已有研究表明,指令微调在提升模型整体质量方面非常有效,尤其是零样本与推理能力。然而,尽管有这些优势,指令微调并不必然教会模型新知识(Ouyang et al. 2022; Chung et al. 2022; Mitra et al. 2023; Chia et al. 2023; Zhou et al. 2023)。因此,仅靠指令微调并非知识注入问题的可行解法。
强化学习 另一种形式的 FT 依赖 RL 或受 RL 启发的优化策略,以便在预训练阶段之后更好地对齐模型。几个突出的例子是基于人类反馈的强化学习(RLHF)(OpenAI 2023; Touvron et al. 2023)、直接偏好优化(DPO)(Rafailov et al. 2023)和近端策略优化(PPO)(Schulman et al. 2017; Tunstall et al. 2023)。
这些技术已被证明非常有用,尤其是与指令微调结合使用时。然而,与指令微调类似,这些方法关注的是响应的整体质量及其期望行为,而不一定是知识的广度。
无监督微调 我们要讨论的最后一种 FT 策略是无监督的,也就是说,没有可供模型学习的标签。一种常见的无监督 FT 技术通常被称为持续预训练或非结构化 FT。
在这种方法中,FT 过程被看作预训练阶段的直接延续。我们从原始 LLM 的一个已保存检查点出发,以因果自回归的方式(即预测下一个 token)训练它。与真正的预训练相比,一个主要差异在于学习率。通常,在延续模型的预训练时,需要低得多的学习率,以避免灾难性遗忘(Kirkpatrick et al. 2017)。
众所周知,LLM 会在预训练阶段存储大量知识(Zhou et al. 2023)。因此,延续这一过程来向模型注入知识是合理的。故而在本工作中,我们全程采用无监督 FT 方法,并评估其在增强模型学习新信息能力方面的效果。
3.3 检索增强生成
检索增强生成(RAG)(Lewis et al. 2020)是一种利用外部知识源来扩展 LLM 能力的技术,在知识密集型任务上尤其如此。虽然最初的表述需要针对每个任务进行额外训练,但此后已有研究证明(Neelakantan et al. 2022):一个预训练嵌入模型无需任何额外训练,即可取得更优的性能。
其思路是:给定辅助知识库和输入查询,我们用 RAG 架构在知识库中找出与输入查询相似的文档。随后,这些文档会被加入输入查询,从而为模型提供关于查询主题的更多上下文。
在实践中,实现所建议的架构相当直接:给定辅助知识库
4 知识库构建
表 1:4.1 节所述 MMLU 数据集的结果,以对数似然准确率(公式 4)衡量。
| 任务 | 模型 | 基础模型 | 基础模型 + RAG | 微调模型 | 微调模型 + RAG |
|---|---|---|---|---|---|
| Anatomy (0-shot) | Mistral 7B | 0.556 | 0.681 | 0.570 | 0.659 |
| Llama2 7B | 0.393 | 0.489 | 0.430 | 0.489 | |
| Orca2 7B | 0.607 | 0.637 | 0.600 | 0.637 | |
| Anatomy (5-shot) | Mistral 7B | 0.600 | 0.681 | 0.622 | 0.674 |
| Llama2 7B | 0.467 | 0.563 | 0.496 | 0.548 | |
| Orca2 7B | 0.570 | 0.659 | 0.593 | 0.674 | |
| Astronomy (0-shot) | Mistral 7B | 0.625 | 0.678 | 0.651 | 0.697 |
| Llama2 7B | 0.401 | 0.467 | 0.487 | 0.520 | |
| Orca2 7B | 0.645 | 0.750 | 0.651 | 0.750 | |
| Astronomy (5-shot) | Mistral 7B | 0.658 | 0.724 | 0.651 | 0.697 |
| Llama2 7B | 0.401 | 0.474 | 0.447 | 0.520 | |
| Orca2 7B | 0.664 | 0.763 | 0.664 | 0.743 | |
| College biology (0-shot) | Mistral 7B | 0.681 | 0.757 | 0.701 | 0.764 |
| Llama2 7B | 0.438 | 0.493 | 0.458 | 0.465 | |
| Orca2 7B | 0.583 | 0.639 | 0.604 | 0.632 | |
| College biology (5-shot) | Mistral 7B | 0.722 | 0.778 | 0.736 | 0.771 |
| Llama2 7B | 0.451 | 0.521 | 0.424 | 0.479 | |
| Orca2 7B | 0.604 | 0.660 | 0.625 | 0.653 | |
| College chemistry (0-shot) | Mistral 7B | 0.470 | 0.500 | 0.490 | 0.500 |
| Llama2 7B | 0.310 | 0.380 | 0.390 | 0.390 | |
| Orca2 7B | 0.370 | 0.440 | 0.370 | 0.390 | |
| College chemistry (5-shot) | Mistral 7B | 0.470 | 0.540 | 0.500 | 0.500 |
| Llama2 7B | 0.370 | 0.380 | 0.360 | 0.390 | |
| Orca2 7B | 0.430 | 0.470 | 0.370 | 0.380 | |
| Prehistory (0-shot) | Mistral 7B | 0.713 | 0.750 | 0.719 | 0.731 |
| Llama2 7B | 0.448 | 0.481 | 0.457 | 0.478 | |
| Orca2 7B | 0.642 | 0.679 | 0.673 | 0.673 | |
| Prehistory (5-shot) | Mistral 7B | 0.722 | 0.762 | 0.725 | 0.762 |
| Llama2 7B | 0.515 | 0.531 | 0.503 | 0.537 | |
| Orca2 7B | 0.664 | 0.698 | 0.667 | 0.694 |
表 2:时事任务结果。在原始数据集上微调的模型记为 FT-reg,在多改写版本数据集上训练的模型记为 FT-par。
| 基础模型 | 基础模型 + RAG | FT-reg | FT-par | FT-reg + RAG | FT-par + RAG | |
|---|---|---|---|---|---|---|
| Mistral 7B | 0.481 | 0.875 | 0.504 | 0.588 | 0.810 | 0.830 |
| Llama2 7B | 0.353 | 0.585 | 0.219 | 0.392 | 0.326 | 0.520 |
| Orca2 7B | 0.456 | 0.876 | 0.511 | 0.566 | 0.820 | 0.826 |
4.1 任务选择与依据
MMLU 基准 为在知识密集型任务上正确评估 LLM 的能力,我们从大规模多语言语言理解评测(Massively Multilingual Language Understanding Evaluation,MMLU)基准(Hendrycks et al. 2021)中选取了四个不同的任务,涵盖解剖学(Anatomy)、天文学(Astronomy)、大学生物(College biology)、大学化学(College chemistry)和史前史(Prehistory)主题。所选任务的遴选标准是侧重事实知识、尽量不依赖推理。作为启发式规则,我们只选择题干简短、不附带上下文材料的任务。实际操作中,我们选取了四个 STEM 学科和一个人文学科,以确保评估不局限于个别领域。需要注意的是,史前史任务的题目覆盖所有非现代历史时期。这一做法旨在将 LLM 对信息的理解与运用能力,同其推理过程分离开来单独检验。
时事任务 为了进一步分离 LLM 学习新知识的能力,我们构建了一个由时事多项选择题组成的任务。该任务的题目均涉及各模型训练数据截止之后发生的事件。具体来说,我们聚焦 2023 年 8 月至 11 月间美国的「时事」,这些事件均收录在相关的 Wikipedia 索引(https://en.wikipedia.org/wiki/Category:2023_events_in_the_United_States_by_month)中。这一方法使我们能够基本保证模型未曾接触过这些事实,从而可以直接检验其知识注入能力。
4.2 数据收集与预处理
为了有效评估 LLM 在这些知识密集型任务上的表现,我们按主题从 Wikipedia 抓取相关文章,收集了一套全面的辅助数据集。选择 Wikipedia 作为主要知识来源,理由在于其相关主题覆盖广泛,并且作为经大众验证的知识库颇具可靠性。我们通过定位每个主题对应的中枢页面,经官方 Wikipedia API(https://www.mediawiki.org/wiki/API:Main_page)检索了与任务相关的全部文章。
随后,我们采用严格的清洗流程,把数据从原始小节转换为干净的文本块。这一步借助 wikiextractor 工具(Attardi 2015)完成。将数据切分为干净的小文本块(例如去除 HTML、URL 等),旨在更好地评估 LLM 在各类知识领域的理解能力,并辅助 LLM 的微调过程。
4.3 时事任务构建
从 Wikipedia 收集到相关文本块之后,我们借助 GPT-4(OpenAI 2023)创建了一个新的多项选择题数据集。首先,我们移除了所有过小的文本块。对语料库中余下的每个文本块,我们指示 GPT-4 创建四个高度具体、高质量且只有一个正确答案的多项选择题。所谓「具体」,是指无需知晓题目所指的上下文即可作答,且歧义极小。接着,我们让 GPT-4 从四个题目中选出最具体的两个,随后再进行人工评估与校验。最终共得到 910 道新题。
4.4 改写生成
数据集创建完成后,我们利用 GPT-4 为数据集生成增强版本。我们指示 GPT-4 给出输入数据的改写版本:更换措辞,但完整保留原有信息。每轮改写都换用不同的随机种子,以确保多样性。
我们为每个任务随机选取了 240 个文本块,并为每个文本块创建了两个改写版本。这些改写被单独留出,用作超参数调优的验证集。对于时事数据集,我们为参与 6 节所述微调过程的每个文本块创建了十个改写版本。
5 实验与结果
实验框架 我们使用广受欢迎的 LM-Evaluation-Harness(Gao et al. 2021)代码库来评估 LLM 在所选知识密集型任务上的表现。LM-Evaluation-Harness 是一个稳健的评测工具,目前是模型评估的行业标准,也是 HuggingFace 排行榜(https://huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard)的基础。依托该平台确保了评估框架的标准化,使模型、方法和数据集之间的比较保持一致。更重要的是,采用行业标准的评估方式可以避免提示词工程与格式化问题带来的差异,并复现各模型已报告的基线结果。
模型选择 我们选择了三个模型用于推理评估:Llama2-7B(Touvron et al. 2023)、Mistral-7B(Jiang et al. 2023)和 Orca2-7B(Mitra et al. 2023)。选择这些模型,意在覆盖不同基线能力水平上最受欢迎的开源基础模型以及一个指令微调模型。此外,我们选择 bge-large-en(Xiao et al. 2023)作为 RAG 组件的嵌入模型,并使用 FAISS(Johnson et al. 2019)作为其向量存储。根据 HuggingFace MTEB 排行榜(https://huggingface.co/spaces/mteb/leaderboard),该嵌入模型目前是开源嵌入模型中的 SOTA。
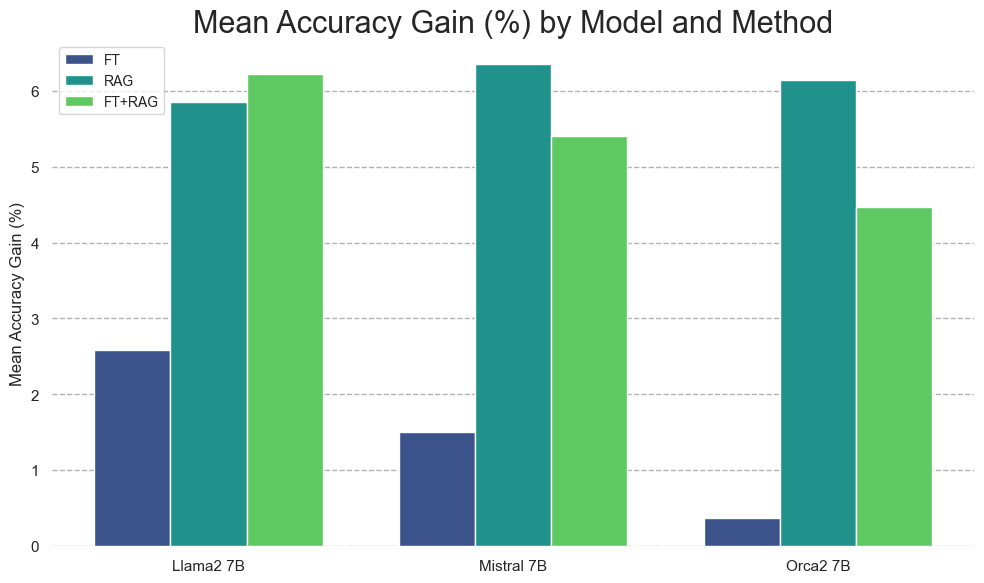
配置变体 我们的评估包含多种配置,并在这些配置上进行网格搜索,以实现更全面的基准评测。首先,我们比较了基线模型与微调模型,以及二者搭配 RAG 组件后的表现。其次,我们探索了 RAG 中应加入上下文的文本块数量的最优值。具体而言,我们采用
训练设置 我们使用 3.2 节所述的无监督训练流程训练所有模型。对每个数据集,我们依据原始文本块的长度对其进行拼接或切分,把辅助知识库划分为大小均为 <BOS> 和 <EOS>,用于界定原始文本块的首尾,以保留文档的结构。
各模型的训练学习率介于
评估方法 所有评估均按如下方式进行:把多项选择的每个选项依次拼接在题干之后,再将拼接结果送入模型,为每个选项得到一个对数概率分数。得分最高的选项被解读为模型的选择,并用于计算准确率。更形式化地,这表示在公式 1 中,当满足下式时,我们称
其中
MMLU 结果 对每个任务和每种模型,我们比较了四种方法:仅使用基础模型、RAG、FT,以及将 FT 与 RAG 结合——以微调后的模型作为生成器。此外,我们分别在 0-shot 与 5-shot 两种场景下测试了 MMLU 任务。完整结果见表 1。相对准确率提升(即
其中
在所有情形下,RAG 都显著优于相应的基础模型。此外,以基础模型为生成器使用 RAG,始终优于仅做微调。在某些情况下,在 RAG 流程中以微调模型替代基础模型作为生成器还能进一步提升效果;但这一提升并不稳定,反而印证了微调固有的不稳定性。另外,我们发现 5-shot 在多数情况下能小幅提升效果,且这一趋势在各类方法中普遍一致。
时事任务结果 时事任务的评估结果见表 2。由于问题与辅助数据集之间存在一一对应关系(见 4.3 节),RAG 显得尤为有效。微调无法与 RAG 抗衡;不过,基于多改写版本的微调相较基线仍有显著提升。我们还注意到,RAG 与微调结合的效果逊于单独使用 RAG。
值得注意的是,尽管题目所依据的信息是模型在训练中未曾接触的,基础模型的成绩仍超过了
微调 vs. RAG 在 MMLU 与时事两类任务的结果中,RAG 相对微调的优势都十分明显。虽然微调在多数情况下相较基础模型有所提升,但依然无法与 RAG 方法抗衡。
多种因素可能共同导致了这一现象。其一,RAG 不仅向模型注入知识,还会引入与问题相关的上下文,而这正是微调所欠缺的。其二,由于一定程度的灾难性遗忘,微调可能损害模型的其他能力。最后,无监督微调后的模型有望通过监督微调或基于 RL 的微调进一步对齐而获益,Orca2 相对基础 Llama2 的大幅性能提升即是明证。
6 重复的重要性
与其他任务(模型在预训练期间接触过与主题相关的内容)不同,时事任务包含新信息。在这种情况下,标准的常规微调不仅没有提升 Llama2 的表现,反而使其显著退化。为了改善微调结果,我们探索了用改写来增强数据。
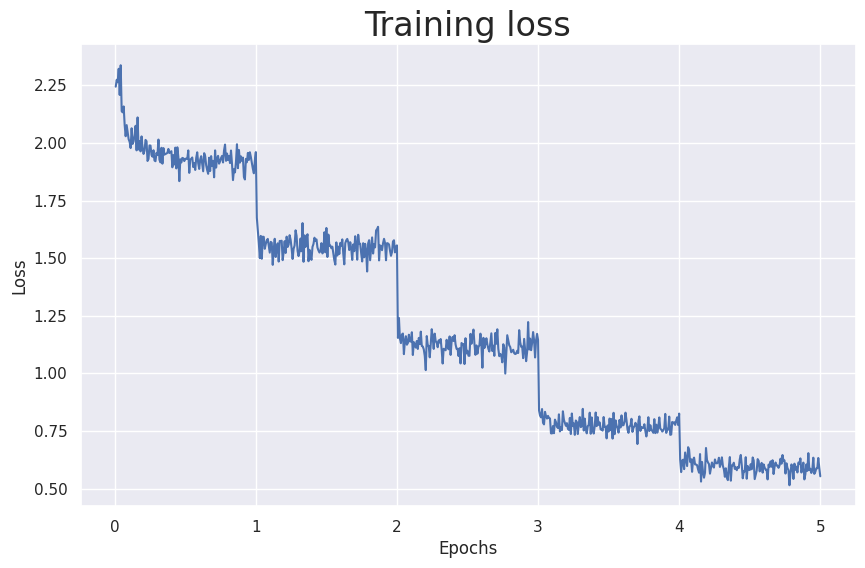
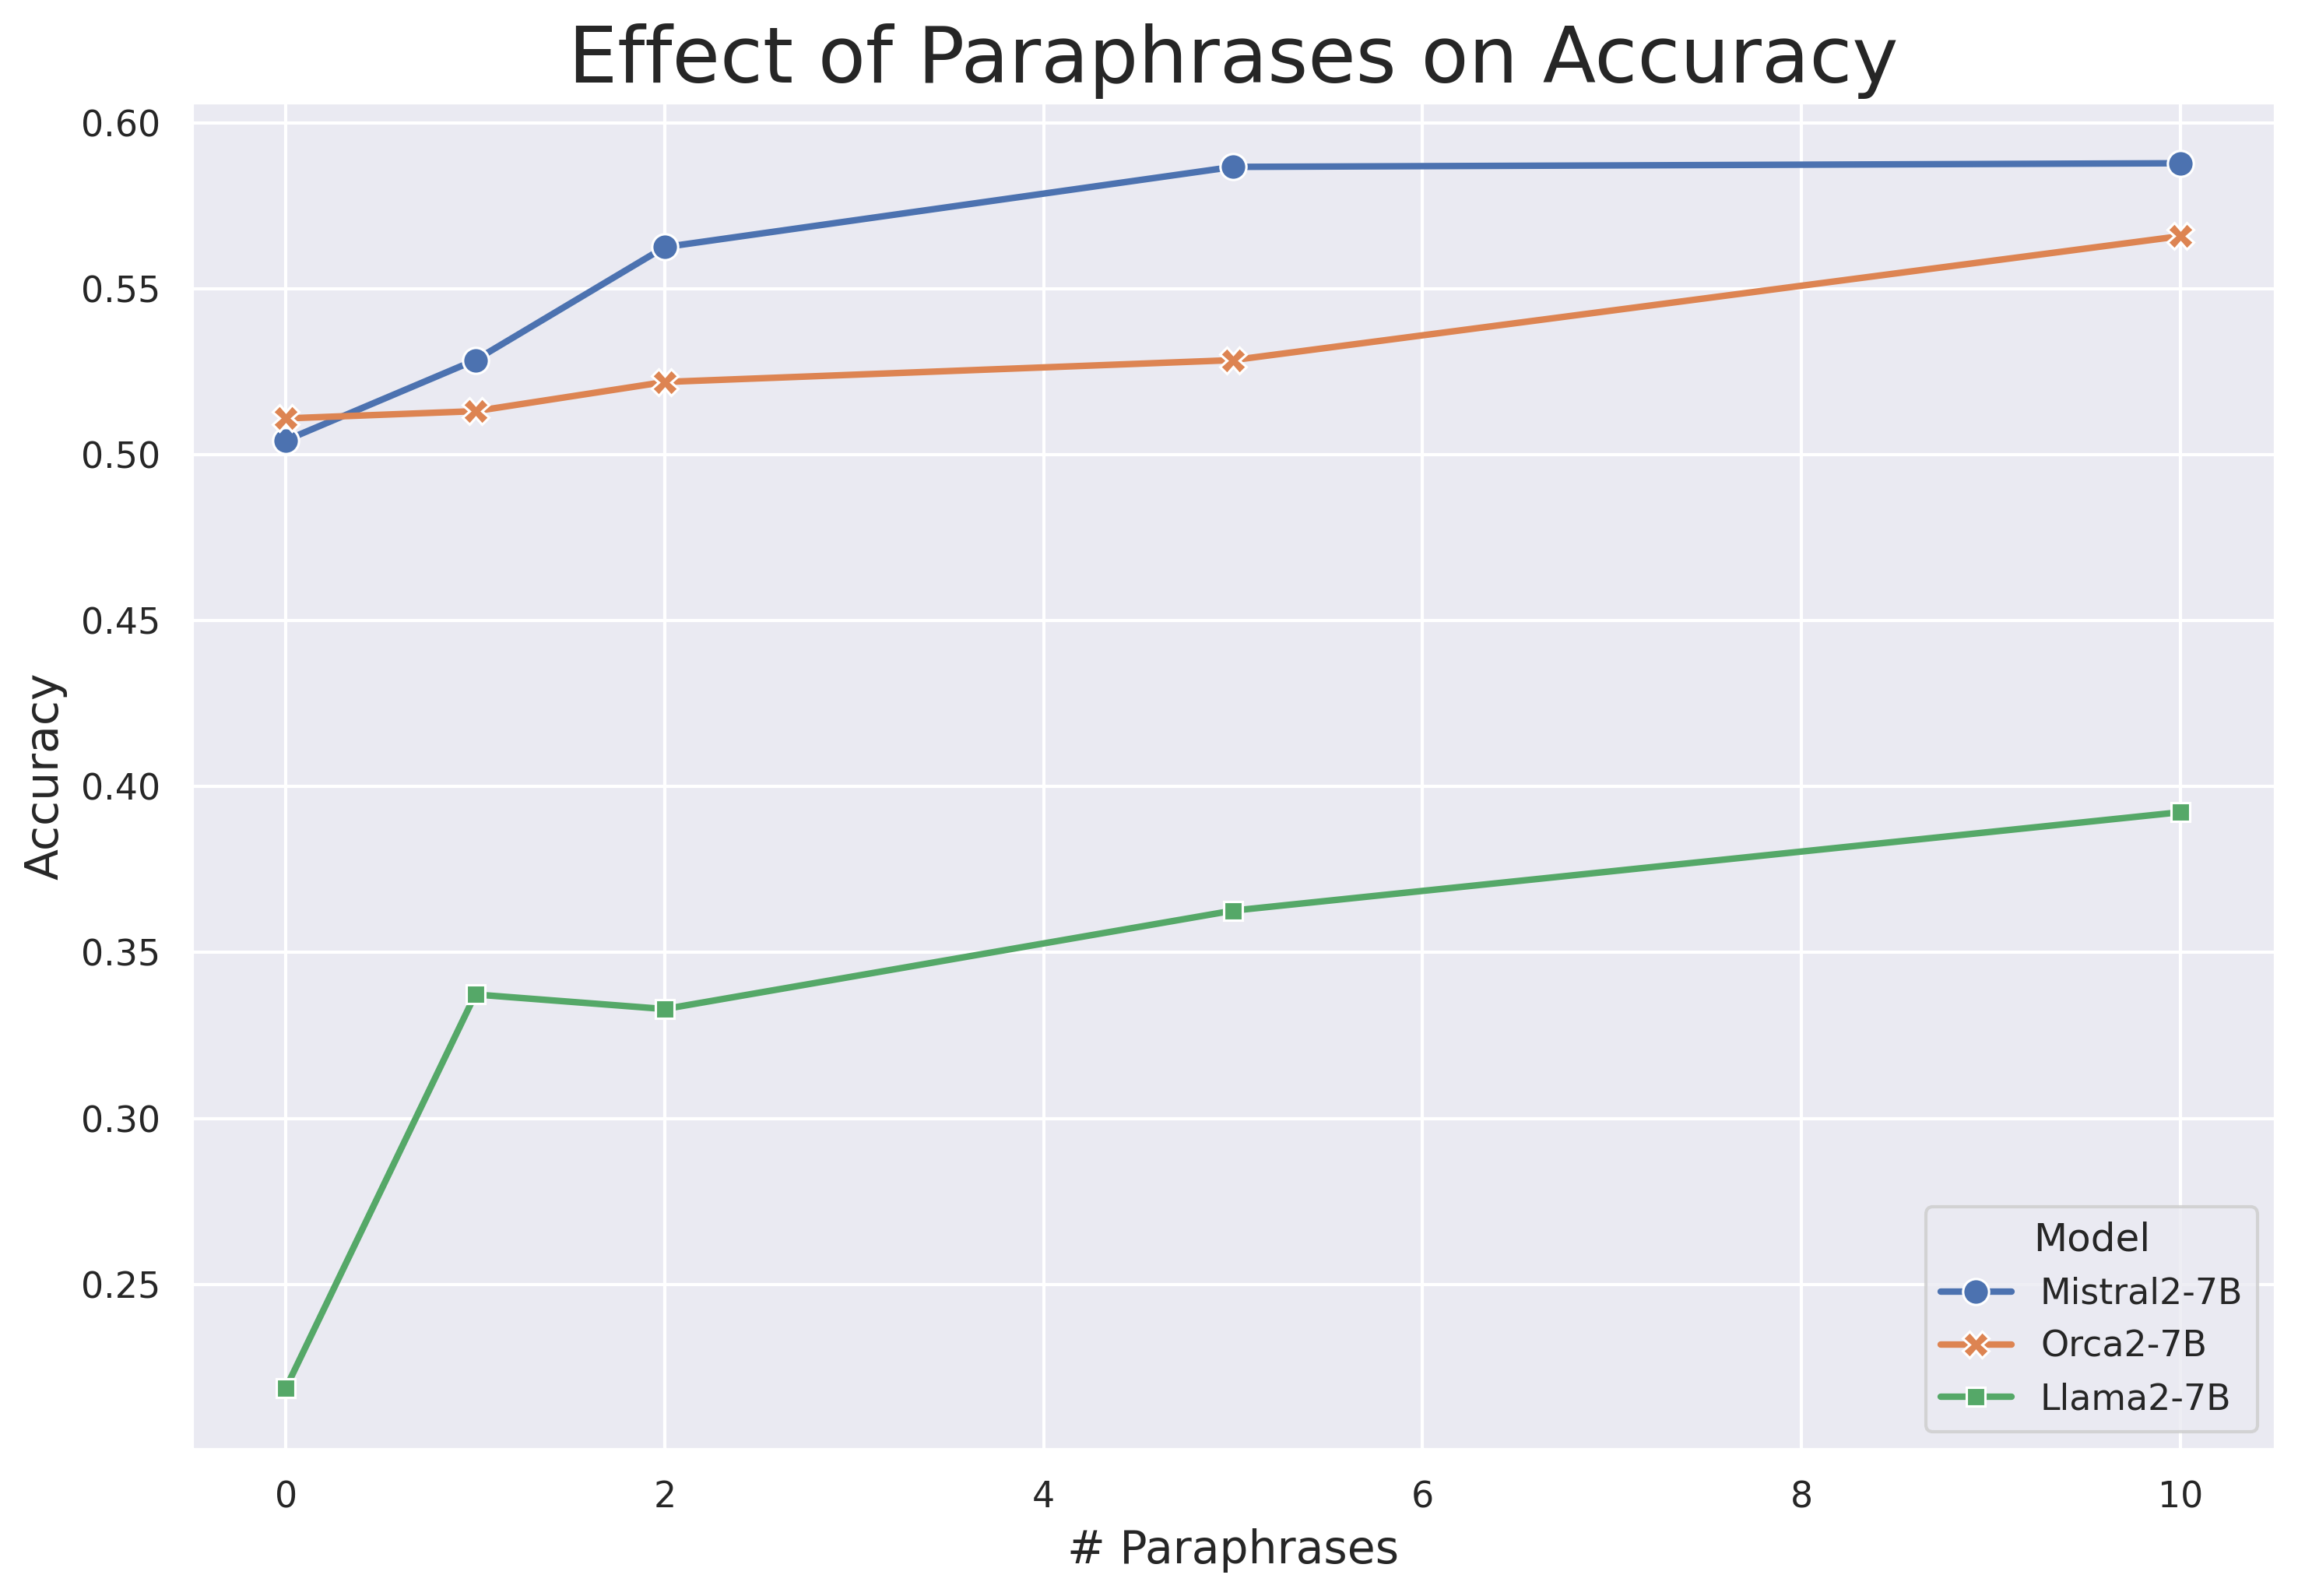
数据增强 数据增强是一种成熟的提升语言模型表现的方法,已有广泛的综述(Shorten et al. 2021)。过去也曾成功地利用生成式模型做增强来改进分类模型(Sharma et al. 2022)。使用改写进行数据增强的一个例子见附录 B。
单调提升 这一方法给我们的结果带来了显著改善,展示了所用改写数量与模型准确率之间的直接相关性。我们的实验揭示了一个引人注目的趋势,见图 4。对所有被测模型而言,准确率都是所用改写数量的单调递增函数。这一观察有力地表明,改写增强所带来的信息重复,对模型从有限数据中理解并泛化新知识的能力有积极影响。
学习新信息 在图 3 中,我们可以看到贯穿我们实验始终的一个有趣现象。每经过一个 epoch(即完成对整个数据集的又一轮迭代),训练损失都会显著下降。这与已知的 LLM 在训练期间记忆数据并过拟合的结论一致(Tirumala et al. 2022)。
我们的假设如下:
要教会预训练 LLM 新知识,这些知识必须以多种多样的方式反复呈现。
这一点在 LLM 预训练中已广为人知(Kandpal et al. 2023),而我们在此看到,它对微调同样成立。这一假设的理由是:仅仅记住句子并不意味着了解其内容,正如(Berglund et al. 2023)中已经表明的那样。通过以多种形式提供信息(如我们使用的数据增强流程),数据中的各种关系(例如
7 结论与未来工作
大型语言模型拥有关于各种主题的海量知识。在本工作中,我们测试了它们适应新知识的能力:既包括专业知识,也包括完全未见过的知识。这是该领域最早比较两种主流方法——微调与检索增强生成——的研究之一。我们发现,尽管微调对许多用例有其价值,但 RAG 是知识注入更可靠的选择。
本工作的某些方面仍需进一步研究。例如,我们以无监督训练作为主要的微调方法,而非指令微调或基于 RL 的方法。研究多种技术的组合、搭配多样的辅助知识库,可能会带来更好的结果。这一方向结合我们在第 6 节提出的假设,有望进一步加深我们对通过 FT 进行知识注入的理解。
虽然我们相信本工作加深了对 LLM 中知识的理解,但这个领域还有大量工作要做。具体来说,关于 LLM 中知识表示的问题还需要更多研究,尤其是从理论视角。
最后,还需要进一步努力来测量 LLM 中的知识。我们采用了如公式 2 所描述的经验性方法,但探索知识的其他定义与视角、并在本工作之上继续扩展,同样重要。
8 局限性
与所有机器学习应用一样,超参数的选择会显著影响结果。因此我们强烈建议针对具体场景优化所有相关超参数。
我们通过在三个不同模型上运行实验来支撑我们的结论。然而,向其他 LLM 的泛化应经过彻底检验。例如,GPT-4 在某些 MMLU 任务上已接近完美准确率(Nori et al. 2023),因此进一步提升并不适用。
最后,虽然我们为知识库选择了多种主题,但所有来源都出自 Wikipedia。其他数据集可能产生不同的结果,必须谨慎评估。
附录 A RAG 消融实验
如第 5 节所述,我们比较了
表 3:RAG 消融实验。
| 任务 | 模型 | 检索文档数( | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| Anatomy (0-shot) | Mistral 7B | 0.615 | 0.681 | 0.630 | 0.644 | 0.622 |
| Llama2 7B | 0.444 | 0.489 | 0.467 | 0.474 | 0.481 | |
| Orca2 7B | 0.607 | 0.637 | 0.600 | 0.585 | 0.637 | |
| Anatomy (5-shot) | Mistral 7B | 0.659 | 0.667 | 0.659 | 0.681 | 0.674 |
| Llama2 7B | 0.496 | 0.563 | 0.541 | 0.526 | 0.526 | |
| Orca2 7B | 0.630 | 0.659 | 0.600 | 0.600 | 0.600 | |
| Astronomy (0-shot) | Mistral 7B | 0.651 | 0.678 | 0.678 | 0.664 | 0.664 |
| Llama2 7B | 0.447 | 0.434 | 0.447 | 0.434 | 0.467 | |
| Orca2 7B | 0.711 | 0.730 | 0.730 | 0.750 | 0.730 | |
| Astronomy (5-shot) | Mistral 7B | 0.704 | 0.684 | 0.658 | 0.684 | 0.724 |
| Llama2 7B | 0.461 | 0.447 | 0.474 | 0.428 | 0.454 | |
| Orca2 7B | 0.730 | 0.737 | 0.750 | 0.743 | 0.763 | |
| Biology (0-shot) | Mistral 7B | 0.736 | 0.722 | 0.757 | 0.743 | 0.736 |
| Llama2 7B | 0.438 | 0.472 | 0.493 | 0.479 | 0.472 | |
| Orca2 7B | 0.639 | 0.618 | 0.639 | 0.625 | 0.639 | |
| Biology (5-shot) | Mistral 7B | 0.722 | 0.778 | 0.778 | 0.771 | 0.743 |
| Llama2 7B | 0.500 | 0.521 | 0.507 | 0.465 | 0.472 | |
| Orca2 7B | 0.625 | 0.639 | 0.625 | 0.660 | 0.660 | |
| Chemistry (0-shot) | Mistral 7B | 0.450 | 0.470 | 0.470 | 0.500 | 0.470 |
| Llama2 7B | 0.320 | 0.320 | 0.300 | 0.380 | 0.360 | |
| Orca2 7B | 0.370 | 0.420 | 0.400 | 0.410 | 0.440 | |
| Chemistry (5-shot) | Mistral 7B | 0.540 | 0.490 | 0.500 | 0.510 | 0.470 |
| Llama2 7B | 0.280 | 0.320 | 0.340 | 0.340 | 0.380 | |
| Orca2 7B | 0.390 | 0.430 | 0.400 | 0.430 | 0.470 | |
| Prehistory (0-shot) | Mistral 7B | 0.728 | 0.725 | 0.750 | 0.735 | 0.728 |
| Llama2 7B | 0.481 | 0.460 | 0.457 | 0.457 | 0.429 | |
| Orca2 7B | 0.648 | 0.645 | 0.660 | 0.670 | 0.679 | |
| Prehistory (5-shot) | Mistral 7B | 0.710 | 0.750 | 0.759 | 0.756 | 0.762 |
| Llama2 7B | 0.512 | 0.485 | 0.525 | 0.519 | 0.531 | |
| Orca2 7B | 0.660 | 0.688 | 0.685 | 0.698 | 0.688 |
附录 B 改写示例
下面是我们用来让 GPT-4 生成改写的提示词:
Your task is to paraphrase a text paragraph. The paragraph is given below.
Make sure to keep the same meaning but change the wording. Do not change any factual information.
Try to keep roughly the same length of the original text.
Give NUM_PARAPHRASES different paraphrases for each text.
These paraphrases should be as different from each other as possible.
Return a JSON formatted string with one key, called 'paraphrases', and a list of paraphrases.
Input paragraph:下面给出一些示例。第一组例子取自 Wikipedia 页面「51st International Emmy Awards」。
改写 I
The fifty-first edition of the International Emmy Awards Competition accepted submissions across all categories from December 7, 2022, until the closing date of February 16, 2023.
改写 II
The International Emmy Awards Competition, now in its 51st year, accepted submissions across all categories starting from December 7, 2022, until the deadline on February 16, 2023.
改写 III
The fifty-first edition of the International Emmy Awards Competition accepted submissions across all categories from December 7, 2022, until the closing date of February 16, 2023.
下一组例子取自 Wikipedia 页面「2023 Indianapolis mayoral election」。
改写 I
The mayoral election in Indianapolis took place on November 7, 2023, with preliminary elections occurring on May 2. The sitting mayor, Democrat Joe Hogsett, successfully ran for a third term. Both Hogsett and his Republican opponent, Jefferson Shreve, moved on to the main election.
改写 II
On November 7, 2023, citizens of Indianapolis cast their votes to elect their Mayor, following primary elections on May 2. Joe Hogsett, the Democrat already in office, won his bid for a third term. Hogsett and the Republican candidate, Jefferson Shreve, were the two contenders in the final electoral round.
改写 III
The mayoral election in Indianapolis took place on the 7th of November, 2023, following primary elections that occurred on the 2nd of May. Joe Hogsett, the incumbent Democrat, successfully ran for a third term. Both Hogsett and his Republican challenger, Jefferson Shreve, made it through to the final round of the election.
附录 C 时事任务中已有知识的示例
为了更好地说明模型如何能以高于随机的成功率回答关于新信息的问题,我们给出三种可能的场景作为示例。这些场景展示了推理能力更强的模型即便面对未见过的信息,也能推断出正确答案。第一种场景涉及关于前所未见信息的问题,基础推理能力使模型能够做出有根据的猜测。
问题:是什么关键议题导致了 2023 年美国汽车工人联合会(United Auto Workers)罢工?答案:
- 对食堂饭菜质量的不满。
- 关于员工着装规范的分歧。
- 对工资停滞和分级雇佣制度的不满。
- 关于工厂配色方案的争论。
在这种情况下,即使不了解这次罢工的具体情况,也容易猜到第三个选项最有可能。第二种场景涉及那些关于某主题的先验知识可能帮助模型作答的问题。
问题:由于 2023 年夏威夷野火,一些科学家提出了什么环境担忧?答案:
- 气温上升。
- 冰盖融化。
- 焦黑土壤径流汇入海岸线。
- 空气污染加剧。
在这个例子中,了解夏威夷的地理以及野火的直接影响,使模型能够给前两个选项赋予更低的可能性。这种排除过程提高了选中其余选项之一的概率(第三个选项是正确答案)。第三种场景源于自动出题过程:有些问题强烈依赖已有的知识。
问题:2021 年的哪一事件被拿来与 2023 年 9 月的纽约洪水相比较?答案:
- Hurricane Katrina。
- Hurricane Ida。
- Hurricane Sandy。
- Hurricane Harvey。
由于这些事件中只有一件发生在 2021 年(Hurricane Ida),且所有被测模型在预训练期间都接触过 2021 年的事件,因此这道题无需使用额外的时事信息就有可能答对。最后,为了说明为什么「模型一般无法以高于随机的成功率回答关于新信息的问题」这一假设是合理的,请看下面的例子:
问题:国家气象局(National Weather Service)气象学家 Matthew Belk 如何描述 2023 年 9 月美国东北部的洪水?答案:
- 50 年一遇事件。
- 100 年一遇事件。
- 200 年一遇事件。
- 500 年一遇事件。
即便对洪水及其统计特性有所了解,也很难猜到这位具体的气象学家会把这次洪水称为「200 年一遇事件」。如果模型没有接触过关于这次洪水细节的信息,就更是如此。
参考文献
- Attardi (2015) Attardi, G. Wikiextractor. https://github.com/attardi/wikiextractor, 2015.
- Berglund et al. (2023) Berglund, L., Tong, M., Kaufmann, M., Balesni, M., Stickland, A. C., Korbak, T., and Evans, O. The reversal curse: Llms trained on” a is b” fail to learn” b is a”. arXiv preprint arXiv:2309.12288, 2023.
- Chen et al. (2020) Chen, S., Hou, Y., Cui, Y., Che, W., Liu, T., and Yu, X. Recall and learn: Fine-tuning deep pretrained language models with less forgetting. arXiv preprint arXiv:2004.12651, 2020.
- Chen et al. (2022) Chen, X., Zhang, N., Xie, X., Deng, S., Yao, Y., Tan, C., Huang, F., Si, L., and Chen, H. Knowprompt: Knowledge-aware prompt-tuning with synergistic optimization for relation extraction. In Proceedings of the ACM Web conference 2022, pp. 2778–2788, 2022.
- Chen et al. (2021) Chen, Y., Zhong, R., Zha, S., Karypis, G., and He, H. Meta-learning via language model in-context tuning. arXiv preprint arXiv:2110.07814, 2021.
- Chia et al. (2023) Chia, Y. K., Hong, P., Bing, L., and Poria, S. Instructeval: Towards holistic evaluation of instruction-tuned large language models. arXiv preprint arXiv:2306.04757, 2023.
- Chung et al. (2022) Chung, H. W., Hou, L., Longpre, S., Zoph, B., Tay, Y., Fedus, W., Li, Y., Wang, X., Dehghani, M., Brahma, S., et al. Scaling instruction-finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
- Cohen et al. (2023) Cohen, R., Geva, M., Berant, J., and Globerson, A. Crawling the internal knowledge-base of language models. arXiv preprint arXiv:2301.12810, 2023.
- Dua et al. (2019) Dua, D., Wang, Y., Dasigi, P., Stanovsky, G., Singh, S., and Gardner, M. Drop: A reading comprehension benchmark requiring discrete reasoning over paragraphs. arXiv preprint arXiv:1903.00161, 2019.
- Gao et al. (2021) Gao, L., Tow, J., Biderman, S., Black, S., DiPofi, A., Foster, C., Golding, L., Hsu, J., McDonell, K., Muennighoff, N., Phang, J., Reynolds, L., Tang, E., Thite, A., Wang, B., Wang, K., and Zou, A. A framework for few-shot language model evaluation, September 2021. URL https://doi.org/10.5281/zenodo.5371628.
- Goodfellow et al. (2013) Goodfellow, I. J., Mirza, M., Xiao, D., Courville, A., and Bengio, Y. An empirical investigation of catastrophic forgetting in gradient-based neural networks. arXiv preprint arXiv:1312.6211, 2013.
- Hendrycks et al. (2021) Hendrycks, D., Burns, C., Basart, S., Zou, A., Mazeika, M., Song, D., and Steinhardt, J. Measuring massive multitask language understanding. Proceedings of the International Conference on Learning Representations (ICLR), 2021.
- Hu et al. (2023) Hu, L., Liu, Z., Zhao, Z., Hou, L., Nie, L., and Li, J. A survey of knowledge enhanced pre-trained language models. IEEE Transactions on Knowledge and Data Engineering, 2023.
- Huang et al. (2023) Huang, Q., Tao, M., An, Z., Zhang, C., Jiang, C., Chen, Z., Wu, Z., and Feng, Y. Lawyer llama technical report. arXiv preprint arXiv:2305.15062, 2023.
- Jiang et al. (2023) Jiang, A. Q., Sablayrolles, A., Mensch, A., Bamford, C., Chaplot, D. S., Casas, D. d. l., Bressand, F., Lengyel, G., Lample, G., Saulnier, L., et al. Mistral 7b. arXiv preprint arXiv:2310.06825, 2023.
- Johnson et al. (2019) Johnson, J., Douze, M., and Jégou, H. Billion-scale similarity search with GPUs. IEEE Transactions on Big Data, 7(3):535–547, 2019.
- Kandpal et al. (2023) Kandpal, N., Deng, H., Roberts, A., Wallace, E., and Raffel, C. Large language models struggle to learn long-tail knowledge. In International Conference on Machine Learning, pp. 15696–15707. PMLR, 2023.
- Kirkpatrick et al. (2017) Kirkpatrick, J., Pascanu, R., Rabinowitz, N., Veness, J., Desjardins, G., Rusu, A. A., Milan, K., Quan, J., Ramalho, T., Grabska-Barwinska, A., et al. Overcoming catastrophic forgetting in neural networks. Proceedings of the national academy of sciences, 114(13):3521–3526, 2017.
- Lampinen et al. (2022) Lampinen, A. K., Dasgupta, I., Chan, S. C., Matthewson, K., Tessler, M. H., Creswell, A., McClelland, J. L., Wang, J. X., and Hill, F. Can language models learn from explanations in context? arXiv preprint arXiv:2204.02329, 2022.
- Lauscher et al. (2020) Lauscher, A., Majewska, O., Ribeiro, L. F., Gurevych, I., Rozanov, N., and Glavaš, G. Common sense or world knowledge? investigating adapter-based knowledge injection into pretrained transformers. arXiv preprint arXiv:2005.11787, 2020.
- Lewis et al. (2020) Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., et al. Retrieval-augmented generation for knowledge-intensive nlp tasks. Advances in Neural Information Processing Systems, 33:9459–9474, 2020.
- Liu et al. (2020) Liu, W., Zhou, P., Zhao, Z., Wang, Z., Ju, Q., Deng, H., and Wang, P. K-bert: Enabling language representation with knowledge graph. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 34, pp. 2901–2908, 2020.
- Luo et al. (2023) Luo, Y., Yang, Z., Meng, F., Li, Y., Zhou, J., and Zhang, Y. An empirical study of catastrophic forgetting in large language models during continual fine-tuning. arXiv preprint arXiv:2308.08747, 2023.
- Min et al. (2021) Min, S., Lewis, M., Zettlemoyer, L., and Hajishirzi, H. Metaicl: Learning to learn in context. arXiv preprint arXiv:2110.15943, 2021.
- Mishra et al. (2021) Mishra, S., Khashabi, D., Baral, C., and Hajishirzi, H. Cross-task generalization via natural language crowdsourcing instructions. arXiv preprint arXiv:2104.08773, 2021.
- Mitra et al. (2023) Mitra, A., Del Corro, L., Mahajan, S., Codas, A., Simoes, C., Agrawal, S., Chen, X., Razdaibiedina, A., Jones, E., Aggarwal, K., et al. Orca 2: Teaching small language models how to reason. arXiv preprint arXiv:2311.11045, 2023.
- Neelakantan et al. (2022) Neelakantan, A., Xu, T., Puri, R., Radford, A., Han, J. M., Tworek, J., Yuan, Q., Tezak, N. A., Kim, J. W., Hallacy, C., Heidecke, J., Shyam, P., Power, B., Nekoul, T. E., Sastry, G., Krueger, G., Schnurr, D. P., Such, F. P., Hsu, K. S.-K., Thompson, M., Khan, T., Sherbakov, T., Jang, J., Welinder, P., and Weng, L. Text and code embeddings by contrastive pre-training. ArXiv, abs/2201.10005, 2022. URL https://api.semanticscholar.org/CorpusID:246275593.
- Nguyen (2023) Nguyen, H.-T. A brief report on lawgpt 1.0: A virtual legal assistant based on gpt-3. arXiv preprint arXiv:2302.05729, 2023.
- Nori et al. (2023) Nori, H., King, N., McKinney, S. M., Carignan, D., and Horvitz, E. Capabilities of gpt-4 on medical challenge problems. ArXiv, abs/2303.13375, 2023. URL https://api.semanticscholar.org/CorpusID:257687695.
- OpenAI (2023) OpenAI. Gpt-4 technical report. ArXiv, abs/2303.08774, 2023. URL https://api.semanticscholar.org/CorpusID:257532815.
- Ouyang et al. (2022) Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., Zhang, C., Agarwal, S., Slama, K., Ray, A., et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35:27730–27744, 2022.
- Petroni et al. (2019) Petroni, F., Rocktäschel, T., Lewis, P., Bakhtin, A., Wu, Y., Miller, A. H., and Riedel, S. Language models as knowledge bases? arXiv preprint arXiv:1909.01066, 2019.
- Radford et al. (2019) Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., Sutskever, I., et al. Language models are unsupervised multitask learners. OpenAI blog, 1(8):9, 2019.
- Rafailov et al. (2023) Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D., and Finn, C. Direct preference optimization: Your language model is secretly a reward model. arXiv preprint arXiv:2305.18290, 2023.
- Sakaguchi et al. (2021) Sakaguchi, K., Bras, R. L., Bhagavatula, C., and Choi, Y. Winogrande: An adversarial winograd schema challenge at scale. Communications of the ACM, 64(9):99–106, 2021.
- Schulman et al. (2017) Schulman, J., Wolski, F., Dhariwal, P., Radford, A., and Klimov, O. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017.
- Sharma et al. (2022) Sharma, S., Joshi, A., Mukhija, N., Zhao, Y., Bhathena, H., Singh, P., Santhanam, S., and Biswas, P. Systematic review of effect of data augmentation using paraphrasing on named entity recognition. In NeurIPS 2022 Workshop on Synthetic Data for Empowering ML Research, 2022. URL https://openreview.net/forum?id=rc2h1h89aDi.
- Shorten et al. (2021) Shorten, C., Khoshgoftaar, T. M., and Furht, B. Text data augmentation for deep learning. Journal of Big Data, 8, 2021. URL https://api.semanticscholar.org/CorpusID:236096559.
- Singhal et al. (2023a) Singhal, K., Azizi, S., Tu, T., Mahdavi, S. S., Wei, J., Chung, H. W., Scales, N., Tanwani, A., Cole-Lewis, H., Pfohl, S., et al. Large language models encode clinical knowledge. Nature, 620(7972):172–180, 2023a.
- Singhal et al. (2023b) Singhal, K., Tu, T., Gottweis, J., Sayres, R., Wulczyn, E., Hou, L., Clark, K., Pfohl, S., Cole-Lewis, H., Neal, D., et al. Towards expert-level medical question answering with large language models. arXiv preprint arXiv:2305.09617, 2023b.
- Srivastava et al. (2022) Srivastava, A., Rastogi, A., Rao, A., Shoeb, A. A. M., Abid, A., Fisch, A., Brown, A. R., Santoro, A., Gupta, A., Garriga-Alonso, A., et al. Beyond the imitation game: Quantifying and extrapolating the capabilities of language models. arXiv preprint arXiv:2206.04615, 2022.
- Tan et al. (2023) Tan, Y., Min, D., Li, Y., Li, W., Hu, N., Chen, Y., and Qi, G. Can chatgpt replace traditional kbqa models? an in-depth analysis of the question answering performance of the gpt llm family. In International Semantic Web Conference, pp. 348–367. Springer, 2023.
- Taori et al. (2023) Taori, R., Gulrajani, I., Zhang, T., Dubois, Y., Li, X., Guestrin, C., Liang, P., and Hashimoto, T. B. Alpaca: A strong, replicable instruction-following model. Stanford Center for Research on Foundation Models. https://crfm. stanford. edu/2023/03/13/alpaca. html, 3(6):7, 2023.
- Tirumala et al. (2022) Tirumala, K., Markosyan, A. H., Zettlemoyer, L., and Aghajanyan, A. Memorization without overfitting: Analyzing the training dynamics of large language models. ArXiv, abs/2205.10770, 2022. URL https://api.semanticscholar.org/CorpusID:248986465.
- Touvron et al. (2023) Touvron, H., Martin, L., Stone, K., Albert, P., Almahairi, A., Babaei, Y., Bashlykov, N., Batra, S., Bhargava, P., Bhosale, S., et al. Llama 2: Open foundation and fine-tuned chat models. arXiv preprint arXiv:2307.09288, 2023.
- Tunstall et al. (2023) Tunstall, L., Beeching, E., Lambert, N., Rajani, N., Rasul, K., Belkada, Y., Huang, S., von Werra, L., Fourrier, C., Habib, N., et al. Zephyr: Direct distillation of lm alignment. arXiv preprint arXiv:2310.16944, 2023.
- Wang et al. (2023) Wang, C., Liu, X., Yue, Y., Tang, X., Zhang, T., Jiayang, C., Yao, Y., Gao, W., Hu, X., Qi, Z., et al. Survey on factuality in large language models: Knowledge, retrieval and domain-specificity. arXiv preprint arXiv:2310.07521, 2023.
- Wang et al. (2020) Wang, R., Tang, D., Duan, N., Wei, Z., Huang, X., Cao, G., Jiang, D., Zhou, M., et al. K-adapter: Infusing knowledge into pre-trained models with adapters. arXiv preprint arXiv:2002.01808, 2020.
- Wang et al. (2022) Wang, Y., Mishra, S., Alipoormolabashi, P., Kordi, Y., Mirzaei, A., Arunkumar, A., Ashok, A., Dhanasekaran, A. S., Naik, A., Stap, D., et al. Super-naturalinstructions: Generalization via declarative instructions on 1600+ nlp tasks. arXiv preprint arXiv:2204.07705, 2022.
- Wu et al. (2023a) Wu, C., Zhang, X., Zhang, Y., Wang, Y., and Xie, W. Pmc-llama: Further finetuning llama on medical papers. arXiv preprint arXiv:2304.14454, 2023a.
- Wu et al. (2023b) Wu, S., Irsoy, O., Lu, S., Dabravolski, V., Dredze, M., Gehrmann, S., Kambadur, P., Rosenberg, D., and Mann, G. Bloomberggpt: A large language model for finance. arXiv preprint arXiv:2303.17564, 2023b.
- Xiao et al. (2023) Xiao, S., Liu, Z., Zhang, P., and Muennighoff, N. C-pack: Packaged resources to advance general chinese embedding, 2023.
- Yang et al. (2023) Yang, H., Liu, X.-Y., and Wang, C. D. Fingpt: Open-source financial large language models. arXiv preprint arXiv:2306.06031, 2023.
- Yu et al. (2022) Yu, W., Zhu, C., Li, Z., Hu, Z., Wang, Q., Ji, H., and Jiang, M. A survey of knowledge-enhanced text generation. ACM Computing Surveys, 54(11s):1–38, 2022.
- Zhou et al. (2023) Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., Ma, X., Efrat, A., Yu, P., Yu, L., et al. Lima: Less is more for alignment. arXiv preprint arXiv:2305.11206, 2023.